 SUN
来源:Bilibili - 7 分钟了解 10 种 RAG 策略
关联笔记:RAG 专题导航、RAG高级检索与优化、RAG评测与排障
标签:#AI #RAG #检索增强生成 #视频笔记
视频信息
| 项目 | 内容 |
|---|---|
| 标题 | 7 分钟了解 10 种 RAG 策略 |
| UP 主 | Hucci写代码 |
| 发布时间 | 2026-07-30 17:00(北京时间) |
| 时长 | 7 分 31 秒 |
| BV 号 | BV17J3B6PEGK |
| 视频简介 | 这个视频介绍了 10 种 RAG 策略 |
| 分 P / 字幕 | 单 P;播放器接口返回的官方字幕列表为空 |
| 整理方式 | B 站公开接口元数据 + 本地音频转写 + 视频画面逐段核对 + 一手资料校验 |
B 站公开接口没有返回字幕,因此下文不是逐字稿,而是根据音频转写和画面校正后的结构化笔记。技术名词以画面为准,时间点为约数。
一句话总结
视频中的“10 种策略”并不是十套互斥的 RAG 架构,而是分布在切块、表示与索引、Query 处理、检索排序和流程编排等不同环节的技术。它们可以组合使用;如果从零起步,视频建议先做 Hybrid Search + Rerank,再根据评测暴露的具体问题逐项加复杂度。
先看完整 RAG 流程
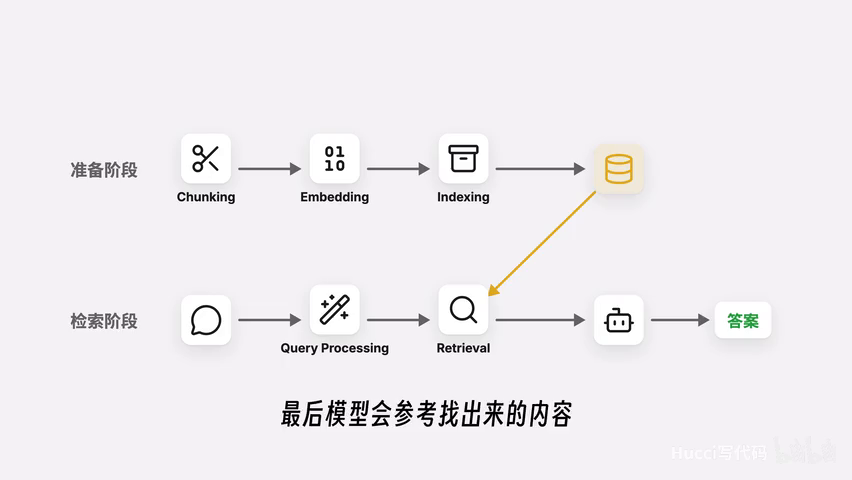
视频将流程分成两段:
离线准备:资料 → Chunking → Embedding → Indexing → 数据库

在线检索:用户问题 → Query Processing → Retrieval → 上下文 → LLM 回答
- Chunking:把原始资料切成可检索单元。
- Embedding:把 Query 和文本块映射成向量。
- Indexing:保存向量、原文及必要的元数据。
- Query Processing:把用户表达改造成更适合检索的 Query。
- Retrieval:召回候选块并排序。
- Generation:把检索证据交给 LLM 组织答案。
Indexing、向量数据库和 Metadata 是视频讲解 RAG 链路时的背景,不计入下面的十种策略。
时间轴
| 时间 | 内容 |
|---|---|
| 00:00 | 为什么有长上下文仍然需要 RAG:成本、延迟和有效上下文利用 |
| 01:10 | RAG 的离线准备与在线检索流程 |
| 01:51 | 固定长度切块及其问题 |
| 02:09 | 1. Semantic Chunking |
| 02:32 | 2. Proposition Chunking |
| 02:56 | 3. 领域适配 Embedding |
| 03:13 | Indexing、数据库和 Metadata(流程背景) |
| 03:48 | 4. Graph RAG |
| 04:35 | 5. Query Transformation |
| 04:43 | 6. HyDE |
| 05:29 | 7. Hybrid Search |
| 05:40 | 8. Rerank |
| 06:13 | 9. Agentic RAG |
| 06:48 | 10. Adaptive Routing |
| 07:05 | 选型建议:从 Hybrid Search + Rerank 起步 |
一、数据切块
1. Semantic Chunking:按语义边界切块
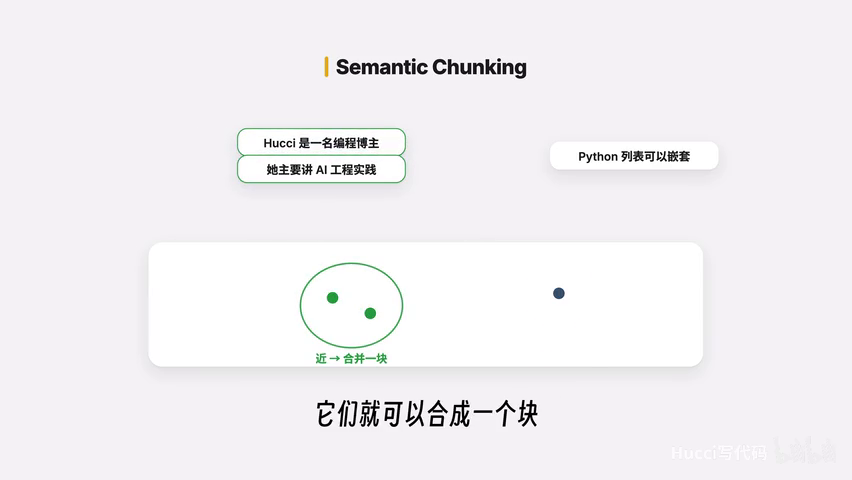
固定字数切分可能从句子或知识点中间截断,导致召回的块语义不完整。Semantic Chunking 的思路是:
- 对相邻句子或句群计算 Embedding。
- 比较相邻表示的语义距离。
- 语义接近就合并;距离突然变大时,把该位置当作切分点。
它适合段落边界不稳定、主题转换明显的长文档。LangChain 的 SemanticChunker 源码就是一种参考实现:先组合相邻句子,再计算 Embedding 的余弦距离并按阈值断开。
工程边界:
- 离线阶段要多做一轮句子级 Embedding,索引速度和成本高于固定长度切分。
- “语义完整”不等于“适合回答问题”,阈值、最小块和最大块仍要用自己的 Query 集调优。
- 表格、代码、标题层级和列表更适合先按结构解析,不能只依赖语义距离。
2. Proposition Chunking:拆成原子事实
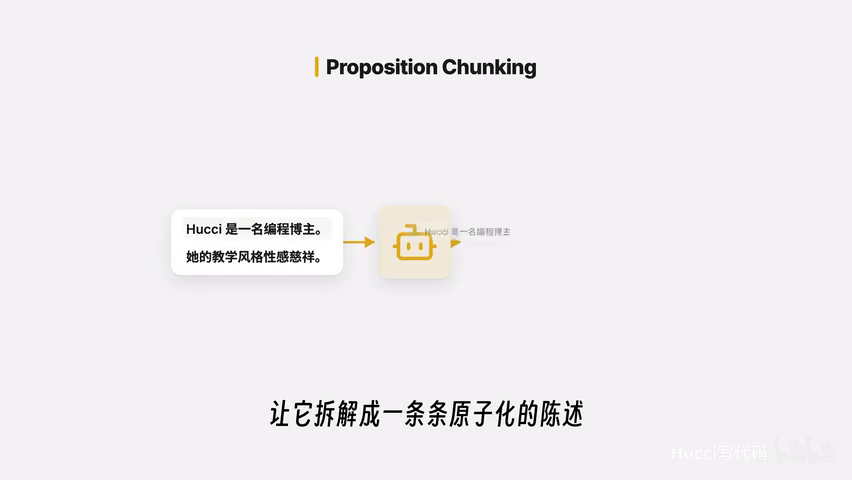
Semantic Chunking 仍可能把多个事实留在一个块中。Proposition Chunking 先粗切原文,再让 LLM 把内容拆成一条条简洁、自包含的原子命题,并把命题作为检索单元。
原始论文 Dense X Retrieval 将 proposition 定义为承载单一事实、简洁且可独立理解的表达;论文实验表明,在其测试任务和计算预算下,命题粒度优于 passage 粒度。这个结论不能直接外推到所有业务语料。
适合:事实型问答、实体属性密集的文档,以及“一个段落包含多个独立事实”的场景。
代价与风险:
- 建库时增加 LLM 调用,成本和处理时间更高。
- 拆解模型可能漏掉限定词、否定、时间范围或事实之间的依赖。
- 原子命题有利于精准召回,但可能丢失叙事顺序和跨句上下文;应保留命题到原文块的映射,生成时可回溯原文。
二、表示与索引
3. 领域适配 Embedding:别只看通用榜单
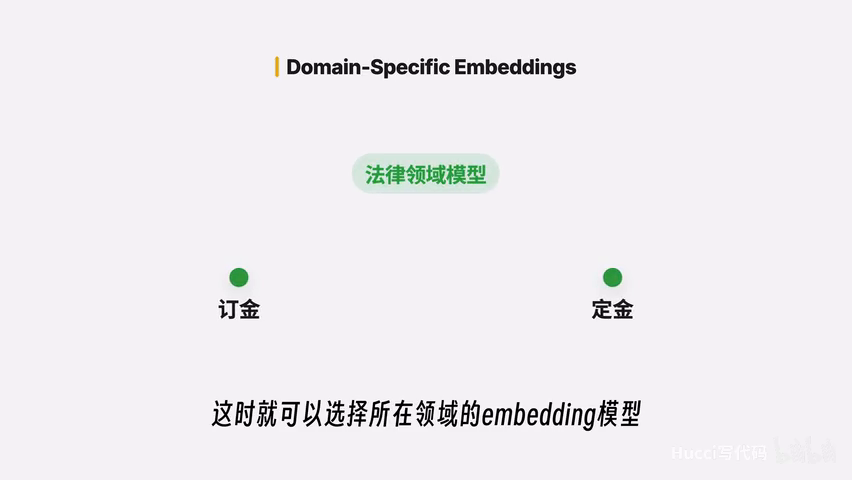
视频先列举通用 Embedding,再强调法律、代码、医疗等专业语料可能需要领域适配模型。通用模型把日常语义映射得很好,不代表它能稳定区分领域术语、缩写和近义专名。
- OpenAI 当前提供
text-embedding-3-small和text-embedding-3-large,后者定位为英语及非英语任务上能力更强的通用模型,参见 OpenAI Embeddings 文档。 - 视频还列举了 BGE、Qwen3-Embedding 等模型;BGE-M3 论文覆盖多语言、多粒度和多种检索表示,Qwen3-Embedding 官方仓库则同时提供 Embedding 与 Reranker 系列。
真正的选型依据应是自己的标注 Query—Document 集:至少比较 Recall@K、MRR/nDCG、延迟、吞吐、向量维度和成本。换 Embedding 往往意味着重新生成并迁移索引,不能只凭模型名决定。
索引与 Metadata:不是第 4 种策略,但非常重要
视频在这里补充了两个工程点:
- 小规模项目可以使用 SQLite 加向量扩展;更大的既有业务也可以在 PostgreSQL 上使用 pgvector。向量库不是越专用越好,应按数据量、过滤、更新、备份和运维能力选。
- 除向量和原文外,还应保存日期、类型、来源、版本、权限等 Metadata,检索时先做过滤,避免把已过期或无权访问的内容送给模型。
4. Graph RAG:显式保存实体关系
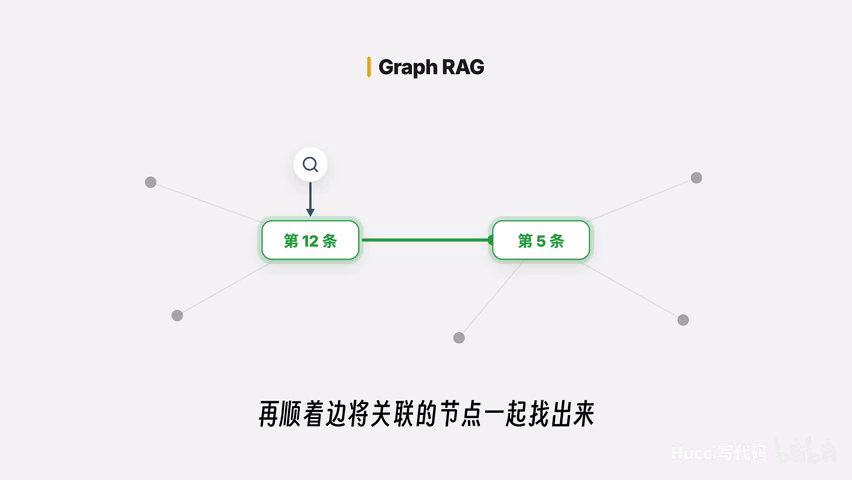
普通向量检索把 Chunk 当作相互独立的单元,跨块关系容易丢失。Graph RAG 从文本中抽取实体、关系和关键主张,构建图结构;查询时先定位相关实体,再沿边扩展相邻信息。
适合:
- 合同条款引用、组织关系、人物—事件关系等强关系语料。
- 需要跨多个片段“连接线索”的多跳问题。
- 需要对整个语料做主题归纳的全局问题。
微软的 GraphRAG 官方文档说明,其标准流程包含实体/关系抽取、社区层级和社区摘要;Local Search 面向具体实体,Global Search 面向语料的整体理解。
工程边界:图抽取、社区构建与摘要会显著增加离线成本,实体消歧和关系质量还需要专项评测。视频说文档更新后可能要重建整张图,这反映了图索引更新的复杂性,但不能当成当前实现的绝对限制:微软 GraphRAG 现已提供 graphrag update 和 *-update 增量索引模式,是否全量重算取决于实现、配置和变更范围。
三、Query 处理
5. Query Transformation:先把问题变得可检索
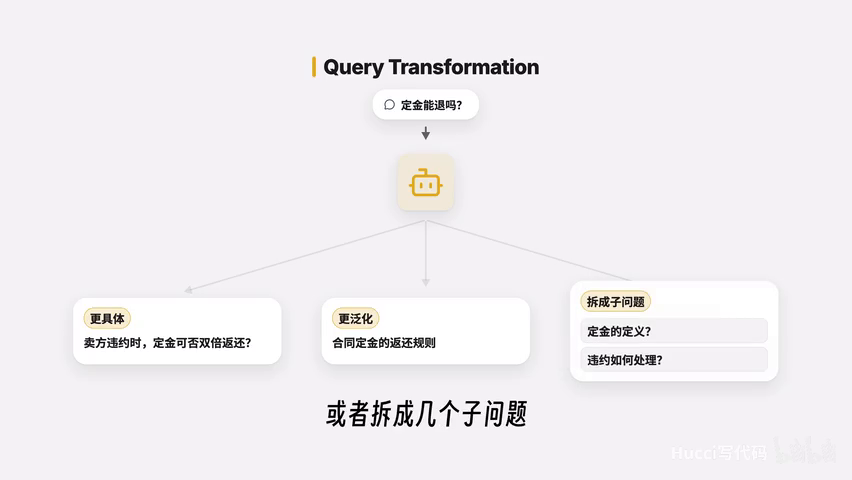
用户问题可能口语化、含代词、范围模糊或一次包含多个子问题。Query Transformation 可以让 LLM:
- Rewrite:改写成独立、明确的检索句。
- Expand:补充同义词、专业术语或别名。
- Decompose:把复杂问题拆成多个子查询。
- Step-back:先抽象出更高层问题,再检索背景知识。
微软 RAG 检索阶段指南把 augmentation、decomposition、rewriting 和 HyDE 都归到 Query Translation。工程上应始终保留原 Query 作为召回兜底,并监控改写后的语义漂移、额外延迟和 Token 成本。
6. HyDE:用“假设文档”寻找真实文档
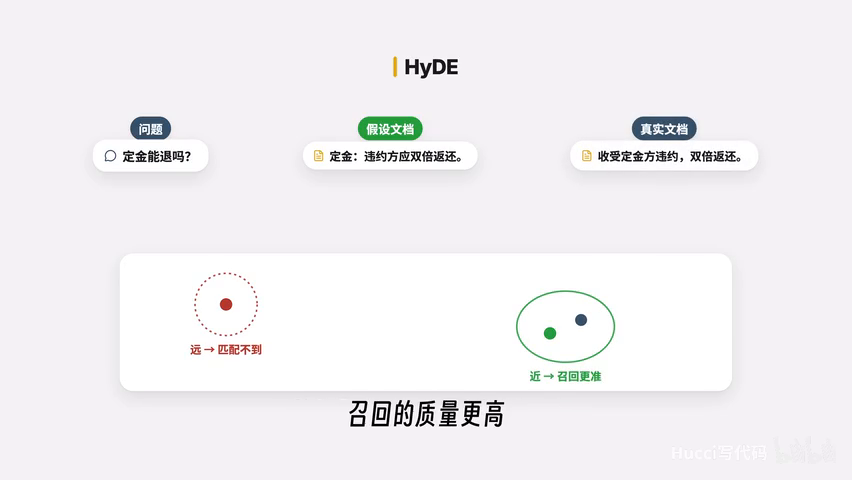
HyDE(Hypothetical Document Embeddings)不是先寻找答案,而是:
用户问题 → LLM 生成一篇假设答案文档 → 对假设文档做 Embedding
        → 在真实语料中检索向量邻居 → 只用真实文档回答
它利用“答案形态的文本往往比短 Query 更接近真实答案文档”这一点来改善零样本 Dense Retrieval。HyDE 原论文明确指出,假设文档是虚构的并可能包含错误细节;它只应充当检索探针,不能作为最终答案的证据。
适合:原 Query 太短、口语与专业语料之间存在明显表达鸿沟。风险是生成内容可能把检索引向错误方向,因此要与原 Query 并行召回,并在自己的评测集上比较增益。
四、召回与排序
7. Hybrid Search:语义检索和关键词检索并行
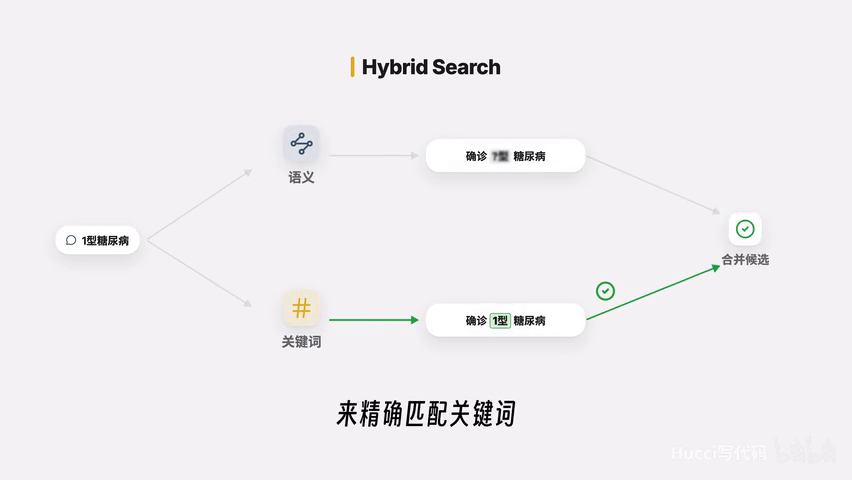
Dense Vector Search 擅长找语义相近的内容,但产品型号、错误码、人名、日期和专业缩写更依赖精确词面命中。Hybrid Search 同时运行:
- 向量检索:解决“表达不同但意思相近”。
- BM25 等全文检索:解决“关键词、专名、编号必须精确匹配”。
- 结果融合:常用 Reciprocal Rank Fusion(RRF)合并两个排序列表。
Azure AI Search 官方文档说明,Hybrid Search 会并行执行全文和向量查询,再用 RRF 合并结果。它是很合适的通用起点,但具体的 k、过滤条件、融合权重仍需评测。
8. Rerank:对候选集做精排
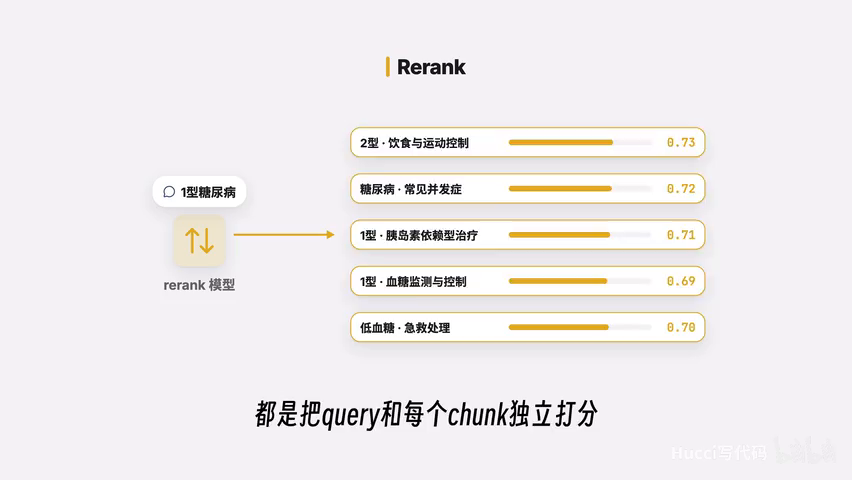
第一阶段检索主要追求高召回,拿到较宽的候选集;Reranker 再把 Query + 候选 Chunk 放在一起打分,筛出最相关的少量证据。Cross-Encoder 能建模 Query 与 Chunk 的词级交互,通常比独立编码后计算向量相似度更精细。
Hybrid Search 召回 Top 20~50
              ↓
       Cross-Encoder Rerank
              ↓
         取 Top 5~10 给 LLM
微软 RAG 检索指南指出,Rerank 优化的是候选集精度,但会增加额外延迟;Cross-Encoder 适合在已缩小的候选集上运行,而不是扫描整个语料库。
关键边界:Reranker 只能重新排列已有候选。如果正确文档根本没有进入初召回,Rerank 无法“救回”它。因此要同时看 Recall@K 和排序指标,不能只看最终回答。
五、流程编排
9. Agentic RAG:用循环代替固定 Pipeline
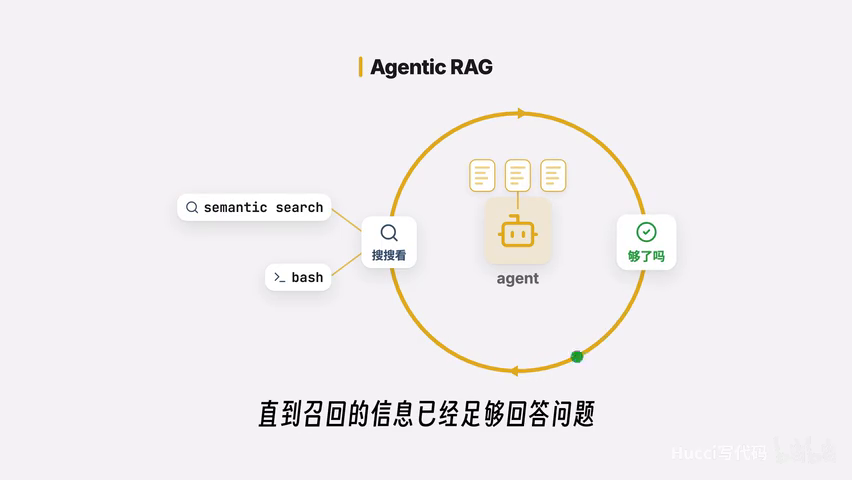
固定 RAG 通常只检索一次;Agentic RAG 让 Agent 自己判断:
- 当前证据是否足够。
- 应该改写 Query、换数据源还是继续检索。
- 是否需要调用 Semantic Search、Keyword Search、数据库或其他工具。
- 什么时候停止搜索并组织答案。
也就是从:
一次性 Pipeline:检索 → 生成
变为:
Loop:规划 → 检索/工具 → 评估证据 → 不足则继续 → 生成
LangChain 官方文档把 Agentic RAG 定义为由 LLM Agent 在推理中决定何时以及如何检索。它更灵活,但控制性更低、延迟可变;工程上还要处理最大轮数、停止条件、工具失败、重复检索、引用追踪和 Trace,不能把“交给 Agent”理解成自动获得可靠性。
10. Adaptive Routing:简单问题走短路,复杂问题再升级
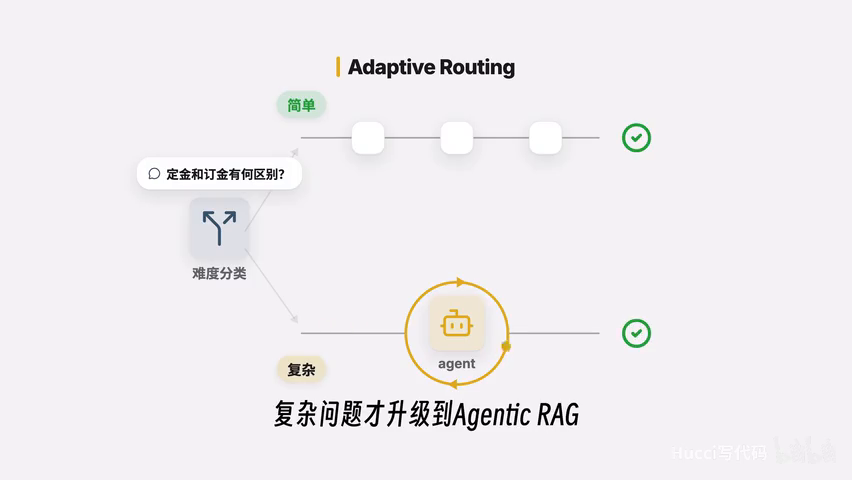
所有问题都走 Agentic RAG 会放大成本和延迟。Adaptive Routing 先用轻量分类器判断 Query 复杂度,再选择路径:
无需外部知识 → 直接回答或拒答
简单事实问题 → 单次 Hybrid Search + Rerank
复杂、多跳问题 → Agentic RAG,多轮检索
Adaptive-RAG 原论文用分类器按问题复杂度在无检索、单步检索和迭代检索之间选择。落地难点不在画一个路由框,而在于:如何标注复杂度、误路由如何兜底、路由阈值如何随成本和质量目标调整。
十种策略对照表
| # | 策略 | 所在环节 | 主要解决什么问题 | 新增代价 | 适用信号 |
|---|---|---|---|---|---|
| 1 | Semantic Chunking | 切块 | 固定长度切断语义 | 句子级 Embedding、阈值调优 | 段落主题切换明显 |
| 2 | Proposition Chunking | 切块 | 一个块混有多个事实 | 离线 LLM 拆解、上下文丢失风险 | 事实型问答、属性密集 |
| 3 | 领域适配 Embedding | 表示 | 通用向量不懂专业术语 | 模型评测与重建索引 | 法律、医疗、代码、内部缩写 |
| 4 | Graph RAG | 索引/检索 | 跨块关系和全局归纳 | 图抽取、消歧、社区摘要与更新 | 强关系、多跳、全局主题 |
| 5 | Query Transformation | Query | 口语、歧义、复合问题难检索 | 在线 LLM 调用、语义漂移 | 代词、短问句、多约束 |
| 6 | HyDE | Query | 问句与答案文档表达差异大 | 在线生成、错误方向风险 | 零样本、表达鸿沟明显 |
| 7 | Hybrid Search | 召回 | 向量检索漏掉关键词和编号 | 多路检索与融合 | 专名、错误码与语义问法混合 |
| 8 | Rerank | 排序 | 初召回候选噪声多 | 二阶段模型延迟 | Recall 尚可、Top 排名不准 |
| 9 | Agentic RAG | 编排 | 一次检索不足、需要多源探索 | 多轮 LLM/工具调用、控制复杂 | 多跳、开放研究型任务 |
| 10 | Adaptive Routing | 编排 | 所有请求都走重流程太贵 | 路由器、误路由与双链路维护 | Query 难度差异明显 |
推荐的落地顺序
视频给出的结论是:刚开始做 RAG,优先使用 Hybrid Search + Rerank。更完整的工程顺序可以整理为:
- 建立固定、可复现的评测集,标注 Query、相关 Chunk 和关键答案事实。
- 先完成结构化切块、Metadata、Dense + BM25 的 Hybrid Search。
- 扩大初召回候选,再用 Reranker 压到较小的上下文集合。
- 分开观察 Recall@K、MRR/nDCG、Faithfulness、端到端正确率、P95 延迟和单次成本。
- 只针对 Badcase 加策略:
- 语义被切断:Semantic Chunking。
- 单块事实过多:Proposition Chunking。
- 领域术语不准:领域 Embedding 或微调检索器。
- Query 表达差:Transformation 或 HyDE。
- 跨块关系问题:Graph RAG。
- 多轮、多源探索:Agentic RAG。
- 请求难度分化且成本过高:Adaptive Routing。
核心原则:先证明问题在哪一层,再增加那一层的复杂度。 十种方法不是越多越好,也不是全部叠上去就会更准。
核验与补充
1. 长上下文并没有让 RAG 自动过时
长上下文可以省去部分检索流程,但“能放进去”不代表模型能同等利用每个位置的信息。Lost in the Middle在其测试模型和任务上观察到:相关信息位于长上下文中间时,性能可能下降。这个结果不能直接外推到所有新模型,但足以说明需要实测有效上下文利用,而不是只看标称窗口。
因此长上下文、RAG 和全文搜索应按数据规模、更新频率、成本、延迟、权限和问题类型选,不是非此即彼。
2. GraphRAG 的“全量重建”不是当前实现的绝对规则
视频强调图更新比普通向量索引复杂,这一点成立;但截至本笔记整理时,微软 GraphRAG 已提供增量更新命令。因此应保留“更新成本高”的提醒,不能写成“文档一变必然全量重建”。
3. HyDE 生成的内容不是事实来源
HyDE 论文从一开始就允许假设文档包含虚构细节。它的用途是改善检索位置,最终回答必须回到真实语料,并验证引用是否支持结论。
4. 视频没有给出统一收益数字
视频对成本、延迟和质量的讨论是架构层面的定性说明,没有给出统一数据集、对照实验或可复现指标。因此不能从视频推出“某策略必然提升多少准确率”或“Hybrid + Rerank 在所有项目中最优”。
复习口诀
先切好:Semantic / Proposition
再表准:领域 Embedding / Graph RAG
问得对:Query Transformation / HyDE
找得全:Hybrid Search
排得准:Rerank
复杂才循环:Agentic RAG
按难度分流:Adaptive Routing
一手资料
- RAG 原始论文:Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
- LangChain SemanticChunker 源码
- Dense X Retrieval:Proposition 检索粒度
- OpenAI Embeddings 文档
- BGE-M3 论文
- Qwen3-Embedding 官方仓库
- Microsoft GraphRAG 文档
- 微软 RAG 信息检索阶段指南
- HyDE 原论文
- Azure AI Search:Hybrid Search
- LangChain:Agentic RAG
- Adaptive-RAG 原论文
- Lost in the Middle
相关笔记
- RAG高级检索与优化 — Query 改写、HyDE、多跳检索和 Agentic RAG
- RAG工程全流程 — 这些策略在完整离线/在线链路中的位置
- RAG评测与排障 — 用 Recall、排序、Faithfulness 和系统指标定位问题
- RAG准确率优化-从60到85 — 一个组合优化案例
- RAG 专题导航