 SUN
来源:Bilibili - 面试官问:RAG准确率怎么从60%提高到85%?
标签:#AI #RAG #面试 #检索增强生成
视频信息
| 项目 | 内容 |
|---|---|
| 标题 | 面试官问:RAG准确率怎么从60%提高到85%? |
| UP 主 | Agent搭建教程 |
| 时长 | 约 5 分 47 秒 |
| 发布时间 | 2026-06-14 14:00 |
| BV 号 | BV18DJn6tE38 |
| 整理方式 | B 站公开接口元数据 + 音频转写 + 关键帧文字整理 |
一句话总结
RAG 从 Demo 到线上准确率下降,通常不是单纯换大模型就能解决,而是要按链路拆:文档分块、Query 预处理、混合检索与重排序、指标监控。视频给出的核心思路是:先提升检索到正确上下文的概率,再保证模型生成不脱离上下文。
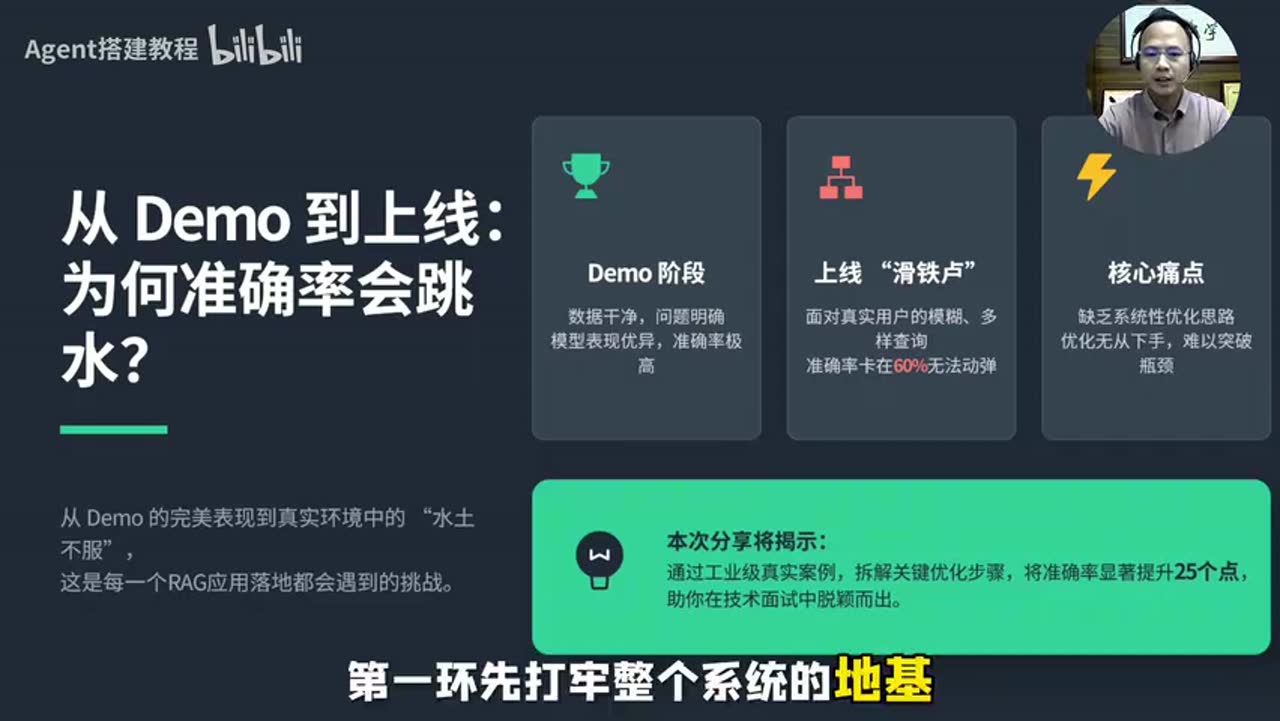
1. 问题背景:为什么 Demo 准、上线不准
很多 RAG 系统在本地 Demo 中表现很好,但接入真实用户流量后,准确率可能卡在 60% 左右。原因通常不是某一个参数没调好,而是线上问题更复杂:
- 用户问题更短、更口语、更模糊。
- 文档结构更复杂,固定切分容易切断完整语义。
- 单一路检索无法同时兼顾语义匹配和关键词精确匹配。
- 只看总准确率,无法判断问题出在检索还是生成。
面试中回答这个问题,要体现自己能从完整工程链路定位问题,而不是只会说“换模型、调 prompt、加向量库”。
2. 第一环:数据处理优化,也就是文档分块
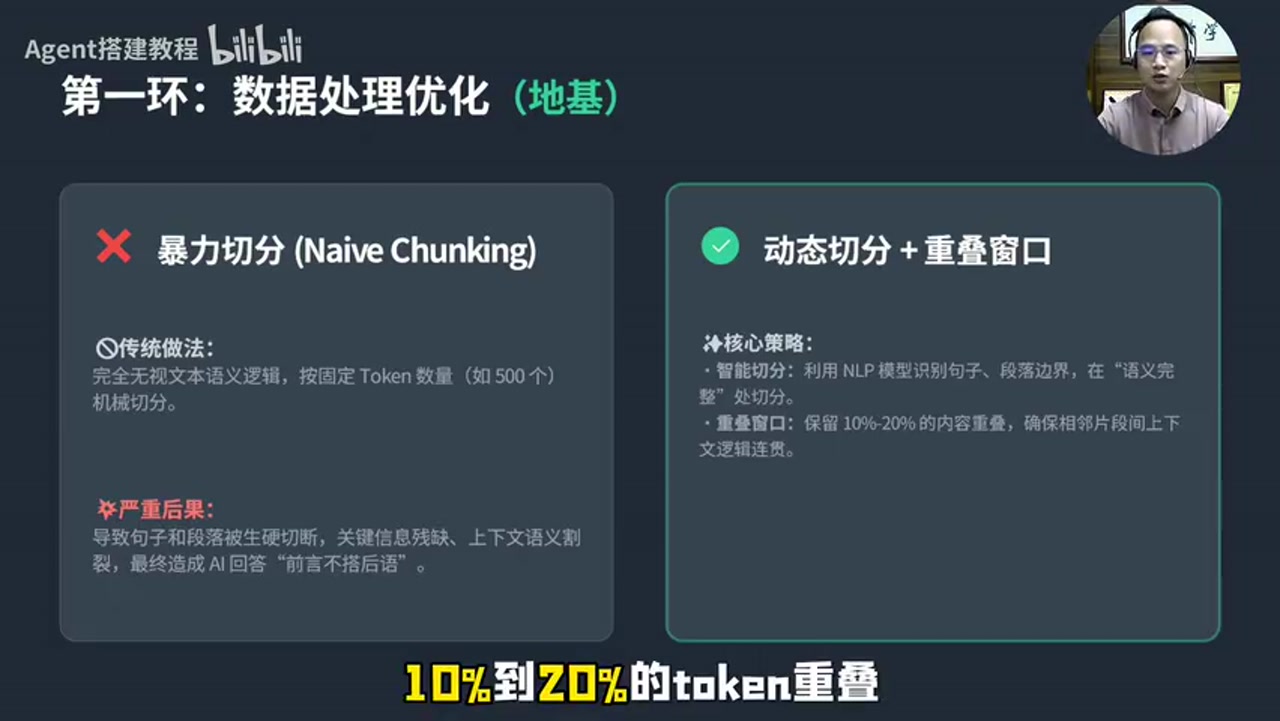
不推荐:暴力固定切分
常见错误是按固定 token 数直接切分,比如每 500 token 切一段。这种 Naive Chunking 实现简单,但线上容易出问题:
- 一个完整知识点可能被切成两半。
- 表格、列表、标题层级、因果推理链可能被破坏。
- 检索召回的是残缺片段,大模型拿不到完整上下文。
结果就是:即使向量检索“看起来”命中了相关片段,生成阶段仍然缺少关键条件,回答就会偏。
推荐:动态语义切分 + 上下文重叠窗口
工业级做法不是死板地按长度截断,而是结合文档结构和语义边界:
- 使用分句模型、段落识别、标题层级和文档结构解析来确定切分点。
- 尽量保持一个段落、一个知识点、一张结构化表格的完整性。
- 相邻 chunk 保留 10% 到 20% 的 token overlap,用于承接上下文。
视频里强调,这一步往往是性价比最高的优化;在固定 token 切分的基线上,不动大模型本身,也可能明显提升准确率。
3. 第二环:Query 预处理优化,防止短问题和歧义带偏检索
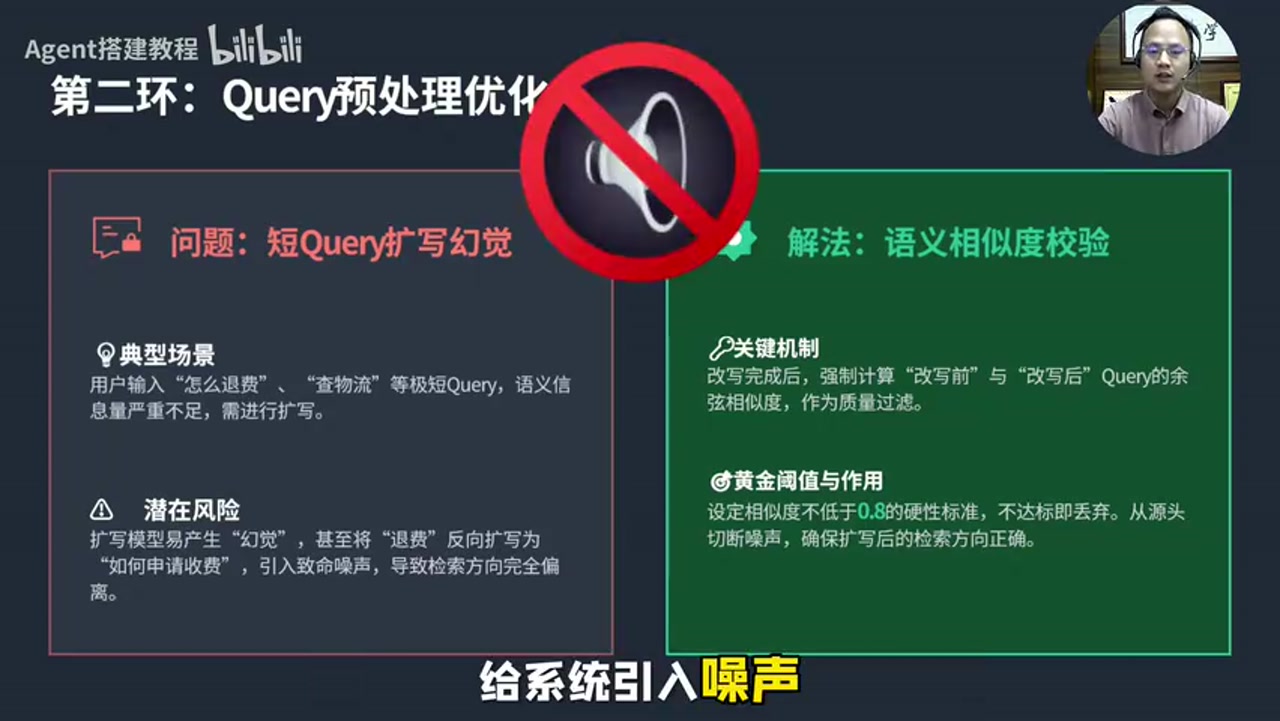
真实用户不会总是输入完整问题,经常只写几个字,例如:
- “怎么退费”
- “开票规则”
- “报销流程”
这类短 Query 语义不足,直接检索容易漏召回。常规做法是用小模型做 Query Rewrite 或 Query Expansion,生成多个同义问法再检索。
但这里有一个关键风险:改写模型可能引入语义漂移。例如把“怎么退费”改成“怎么收费”,检索方向就完全错了。
推荐做法:改写后做语义相似度校验
对所有改写后的 Query,用 embedding 模型计算它与原 Query 的语义相似度:
- 相似度高于阈值,例如 0.8:保留,用于扩展检索。
- 相似度低于阈值:认为偏离原意,丢弃。
这一步的作用是给 Query Rewrite 加一道兜底,避免系统自己制造噪声。
4. 第三环:混合检索优化,不要简单相加分数
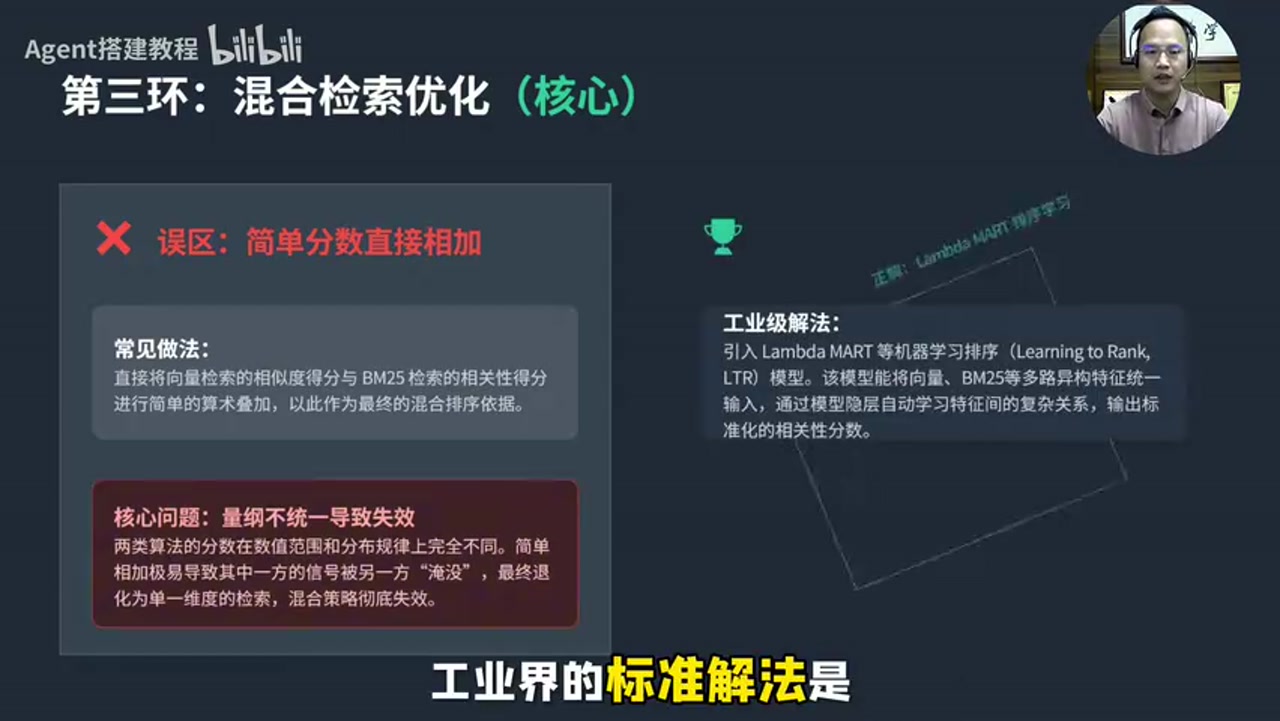
RAG 常用混合检索:
- 向量检索:擅长语义相似,分数常在 0 到 1 之间。
- BM25:擅长关键词精确匹配,分数可能是十几甚至几十。
问题在于,两类分数不在同一个尺度。如果直接把分数相加,BM25 的大数值可能淹没向量检索分数,导致“混合检索”名义上做了,实际排序仍然偏向某一路。
推荐做法:Learning-to-Rank / LambdaMART
视频给出的工业界方案是使用排序学习模型,例如 LambdaMART:
- 把向量相似度、BM25 分数、字段命中、文档新鲜度、来源权重等作为特征。
- 通过轻量排序模型把多路检索特征统一映射到同一个打分维度。
- 用训练好的 ranking score 进行最终排序。
这样比手工拍权重更稳定,也更容易通过离线评测持续优化。
5. 重排序的性能问题:用策略路由控制成本
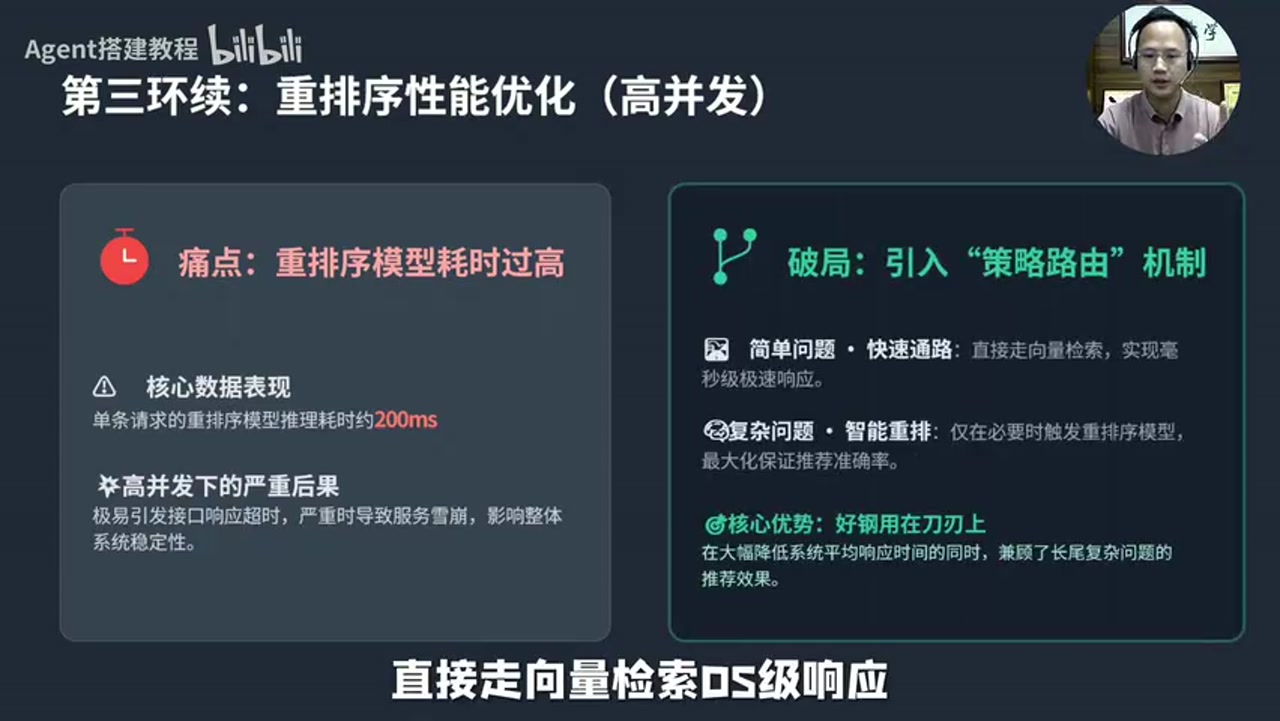
Cross Encoder 或重排序模型通常效果更好,但代价是推理慢。视频中提到单次重排序可能达到约 200ms,高并发下容易造成接口超时,甚至拖垮服务。
解决方向不是所有请求都上重排序,而是做策略路由:
- 简单问题:直接走向量检索或基础混合检索,追求低延迟。
- 复杂问题:多轮、歧义明显、初检匹配度低时,再触发重排序。
- 高价值场景:只把 expensive rerank 用在最需要它的请求上。
这样既保留准确率收益,又能控制延迟和成本。
6. 第四环:指标监控优化,把“准确率”拆开看
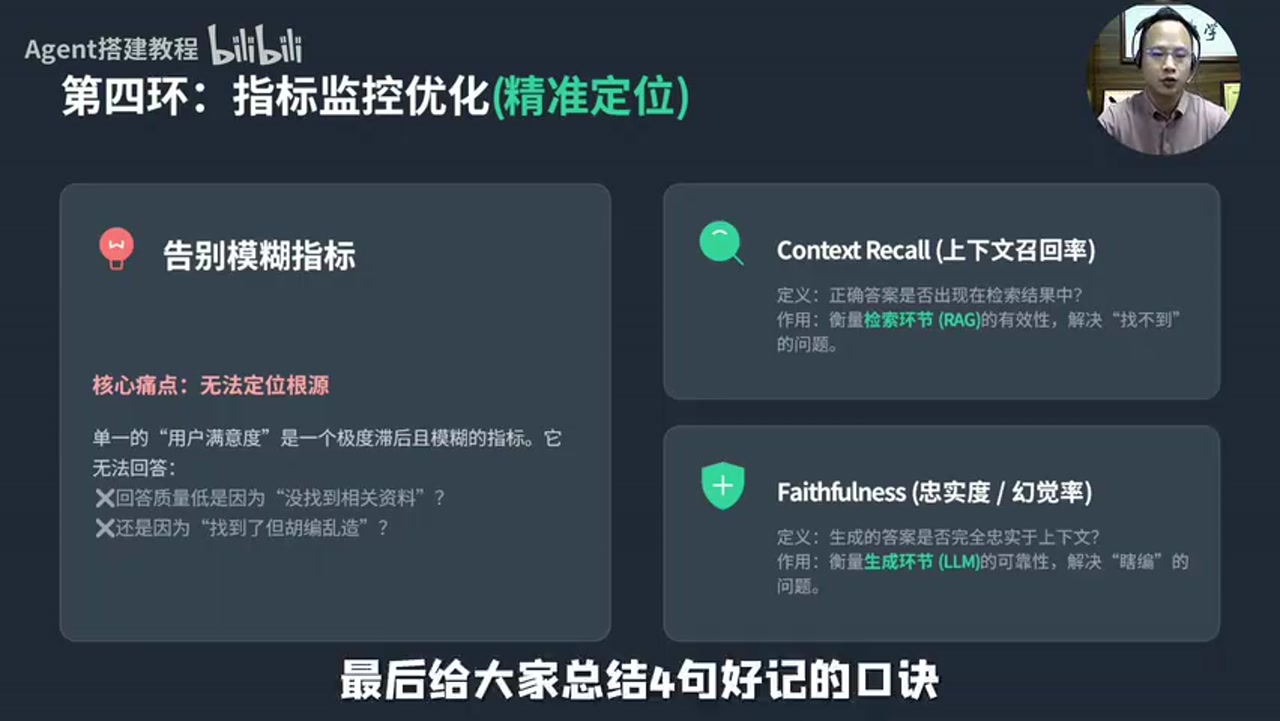
只说“整体准确率 85%”说服力不够,因为它无法说明问题来自哪里。视频建议至少拆成两个核心指标。
Context Recall:上下文召回率
它回答的问题是:用户问题的正确答案,是否出现在检索回来的 Top-K 文档切片里?
如果正确答案没有被召回,说明问题主要在检索侧:
- 文档切分不合理。
- Query 改写或扩展不合理。
- 检索策略或索引有问题。
- Top-K 太小或排序策略有问题。
Faithfulness:忠实度
它回答的问题是:模型生成的答案是否忠实于检索到的资料?
如果资料里明明是 A,模型却回答成 B,问题主要在生成侧:
- Prompt 约束不够。
- 模型没有被要求引用证据。
- 上下文太长或噪声太多。
- 生成策略导致幻觉。
这两个指标配合使用,才能判断应该优化检索链路,还是优化生成链路。
7. 面试回答模板
可以这样回答:
我不会只看整体准确率,而会先把 RAG 链路拆开定位。第一步看 Context Recall,确认正确答案是否进入了检索 Top-K;如果没有,就优化文档分块、Query 改写、混合检索和重排序。第二步看 Faithfulness,确认模型有没有基于召回材料忠实回答;如果召回正确但回答错误,就优化 prompt、引用约束和生成策略。
具体优化上,文档切分不能一刀切,要基于语义和结构做动态切分,并保留 10% 到 20% 的重叠窗口;Query 改写要做语义相似度校验,避免把“退费”改成“收费”这种语义漂移;混合检索不能简单把向量分和 BM25 分相加,可以用 LambdaMART 这类 Learning-to-Rank 模型统一排序;重排序模型成本高,所以用策略路由,只在复杂问题或初检效果差时触发。
8. 口诀整理
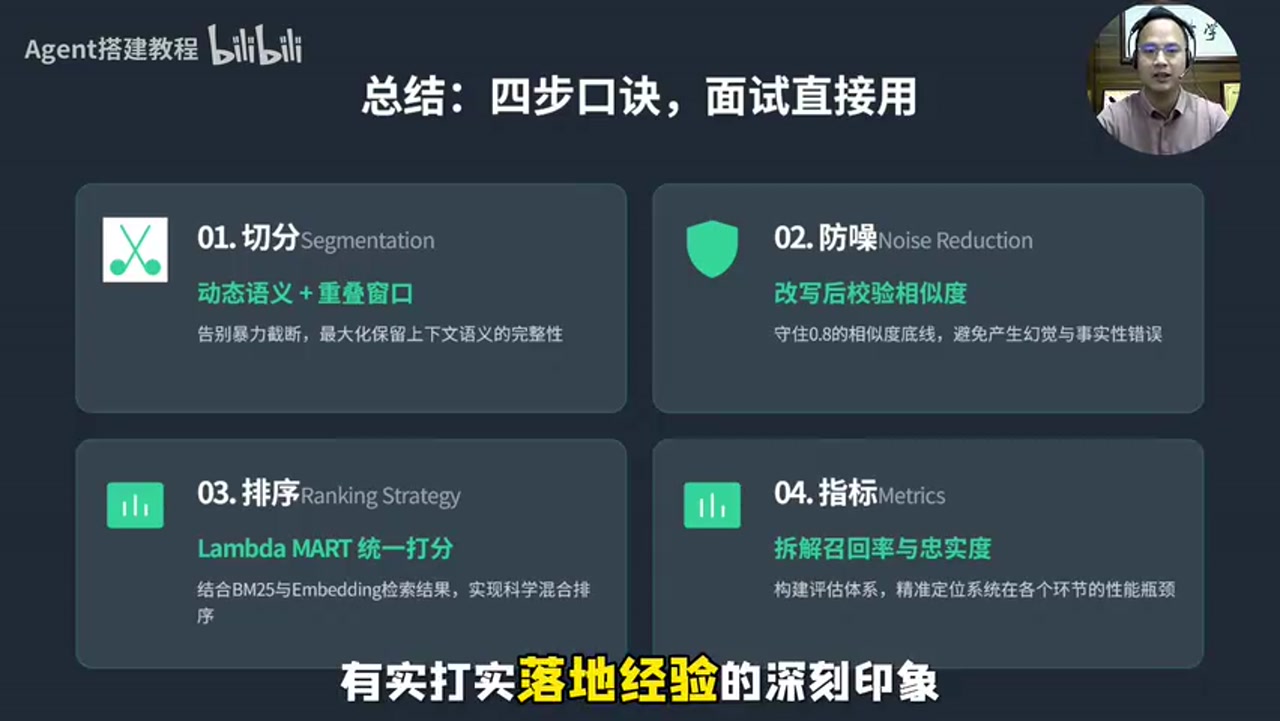
- 切分不要一刀切:动态语义 + overlap。
- 改写不要丢原意:相似度校验兜底。
- 排序不要拍脑袋:用 Learning-to-Rank 统一多路分数。
- 优化不要只看总分:Context Recall 和 Faithfulness 分开定位。
9. 可落地检查清单
| 环节 | 检查问题 | 优化动作 |
|---|---|---|
| 文档分块 | Chunk 是否切断标题、段落、表格、因果链? | 结构解析、语义切分、10%-20% overlap |
| Query 预处理 | 短问题、口语问题是否召回不足? | Query Rewrite、Query Expansion |
| 语义校验 | 改写是否偏离原意? | embedding 相似度阈值过滤,例如 0.8 |
| 混合检索 | 向量分和 BM25 分是否尺度不一致? | Learning-to-Rank、LambdaMART |
| 重排序 | 是否所有请求都触发慢 reranker? | 策略路由、复杂问题才触发 |
| 检索评估 | 正确答案是否进入 Top-K? | 监控 Context Recall |
| 生成评估 | 模型是否脱离资料乱答? | 监控 Faithfulness,优化 prompt 和引用约束 |
10. 我的理解
这个视频的重点不是“某个神奇参数能把准确率从 60% 拉到 85%”,而是把 RAG 看成一个可观测、可定位、可分层优化的工程系统。
面试里讲清楚这套逻辑,会比只说“用 rerank、调 prompt、换 embedding 模型”更像真实落地经验:先判断答案有没有被检索到,再判断模型有没有忠实使用检索结果。前者是 retrieval 问题,后者是 generation 问题,二者不能混在一起调。
相关笔记
- RAG高级检索与优化 — 各优化手段的原理与边界
- RAG评测与排障 — Recall 与 Faithfulness 的定位方法
- RAG工程全流程 — 优化点在完整链路中的位置
- RAG 专题导航