 SUN
Chapter 1 计算机系统漫游
信息就是位 + 上下文
- 本质:所有信息在计算机中都是二进制位(bit)的序列。
- 意义:不同的上下文解释方式,决定相同的二进制序列可以代表:
- 整数
- 浮点数
- 字符串(ASCII/Unicode)
- 指令
- 重点:计算机的“多样性”来源于解释方式,而非比特本身。
编译系统
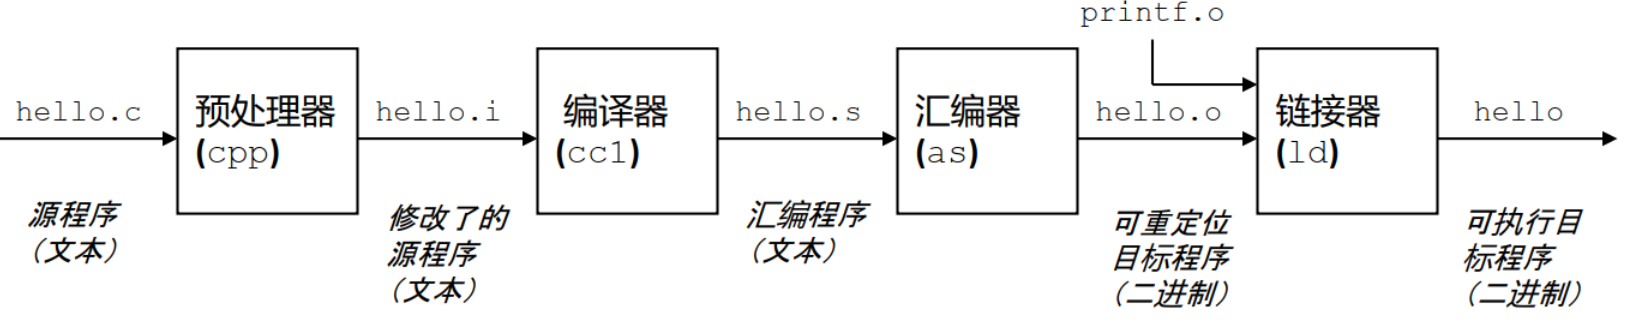
- 从源码到可执行程序的过程:
- 预处理器 (cpp):处理
#include和宏。 - 编译器 (cc1):C 源代码 → 汇编程序。
- 汇编器 (as):汇编程序 → 目标文件(机器码,但不完整)。
- 链接器 (ld):把多个目标文件和库拼接,生成完整的可执行文件。
- 预处理器 (cpp):处理
- 重点:编译 + 链接流程,让你理解为什么有时候“链接错误”而不是“编译错误”。
处理器读并解释存储在内存中的指令
- 存储程序计算机:程序和数据统一存储在内存中。
- CPU 的主要硬件结构:
- PC (程序计数器):保存下一条指令地址。
- 寄存器文件:小而快的存储器,保存临时数据。
- 算术逻辑单元 (ALU):执行运算。
- 执行步骤(取指 → 译码 → 执行 → 写回 → 更新 PC)。
高速缓存至关重要
- 存储器层次结构:寄存器 → 高速缓存(Cache)→ 主存 → 磁盘。
- 关键点:缓存弥补了 CPU 与内存之间的速度差距。
- 局部性原理:程序往往重复使用最近访问过的数据或指令 → 使缓存有效。
存储设备形成层次结构
- 自顶向下速度递减,容量递增,成本递减:
- CPU 寄存器(最小、最快)
- L1/L2/L3 Cache
- 主存 (DRAM)
- 磁盘 (SSD/HDD)
- 远程存储/云存储
- 重点:理解这层结构,有助于后续学习内存管理、性能优化。
操作系统管理硬件
- 操作系统 (OS) 的两个基本功能:
- 抽象:屏蔽硬件细节,提供文件、进程、虚拟内存、网络等抽象概念。
- 资源管理:公平、安全、高效地分配 CPU、内存、I/O。
- 三个重要抽象:
- 文件(对 I/O 设备的抽象)
- 虚拟内存(对内存和磁盘的抽象)
- 进程(对正在运行的程序的抽象)
系统之间利用网络通信
- 互联网模型:所有计算机通过网络接口卡 (NIC) 发送/接收字节流。
- 重要性:现代程序几乎都涉及网络交互(Web 服务、数据库、云计算)。
重要主题
- 并发与并行:
- 并发:同时处理多个任务(逻辑上并行,未必真的同时)。
- 并行:多个处理器/核心真正同时执行任务。
- 计算机系统的能效问题:现代设计越来越关注能耗与效率。
总结:计算机系统是一堆抽象层次
- 从程序员编写的 C 程序 → 汇编指令 → 机器码 → 处理器/内存/IO 执行 → 操作系统管理 → 网络互联。
- 核心视角:程序员需要理解这些层次,写出既正确又高效的代码。
Chapter 2 程序结构和执行
信息存储
基础知识
bit(比特):每一个比特是0或1,被称为”位“
一个字节包含8比特位 Byte = 8 bits
字数据大小
组合字节以创建标量数据类型
| C Data Type | 32-bit | 64-bit |
|---|---|---|
| char | 1 | 1 |
| short | 2 | 2 |
| int | 4 | 4 |
| long | 4 | 8 |
| float | 4 | 4 |
| double | 8 | 8 |
| pointer | 4 | 8 |
字节顺序
内存是按字节(8 位)编址的;多字节类型(例如 16/32/64 位整数或浮点数)在内存里要占用多个连续字节。
字节序就是多字节数值在内存中按地址排列各个字节的顺序规则。有两种常见约定:
- 大端(big-endian):高有效字节在最前面(和人阅读顺序相同)
- 小端(little-endian):低有效字节在最前面(更贴合电路习惯)
字节序只是“在内存里字节的排列顺序”的约定,不改变数值的数学意义;只是当把内存当作“字节流”读/写或在不同机器之间交换二进制时会产生差异。
位运算
位运算,在离散/数字逻辑中学过,将运算运用到每个比特位
在 C(以及机器指令)中常用的位运算有:~(按位取反)、&(按位与)、|(按位或)、^(按位异或)、<<(左移)、>>(右移)。
比特位级异或是一种加法
除此之外应额外注意异或操作,如:
int inplace_swap(int *x, int *y){
	*x = *x ^ *y;
	*y = *x ^ *y;
	*x = *x ^ *y;
}
上面的这个函数在不多定义变量的情况下交换了指针x和y所指向的地址
掩码操作
- 在计算机里,所有数据最终都以 位模式(bit pattern) 存储。
- 掩码 就是一种“位级选择器”,本身也是一个二进制数。
- 当你把某个数
x和掩码m做按位运算(如 AND&、OR|、XOR^)时,掩码的每一位(0 或 1)决定了结果中对应位的保留、清除或改变。
掩码决定哪些位能通过,哪些位要被屏蔽掉。
掩码的核心用途(常见情形)
与掩码 AND → 挑选(保留/清除)
与掩码 OR → 强制设 1
与掩码 XOR → 翻转
- 从一个整数中提取某个位域(例如提取某个字节或低 k 位)。
- 清零(clear)或置位(set)某些位。
- 翻转(toggle)某些位。
- 按位打包/拆包(pack/unpack bytes 或 fields)。
- 对齐(alignment):清低 k 位以对齐到 2^k 的边界。
- 在网络/文件二进制交互中保证固定字节序与格式。
常见掩码操作
1. 取出某些位(位清零)
- 如果我们想要 保留某些位,其它位都变成 0,就用 AND 掩码:
- 掩码位是 1 → 保留原来的位
- 掩码位是 0 → 把该位清零
例子:
unsigned x = 0x89ABCDEF;
unsigned y = x & 0xFF;   // 掩码 0xFF = 00000000 00000000 00000000 11111111
结果:y = 0x000000EF,只保留了最低有效字节,其它都变 0。
这就是书里讲的 “掩码 0xFF 指定了最低 8 位”。
2. 强制某些位为 1(位设置)
- 如果我们想要 把某些位强制设成 1,不管原来是什么,就用 OR 掩码:
- 掩码位是 1 → 对应结果必为 1
- 掩码位是 0 → 保持原来的位
例子:
unsigned x = 0x87654321;
unsigned y = x | 0xFF;   // 掩码 0xFF = 00000000 00000000 00000000 11111111
结果:y = 0x876543FF,最低字节被强制设为全 1,其它字节保持不变。
3. 强制某些位为 0(位清除)
- 如果我们想要 把某些位强制设为 0,就用 AND 和取反的掩码:
- 掩码位是 0 → 对应结果必为 0
- 掩码位是 1 → 保持原来的位
例子:
unsigned x = 0x87654321;
unsigned y = x & ~0xFF;  // 掩码 ~0xFF = 11111111 11111111 11111111 00000000
结果:y = 0x87654300,最低字节被清零,其它字节保持不变。
4. 取反/翻转某些位
- 如果我们想要 翻转某些位(0变1,1变0),就用 XOR 掩码:
- 掩码位是 1 → 翻转对应位
- 掩码位是 0 → 保持原来的位
例子:
unsigned x = 0x87654321;
unsigned y = x ^ 0xFF;   // 掩码 0xFF = 00000000 00000000 00000000 11111111
结果:y = 0x876543DE,最低字节被翻转,其它字节保持不变。
移位运算
左移 x<<y
-
x每一位向左移y位,左边的多余的比特位丢弃
-
右边用0填充
unsigned x = 0x00000021; // 二进制 00000000 00000000 00000000 00100001
unsigned y = x << 3;     // 左移 3 位
// 结果 y = 0x00000108,二进制 00000000 00000000 00000001 00001000
左移常用于 构造掩码、快速乘以 2 的幂 或 打包位域。
右移 x>>y
-
位向量x右移y位,丢弃右边多余的比特
-
无符号整数
unsigned:逻辑移位左边用0填充,相当于除以 2^n(向下取整)。
int a = -8; // 二进制 11111111 11111111 11111111 11111000 (32位表示) int b = a >> 2; // 算术右移 2 位 // 结果 b = -2,二进制 11111111 11111111 11111111 11111110 -
带符号整数
int:算术移位左边补符号位(最高位)
如果是正数,高位补 0
如果是负数,高位补 1(保持符号)
unsigned u = 0x87654321;
unsigned v = u >> 8;   // 逻辑右移 8 位
// 结果 v = 0x00876543
-
未定义行为
对带符号类型左移,结果溢出会是 未定义行为。
移位量小于零或大于等于数据类型的位宽(溢出)
综合
移位操作经常和 掩码(mask)操作结合使用:
位计数 bitCount:返回字中1的个数
int bitCount(int x) {
	int m1 = 0x11 | (0x11 << 8);
	int mask = m1 | (m1 << 16);		//mask = 0x11111111
	int s = x & mask;
	s += x>>1 & mask;
	s += x>>2 & mask;
	s += x>>3 & mask;
    /* Now combine high and low order sums */
	s = s + (s >> 16);
	/* Low order 16 bits now consists of 4 sums.
		Split into two groups and sum */
	mask = 0xF | (0xF << 8);
	s = (s & mask) + ((s >> 4) & mask);
	return (s + (s>>8)) & 0x3F;
}
提取低位或高位
unsigned x = 0x12345678;
unsigned low_byte = x & 0xFF;        // 保留最低 8 位
unsigned high_byte = (x >> 24) & 0xFF; // 提取最高 8 位
构造掩码
- 低 k 位全 1 的掩码:
(1u << k) - 1 - 高 k 位全 1 的掩码:
~((1u << (w - k)) - 1)(w 是字长)
打包字段
unsigned a = 0x12, b = 0x34;
unsigned packed = (a << 8) | b;  // a 放高 8 位,b 放低 8 位
// packed = 0x1234
整数表示
原码、反码、补码
- 原码(符合人的直觉,但是计算机在直接相加相反数时不等于0)
- 首位数字做符号位(0为正,1为负)
- 后续位按二进制数
- 反码(中间态,无实际意义)
- 正数不变
- 负数除去符号位都取反
- 补码
- 正数相对于原码不变
- 负数将原码除去符号位都取反再加1
计算机中不包含原码,都是通过补码实现的
假设十进制数 3 的原码是: 00011 -> 所以补码也是00011
而十进制数 -3 的原码是: 10011 -> 反码是11100 -> 补码是11101
而3和-3的补码相加,是00000,也就是0的补码。补码的存在可以使计算机直接相加来计算正负数的加法。
无符号数编码 Unsigned
假设一个整数数据有
介于
比如 8 位:
0000 0000→ 00000 0001→ 1- …
1111 1111→ 255
补码编码
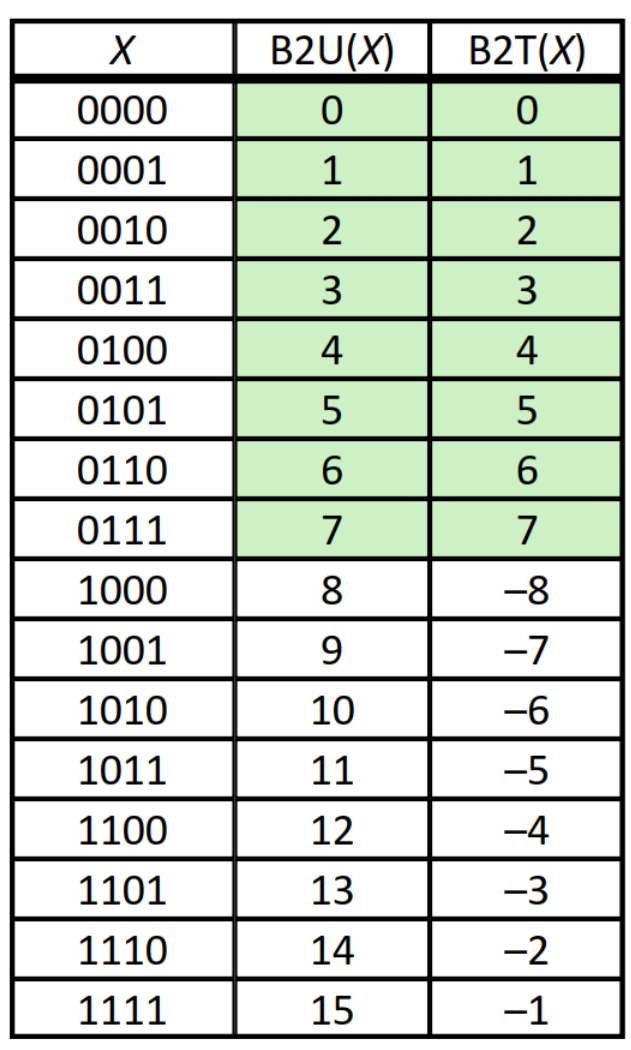
最常见的有符号数的表示方式就是补码形式,其最高位被解释为==负权==,有符号数的值为
补码可以表示的值范围为
用补码编码的整数,其相反数的转换只需要将其补码取反并加1。如:
用 8 位举例:
- 最小值:
1000 0000→-128 - 最大值:
0111 1111→+127
有符号数与无符号数的转换
强制类型转换的结果保持位值不变,只是改变了解释这些位的方式:
- 对于有符号数转无符号数:若有符号数为非负数则不变,若为负数则需要加
- 对于无符号数转有符号数:上面的反过来
C语言中的有符号数和无符号数
有符号数和无符号数都只是表达形式,起决定作用的还是真正存储的数据
有符号数和无符号数的转换分为强制类型转换和隐式转换两种
当执行一个运算时,如果它的一个运算数是有符号的而另一个是无符号的,那么C语言会隐式的地将有符号参数强制转换为无符号参数
C语言还可以执行显式地强制转换
扩展
当我们要把一个值从位数较少的整数转到位数更多的整数时,就需要进行扩展,并且扩展前后数值要相同
- 将一个无符号数扩展为一个更大的数据类型,我们只要简单地在表示的开头添加0,称为==零扩展==
- 将一个补码数字转换为一个更大的数据类型,要在表示中添加最高有效位的值添加1,称为==符号扩展==
当扩展与有符号数/无符号数转换同时发生时,如:
short sx = -12345;
unsigned uy = sx;
要先改变大小,之后再完成从有符号到无符号的转换
截断
扩展做的是从短到长的转换,从长到短则需要进行截断;并且尽可能地使截断前后数值不变(截断的值足够小的情况下)
- 对于无符号数,直接丢弃头k位即可
- 对于补码表示的有符号数,也丢弃头k位,然后将剩余的几位的补码表示作为结果
整数运算
加法
无符号数加法
两个无符号数相加,计算得到的结果要舍弃最高位进位,若最高位进位为1,则此时发生了溢出
检测是否有溢出,就看得到的结果是否比两个运算数大:设结果为
补码加法
仍然是直接相加然后舍弃最高位进位:
此时溢出分为两种:
- 正溢出:正溢出只能是两个正数相加,也就是
;并且 - 负溢出:负溢出只能是两个负数相加,也就是
;并且
补码的非
除符号位外取非
乘法
无符号数/补码乘法
乘完之后都是截断到低w位
移位实现整数乘法
乘法指令速度非常慢,远远慢于移位运算、加减、位运算。所以用加减法与移位运算组合来实现一些整数乘法可以加快代码运行的速度
乘以2的幂
无符号数或者补码数
乘以任意整数
将移位运算与加减法运算组合
除以2的幂
可以用右移来实现,但是用右移实现的除法永远是向下舍入的。这在被除数大于0时是正确的,但如果被除数小于0则会发生错误——
使用==偏置==(Bias):让x在右移前加上一个数,这个数要使得x为正数时无影响,为负数时会令最终结果+1
将
举例:
。其 , , ,计算得到了正确结果
不过除法不能像乘法那样推广到任意整数
浮点数
浮点数对形如
二进制小数
类似于十进制,使用形如
小数的二进制表示法只能表示那些能够被写成
浮点数就相当于二进制里的“科学计数法”
任何 非零二进制数,都可以写成:
1.xxxxx × 2^E
例如:
101.101₂ = 1.01101₂ × 2^2
注意这个事实:
二进制科学计数法里,最高位永远是 1(除非是 0)
IEEE浮点表示
前面表示二进制小数使用的是定点表示法,也就是说小数点位置固定,这样无法表示非常接近于0的值和非常大的值
所以IEEE采用浮点标准,用
- 符号位
确定数值是负还是正 - 尾数
是范围在 之间的普通小数 - 阶码
是给浮点数指定 权重
32位浮点数:
| 部分 | 位数 | 功能 |
|---|---|---|
| 符号位 (S) | 1 | 决定数是正还是负。0 表示正,1 表示负。 |
| 指数 (E) | 8 | 存储指数值,使用 偏置表示(Bias)。实际指数 = E - Bias。 |
| 尾数 / 小数 (F) | 23 | 存储有效数字的小数部分,正规数的最高位 1 是隐含的,不存储。 |
将浮点数的位表示划分为三个字段,分别对这些值进行编码:
- 最高位是一个单独的符号位
编码符号 位的阶码字段 编码阶码 位小数字段 编码M
| s | exp | frac | |
|---|---|---|---|
| 单精度 | 1 | 8 | 23 |
| 双精度 | 1 | 11 | 52 |
| 扩展精度 | 1 | 15 | 64 |
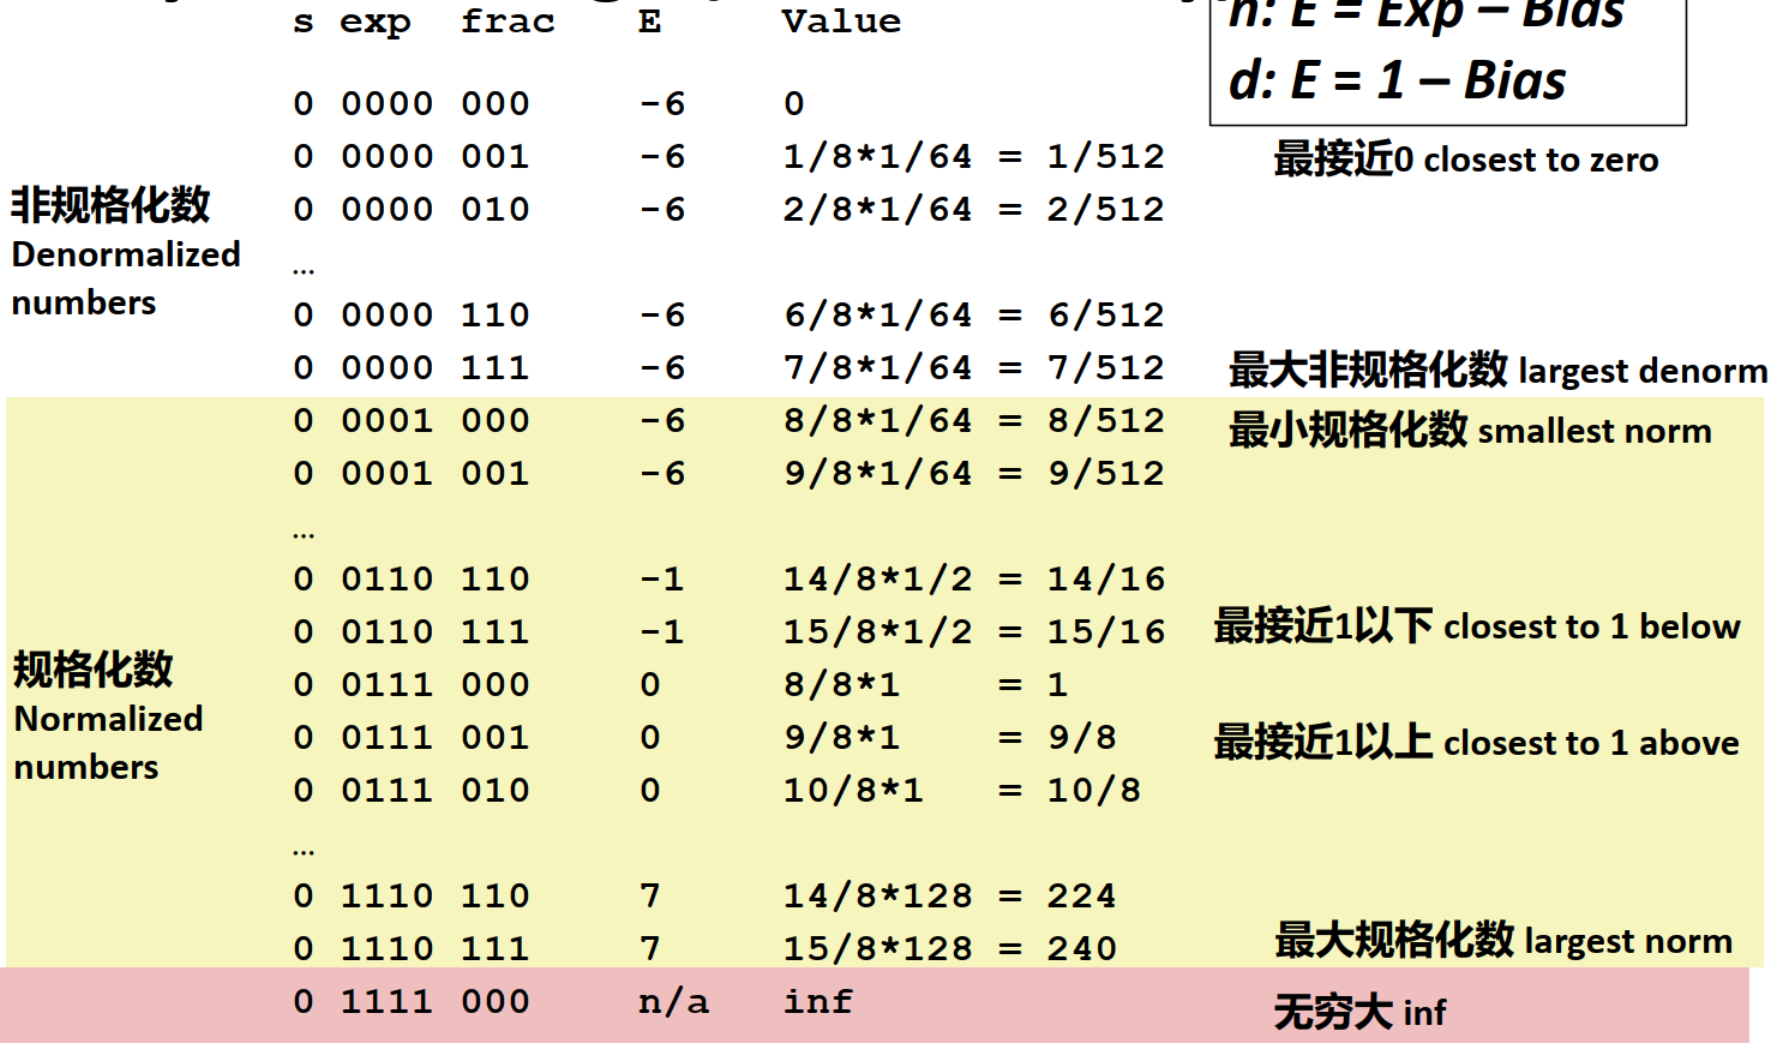
根据阶码exp的值,浮点数编码的值分为三种情况:
- 规格化的值
- 非规格化的值
- 特殊值
正规数:最高位隐含 1,实际值 = 1.F
非正规数:最高位为 0,实际值 = 0.F
规格化的值
exp的位模式既不全为0,也不全为1,此时表示的数为规格化的数
- exp字段被解释为以偏置形式表示的有符号整数,即
。设exp字段长度为 位,那么 ,单精度时为127,双精度时为1023。 - frac被解释为描述小数值
,其中 ,并定义尾数值 。因为M总是1点几的一个小数,那么就没必要显式表示开头的那个1
所以
非规格化的值
exp的位模式全为0时,表示的数为非规格化的数,其提供了一种表示0的方法
- 阶码值
- 尾数值
,不包含开头隐含的1
非规格化数分布在0的周围,越靠近0越稠密
非规格化的值通过把
特殊值
exp位模式全都为1
- 无穷大:小数值
- NaN:小数值
,代表无法确定数值的情况

小结
- 浮点数的0和整数的0相同
- 浮点数之间几乎可以使用无符号整数比较大小的方式,但要注意:
- 先比较符号位
- 注意
的情况 - 注意NaN比任何数都大
舍入 Round
对于一个值
IEEE为浮点定了四种不同的舍入方式:向偶数舍入(默认)、向零舍入、向下舍入和向上舍入。向偶数舍入没有统计偏差
向偶数舍入
若最低有效位为0认为是偶数,为1认为是奇数。一般来说,只有对形如
我们将舍入值到小数点右两位,那么
10.00011将被舍入到10.00,因为它小于10.00100
10.00110将被舍入到10.01,因为它大于10.00100
10.11100将被舍入到11.00,10.10100将被舍入到10.10
因为这些值是两个可能值的中间值,舍入后要使最低位为0
浮点运算
浮点加法
浮点加法的关键在于要对齐小数点
计算:
设
- 符号位s和尾数M组成有符号数,在对齐小数点之后直接进行加法
- 对齐小数点的方式就是把
左移 位

修正:
- 若
,M右移,E加一 - 若
,则M左移k位直至 ,并且E减k - 若E超出范围则溢出
- M舍入到适合frac的精度
浮点乘法
计算:
- 符号位s进行异或运算
- 尾数M直接相乘
- 阶码E相加
修正:
- 若
,M右移,阶码E加1 - 若E超出范围则溢出
- M舍入到适合frac的精度
浮点数加法与乘法的性质
- 都满足交换律
- 都不满足结合律(溢出问题)
C语言中的浮点数
C语言中有单精度浮点float和双精度浮点double
在int,float和double之间存在强制转换==改变比特位表示==:
-
double/float → int
-
截断尾数部分,向0舍入
-
当超过范围或NaN时一般设置为TMin
-
int → double
精确转换,只要int字长小于等于53位
- int → float
不会溢出,但是按照舍入模式进行舍入
Chapter 3 程序的机器级表示
讲授内容
IA32 ▪ 传统的x86 The traditional x86 ▪ 第二版
x86-64 ▪ 目前的标准 The standard ▪ shark> gcc hello.c ▪ shark> gcc –m64 hello.c
我们仅讨论x86-64 We will only cover x86-64
访问信息
程序员可见状态
- PC程序计数器:存储下条指令地址,称为RIP
- 寄存器文件:16个通用寄存器
- 条件码:存储有关最近的算数和逻辑运算的状态信息
- 内存:代码、数据、栈等
16个64位通用寄存器:


常见寄存器
| 寄存器 | 功能 |
|---|---|
%rax |
通用寄存器,常作返回值寄存器 |
%rbx |
通用寄存器 |
%rcx |
通用寄存器,常用于计数循环 |
%rdx |
通用寄存器,常用于传参或中间结果 |
%rsi |
函数第2个参数 |
%rdi |
函数第1个参数 |
%rsp |
栈顶指针(stack pointer) |
%rbp |
栈基址指针(base pointer) |
%r8~%r15 |
额外通用寄存器 |
%rip |
指令指针,指向下一条要执行的指令 |
数据寻址
操作数按照来源可以分为三种类型:
- 立即数
- 寄存器
- 内存引用

内存寻址
汇编里,内存寻址语法非常强大,允许你这样写:
disp(base, index, scale)
含义是:
有效地址 = disp + base + index * scale
其中:
disp是立即数(位移量)base是一个寄存器(通常是基址)index是另一个寄存器(索引)scale是乘数(只能是 1、2、4、8)
也就是说,它天然支持一个“线性组合:常数 + 加法 + 乘法”形式。
在mov和lea中可以直接使用这个内存寻址
汇编命令
数据传送指令 mov
mov
作用:复制数据(类似于C语言的赋值)
格式
mov 源, 目的
例:
mov %rax, %rbx       ; 把rax的内容复制到rbx
mov $5, %rax         ; 把常数5装入rax
mov %eax, -4(%rbp)   ; 把eax内容存到栈中rbp-4处
mov 8(%rbp), %rax    ; 把栈中rbp+8处的值加载到rax
小技巧:
$表示立即数,()表示取地址内容。

注意单条指令中不能进行内存到内存的传送
扩展传送:

加载有效地址 lea
全称: load effective address(装载有效地址)
意思是——它不去取地址里的值,而是计算地址本身的数值。
换句话说:
mov是“取内容”,lea是“取地址(计算式的结果)”。
基本格式
lea 源, 目的
其中源操作数必须是内存寻址表达式(带括号的形式)。 例如:
lea 8(%rdi,%rsi,4), %rax
这条指令做的事情是:
%rax = rax = rdi + rsi*4 + 8
而不是去取rax这个地址里的值
与mov比较
| 指令 | 含义 | 示例 | 结果 |
|---|---|---|---|
mov 8(%rbp), %rax |
取地址里的内容 | 把[rbp+8]的内存值加载到rax |
取内容 |
lea 8(%rbp), %rax |
取地址本身 | 把rbp+8这个地址的值(数)装入rax |
取地址值 |
可以这么理解:
mov→ “访问内存”lea→ “做加法运算”
虽然lea 本身是为了去地址而设计的,但是它的地址计算规则速度快且强大,所以被用于直接计算
例子1:
设我们有下面的C代码:
int arr[5];
int *p = &arr[2];
编译后的汇编可能是:
lea 8(%rbp), %rax   ; %rax = %rbp + 8,相当于 &arr[2]
mov %rax, -8(%rbp)  ; 保存指针p
lea帮我们算出了地址值,而不是读了那块内存。
例子2:
假如我们要在C中计算 3*x + 5:
编译后的汇编可能是:
lea 5(%rdi, %rdi, 2), %eax
先使用mov把x这个数存到%rdi寄存器中,然后计算得到的结果是%eax
算数运算符
| 指令 | 含义 | 示例 |
|---|---|---|
add |
加法 | add %rbx, %rax → rax = rax + rbx |
sub |
减法 | sub $1, %rax → rax = rax - 1 |
imul |
乘法(有符号) | imul %rbx, %rax → rax *= rbx |
idiv |
除法(有符号) | 需用 %rax 作被除数,结果在%rax和%rdx |
inc |
自增 | inc %rax |
dec |
自减 | dec %rax |
neg |
取负 | neg %rax → rax = -rax |
注意:mul、idiv 是特殊的,它们隐式使用 RAX 和 RDX。
自增自减广泛用于循环计数

逻辑与位运算
| 指令 | 含义 | 示例 |
|---|---|---|
and |
按位与 | and $0xFF, %rax |
or |
按位或 | or $1, %rax |
xor |
按位异或 | xor %rax, %rax → 把rax清零 |
not |
按位取反 | not %rax |
shl / sal |
左移 | shl $1, %rax |
shr |
右移(逻辑) | shr $1, %rax |
sar |
右移(算术,保留符号位) | sar $1, %rax |
记忆方法:中间是A的为算数移位;中间是H的为逻辑移位
xor %eax, %eax 是个常见技巧:把寄存器清零(更快更短)。
因为:
eax ^ eax = 0
所以编译器常用这条代替 mov $0, %eax。
栈操作
栈是函数调用时用来保存局部变量和返回地址的结构。 栈从高地址向低地址增长。
| 指令 | 含义 |
|---|---|
push src |
栈顶指针%rsp减8,并把src压栈 |
pop dst |
从栈顶取值到dst,然后%rsp加8 |
leave |
恢复栈帧(等价于mov %rbp, %rsp; pop %rbp) |
ret |
从栈中弹出返回地址并跳转到它 |
注意栈顶的地址值小于栈底的地址;并且程序也可以用rsp寄存器使用内存寻址的方法访问栈内的值

函数调用
函数调用使用:
call 函数名
它会:
- 把当前下一条指令地址压栈(作为返回点)
- 跳转到函数地址
函数返回用:
ret
函数参数传递规则(System V ABI,Linux默认):
| 参数序号 | 寄存器 |
|---|---|
| 第1个参数 | %rdi |
| 第2个参数 | %rsi |
| 第3个参数 | %rdx |
| 第4个参数 | %rcx |
| 第5个参数 | %r8 |
| 第6个参数 | %r9 |
其余参数通过栈传递。
函数栈帧结构
每次调用函数时,栈的结构如下:
高地址
+----------------+
| 上一个栈帧    |
+----------------+
| 返回地址       | ← call 指令自动压栈
+----------------+
| 旧的 %rbp      | ← 保存上一个栈帧基址
+----------------+
| 局部变量       | ← 负偏移访问
| 临时保存值     |
+----------------+
低地址
进入函数时通常看到的模式:
push %rbp
mov %rsp, %rbp
sub $0x20, %rsp     ; 为局部变量留空间
退出函数时:
leave    ; 恢复栈帧
ret      ; 返回上层
一元与二元操作
注意二元操作中,第二个操作数既是源又是目的操作数
-
一元操作(unary operation) ➜ 只对一个操作数进行计算,比如取负、取反、自增、自减等。 示例:
inc %eax ; %eax = %eax + 1 dec %eax ; %eax = %eax - 1 neg %eax ; %eax = -%eax not %eax ; %eax = ~%eax (按位取反) -
二元操作(binary operation) ➜ 对两个操作数进行计算,比如加、减、乘、与、或、异或。
在 x86 汇编里,大多数二元操作都是:
形式通常是:
op src, dst ; dst = dst op src比如:
add %ebx, %eax  ; eax = eax + ebx
sub %ecx, %edx  ; edx = edx - ecx
imul %esi, %edi ; edi = edi * esi
and %ebx, %eax  ; eax = eax & ebx
or  %ebx, %eax  ; eax = eax | ebx
xor %ebx, %eax  ; eax = eax ^ ebx
特殊算术操作
只有一个操作数,是乘数之一或者除数,另一个乘数放在$rax,被除数放在%rdx:%rax

综合例子分析
C 代码:
int sum(int a, int b) {
    return a + b;
}
对应汇编(简化):
sum:
    push %rbp
    mov %rsp, %rbp
    mov %edi, -4(%rbp)   ; 保存第1个参数a
    mov %esi, -8(%rbp)   ; 保存第2个参数b
    mov -4(%rbp), %edx
    add -8(%rbp), %edx   ; edx = a + b
    mov %edx, %eax       ; 返回值放入eax
    pop %rbp
    ret
调用时(例如 sum(3, 5)):
3被放入%edi5被放入%esi
控制
大部分程序不会是一条一条指令顺序执行的,中间会发生跳转。要实现跳转那么必须有改变控制流的方法
条件码
-
CF:==进位标志==
当结果产生一个进位或错位,CF=1,否则CF=0;在移位或循环移位指令时,会把左移时的最高位或右移时的最低为移入CF
-
ZF:==零标志==
当运算结果为0时,ZF为1,否则为0
-
SF:==符号标志==
与运算结果的最高位相同
-
OF:==溢出标志== 最近的操作导致一个补码溢出则OF置1
上面讲到的算术和逻辑操作中,除了leaq指令都会改变条件码
设置条件码
CMP指令和TEST指令都只设置条件码而不改变任何其他寄存器

注意下面的指令是针对有符号数还是无符号数:有符号数对应g/l,无符号数对应a/b
比较 cmp
对应c中的分支语句
比较两个数,结果存入标志寄存器(EFLAGS)。
cmp src, dst ; 等价于 tmp = dst - src; 更新标志
例:
cmp $5, %eax ; 相当于 tmp = eax - 5
若
%eax == 5→ ZF = 1若
%eax < 5(有符号) → SF/OF 表示 tmp < 0 → 可配合jl/jge若
%eax < 5(无符号) → CF = 1 → 可配合jb/jae
测试test
(常用于零检测)
test %eax, %eax ; tmp = eax & eax => 就是看 eax 是否为 0,更新 ZF 和 SF
test 常用于 if (x == 0) 或 if (x & mask) 的判断;test 不产生 OF/CF。
只看结果是不是 0、最高位是不是 1, 然后把:
- ZF ← (结果 == 0)
- SF ← (结果最高位)
- OF = 0
- CF = 0
访问条件码
SET指令根据条件码的组合,将一个字节设置为0或者1,也就是说其目的操作数只能是低位单字节寄存器或者一个字节的内存位置

跳转指令(根据比较结果跳转)
根据条件码判断是否跳转

跳转指令
| 条件 | 含义(C 风格) | 说明 |
|---|---|---|
je / jz |
== | 等于(ZF=1) |
jne / jnz |
!= | 不等(ZF=0) |
jl |
< (signed) | (SF != OF) |
jle |
<= (signed) | ((ZF=1) or (SF != OF)) |
jg |
> (signed) | ((ZF=0) and (SF == OF)) |
jge |
>= (signed) | (SF == OF) |
jb |
< (unsigned) | (CF=1) |
jbe |
<= (unsigned) | (CF=1 or ZF=1) |
ja |
> (unsigned) | (CF=0 and ZF=0) |
jae |
>= (unsigned) | (CF=0) |
ZF:零标志;SF:符号标志;OF:溢出标志。
条件传送指令
判断条件码,若符合条件则执行数据传送

条件分支
使用条件码和控制跳转指令可以实现条件分支
循环
循环结构也可以通过条件判断与条件跳转来实现
do-while
loop:
	body-statement
	t = test-expr;
	if(t)	goto loop;
while
//第一种方法
	goto test;
loop:
	body-statement
test:
	t = test-expr;
	if(t)	goto loop;

//第二种方法
t = test-expr;
if(!t)	goto done;
loop:
	body-statement
    t = test-expr;
	if(t)	goto loop;
for
init-expr;
goto test;
loop:
	body-statement
    update-expr;
test:
	t = test-expr;
	if(t)	goto loop;
switch
使用跳转表加间接跳转实现,如:
jmp *.L4(,%rdi,8) ;L4是跳转表基址
过程 Procedures
过程是软件中一种很重要的抽象,它提供了一种封装代码的方式,用一组指定的参数和一个可选的返回值实现某种功能
要提供对过程的机器级支持,那么必须要有以下几种机制:
- 传递控制:进入过程、回到返回点
- 传递数据:传递过程参数与返回值
- 内存管理:分配和释放存储空间
运行时栈
栈(Stack)
- 一段内存,用 栈规则(stack discipline) 管理
- 栈顶(Top):当前可用的最高地址
- 栈底(Bottom):栈的起始位置
- 栈指针 %rsp:指向当前栈顶
栈和程序寄存器存放着传递控制和数据、分配内存所需要的信息。当P调用Q时,控制和数据信息添加到栈尾;当返回P时,这些信息会被释放掉

- 栈的顶部在低地址,底部在高地址。所以栈向低方向生长
- 寄存器%rsp包含最低栈地址(栈顶地址)
当过程需要的参数超出寄存器能够存放的大小时,就会在栈上分配空间,这个部分叫做==栈帧==
栈帧(Stack Frame)
每次函数调用都会在栈上创建一个 栈帧 来存储函数执行所需状态。
栈帧内容
- 参数(Arguments):传给被调用函数的值
- 局部变量(Local Variables):函数内部使用的临时变量
- 保存的寄存器(Saved Registers):
- 调用者保护寄存器(Caller-saved):调用者自己保存
- 被调用者保护寄存器(Callee-saved):被调用者保存
- 返回地址(Return Address):
call指令压入,用于函数返回 - 旧的栈帧指针(Old %rbp,可选):便于链式访问调用链
栈帧分配与释放
- 进入函数时分配空间:
- 用
subq给局部变量和临时存储分配空间 - 保存被调用者保护寄存器
- 用
- 退出函数时释放空间:
- 恢复被调用者保护寄存器
- 用
ret跳回调用者
转移控制(函数调用)
-
调用函数
call label:把返回地址压入栈,跳转到函数入口
函数入口
- 保存被调用者寄存器
- 分配局部变量栈空间
- 将参数移入寄存器或栈(前 6 个参数放
%rdi-%r9)
函数体执行
- 读取参数,处理逻辑
- 中间结果可能存寄存器或栈上
函数返回
ret- 恢复被调用者寄存器
- 弹出返回地址
- 跳回函数调用位置的下一条语句继续执行
转移数据
在x86-64中,可以通过寄存器最多传递6个参数,其按照以下顺序:

第7个及以后的参数要存入栈内,其中参数7位于栈顶,也就是说最后的参数先入栈,参数7最后入栈
局部存储
栈
一般来说,过程通过减小栈指针在栈上分配空间,分配的结果作为栈帧的一部分,标为局部变量
保护寄存器
| 类型 | 谁保存 | 什么时候保存 | 常见寄存器 |
|---|---|---|---|
| 调用者保护(Caller-saved) | 调用者 | 调用函数前 | %rax, %rdi-%r9, %r10, %r11 |
| 被调用者保护(Callee-saved) | 被调用者 | 使用前,返回前恢复 | %rax, %rdi, %rsi, %rdx, %rcx, %r8~%r11 |
规则解释:
- Caller-saved:调用者的临时值可能在函数调用中被覆盖,所以调用者负责先保存
- Callee-saved:被调用者需要使用这些寄存器,必须在修改前保存,函数返回前恢复原值
递归
递归跟上面的数据/控制转移没有本质区别,无非递归是自己调用自己罢了
递归函数的每一层调用都会在栈上生成新的栈帧,保证每次调用的数据互不干扰
但是要注意递归的结束条件
数组和指针
数组分配
设数组A的定义语句为T A[L];,则会在内存中分配

指针与数组访问
注意指针运算:假设p是一个指向类型T的指针,且p的值为p++;会将p的值更改为

嵌套数组
下面的声明1与声明2等价:
// 声明1
int A[5][3];

// 声明2
typedef int row3_t[3];
row3_t A[5];
也就是说row3_t被定义为一个3个整数的数组,A数组的每一个元素都是一个3个整数的数组
嵌套数组采用==行优先==的顺序
要访问多维数组的元素,编译器会以数组起始为基址,偏移量为索引,产生计算期望的元素的偏移量。例如,对于用T D[R][C]定义的数组:
数组元素D[i][j]的内存地址为
定长数组
#define N 16
typedef int fix_matrix[N][N]
变长数组
当需要使用变长数组
综合

int A1[3][5]:3行5列的二维数组,每个元素都是int类型的整数int *A2[3][5]:3行5列的二维数组,每个元素都是int *类型的指针int (*A3)[3][5]:1个int *的指针,指向一个3行5列的未分配整数数组int *(A4[3][5]):3行5列的二维数组,每个元素都是int *类型的指针int (*A5[3])[5]:长度为3的int *指针数组,每个元素都是指向一个长度为5的int类型数组的指针

异质的数据结构
结构
结构(struct)的所有组成部分都存放在内存中一段连续的区域内,而指向结构的指针就是结构第一个字节的地址

- 字段存储顺序按照声明顺序,即使改变顺序可以让结构更紧凑
- 编译器决定总体大小和字段的位置
联合
联合(union)提供了一种方式,允许以多种类型来引用一个对象,但一次只能使用其中一个字段
联合的大小为其中最大字段大小
对齐
为什么要对齐?
- 如果不对齐,装载或存储数据可能会跨越四字边界,使得效率降低
- 如果数据块因为没对齐而跨越了2页的虚拟存储器那就更麻烦了
所以编译器会在结构中插入间隔以确保字段的正确对齐
怎样对齐?
- 对于最大对齐需求K,整体结构大小必须是K的整数倍
- 并且对于不同类型的数据,其起始地址必须是K的倍数。比如int类型的字段的起始地址必须是4的倍数。具体如:
| K | 类型 |
|---|---|
| 1 | char |
| 2 | short |
| 4 | int, float, unsigned |
| 8 | long, double, pointer |
为了节省空间,可以优先存放大的数据
溢出
C语言对数组引用不做边界检查,而且局部变量和状态信息都存放在栈中。这两种情况接到一起,就存在越界访问数组更改状态信息的情况
溢出会让程序执行它本身不愿执行的函数
防范攻击的方法
- 避免溢出漏洞
- 采用系统级防护:栈随机化、限制可执行代码区域、变长栈帧
- 让编译器使用栈金丝雀:在栈帧中任何局部缓冲区和状态信息之间存储一个金丝雀值,只要其被破坏就说明发生溢出
Chapter 4 处理器体系结构
本章将简要介绍处理器硬件的设计:去研究一个硬件系统执行某种ISA指令的方式,以更好地理解计算机是如何工作的
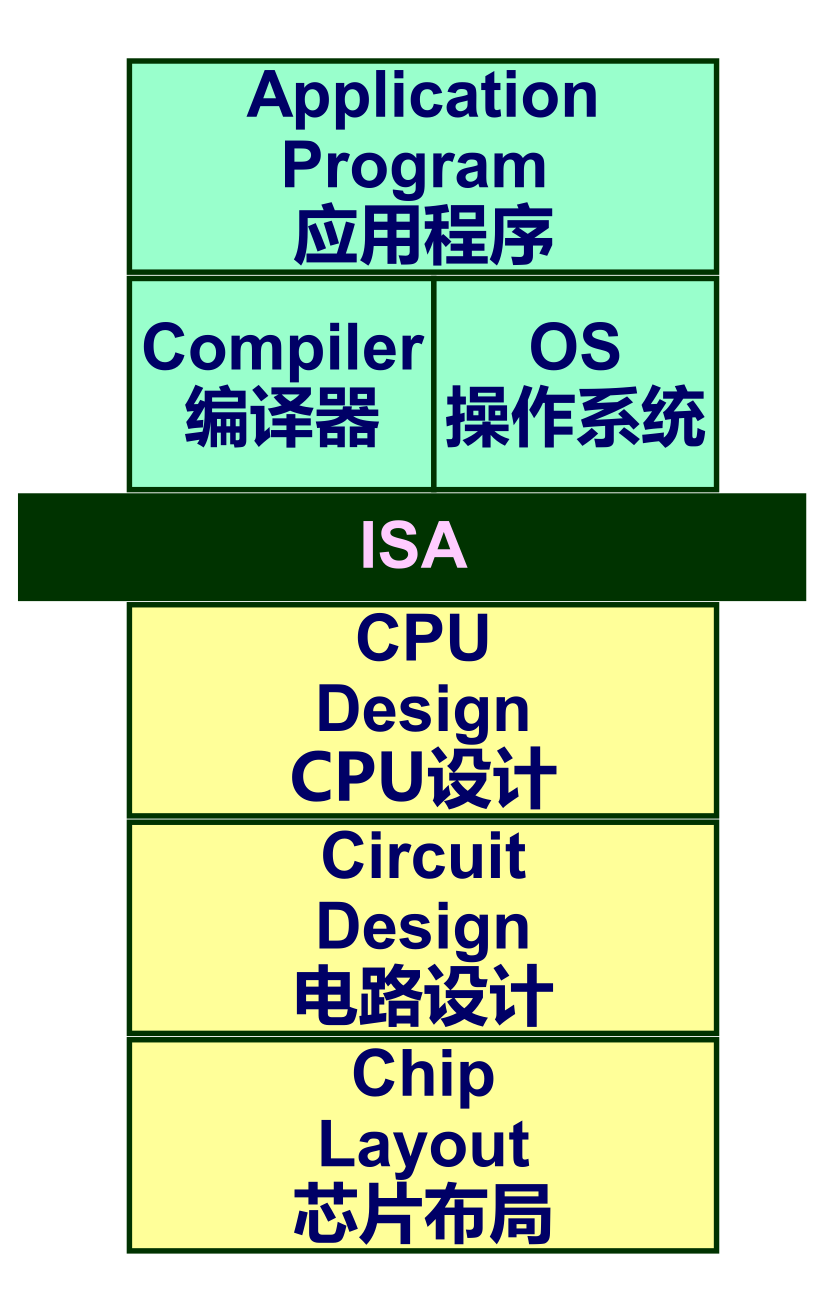
一个处理器支持的指令和指令的字节集编码称为它的==指令集体系结构==(ISA),它在编译器编写者和处理器设计人员之间提供了一个概念抽象层
- 汇编语言抽象:处理器支持的汇编语言
- 机器语言抽象:字节级表示
提供了真实计算机的一个抽象,隐藏了实现细节
- 计算机指令语法
- 指令语义
- 执行模式
- 程序员可见的计算机状态
ISA 规定了软件与硬件之间的边界,主要包括:
-
支持哪些指令 比如算术指令、逻辑指令、访存指令、跳转指令等
-
寄存器有哪些、每个多大 比如 x86-64 有通用寄存器 rax、rbx、rsp 等
-
指令如何访问内存 地址大小、对齐规则、字节序(大端/小端)
-
指令执行后的可观察行为 条件码如何改变,异常如何触发
-
对编译器、汇编程序、操作系统来说,ISA 就是全部的“处理器”。
本章要讨论的内容大概有这些:
- 首先会定义一个指令集——Y86-64,其相当于是一个x86-64的简化版
- 接下来提供一部分数字硬件设计的背景,并介绍HCL
- 然后课程会给出一个基于顺序操作、功能正确但是性能低下的Y86-64处理器
- 之后以顺序设计为基础,进行改造创建一个流水线化的处理器
Y86-64指令集体系结构
定义一个ISA,包括定义以下部分:
- 各种状态单元
- 指令集和他们的编码
- 一组编程规范
- 异常事件处理
状态
Y86-64程序中的每条指令都会读取处理器状态的某些部分,称为==程序员可见状态==:
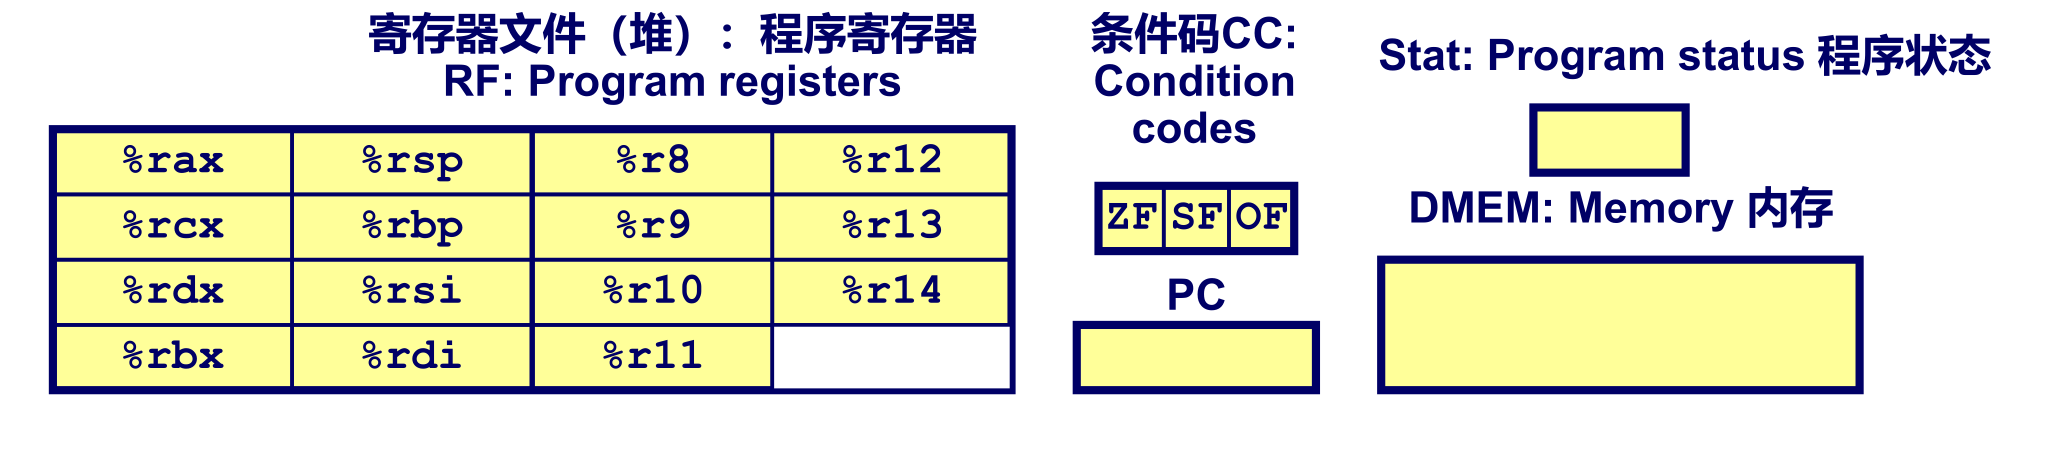
-
寄存器:Y86-64省略了x86-64中的%r15寄存器,除了寄存器%rsp被入栈、出栈、调用和返回指令作为栈指针,其他的寄存器没有固定含义
-
条件码:
-
ZF:是否为0
-
SF:正负
-
OF:溢出
-
-
程序计数器(PC):指明下一条指令地址
-
内存:保存程序和数据,指明正常运行还是一些错误情况
-
内存:字节寻址存储数组,“字”采用小端字节顺序存储
-
状态码:表明程序执行的总体状态——是否出现异常
Y86指令集
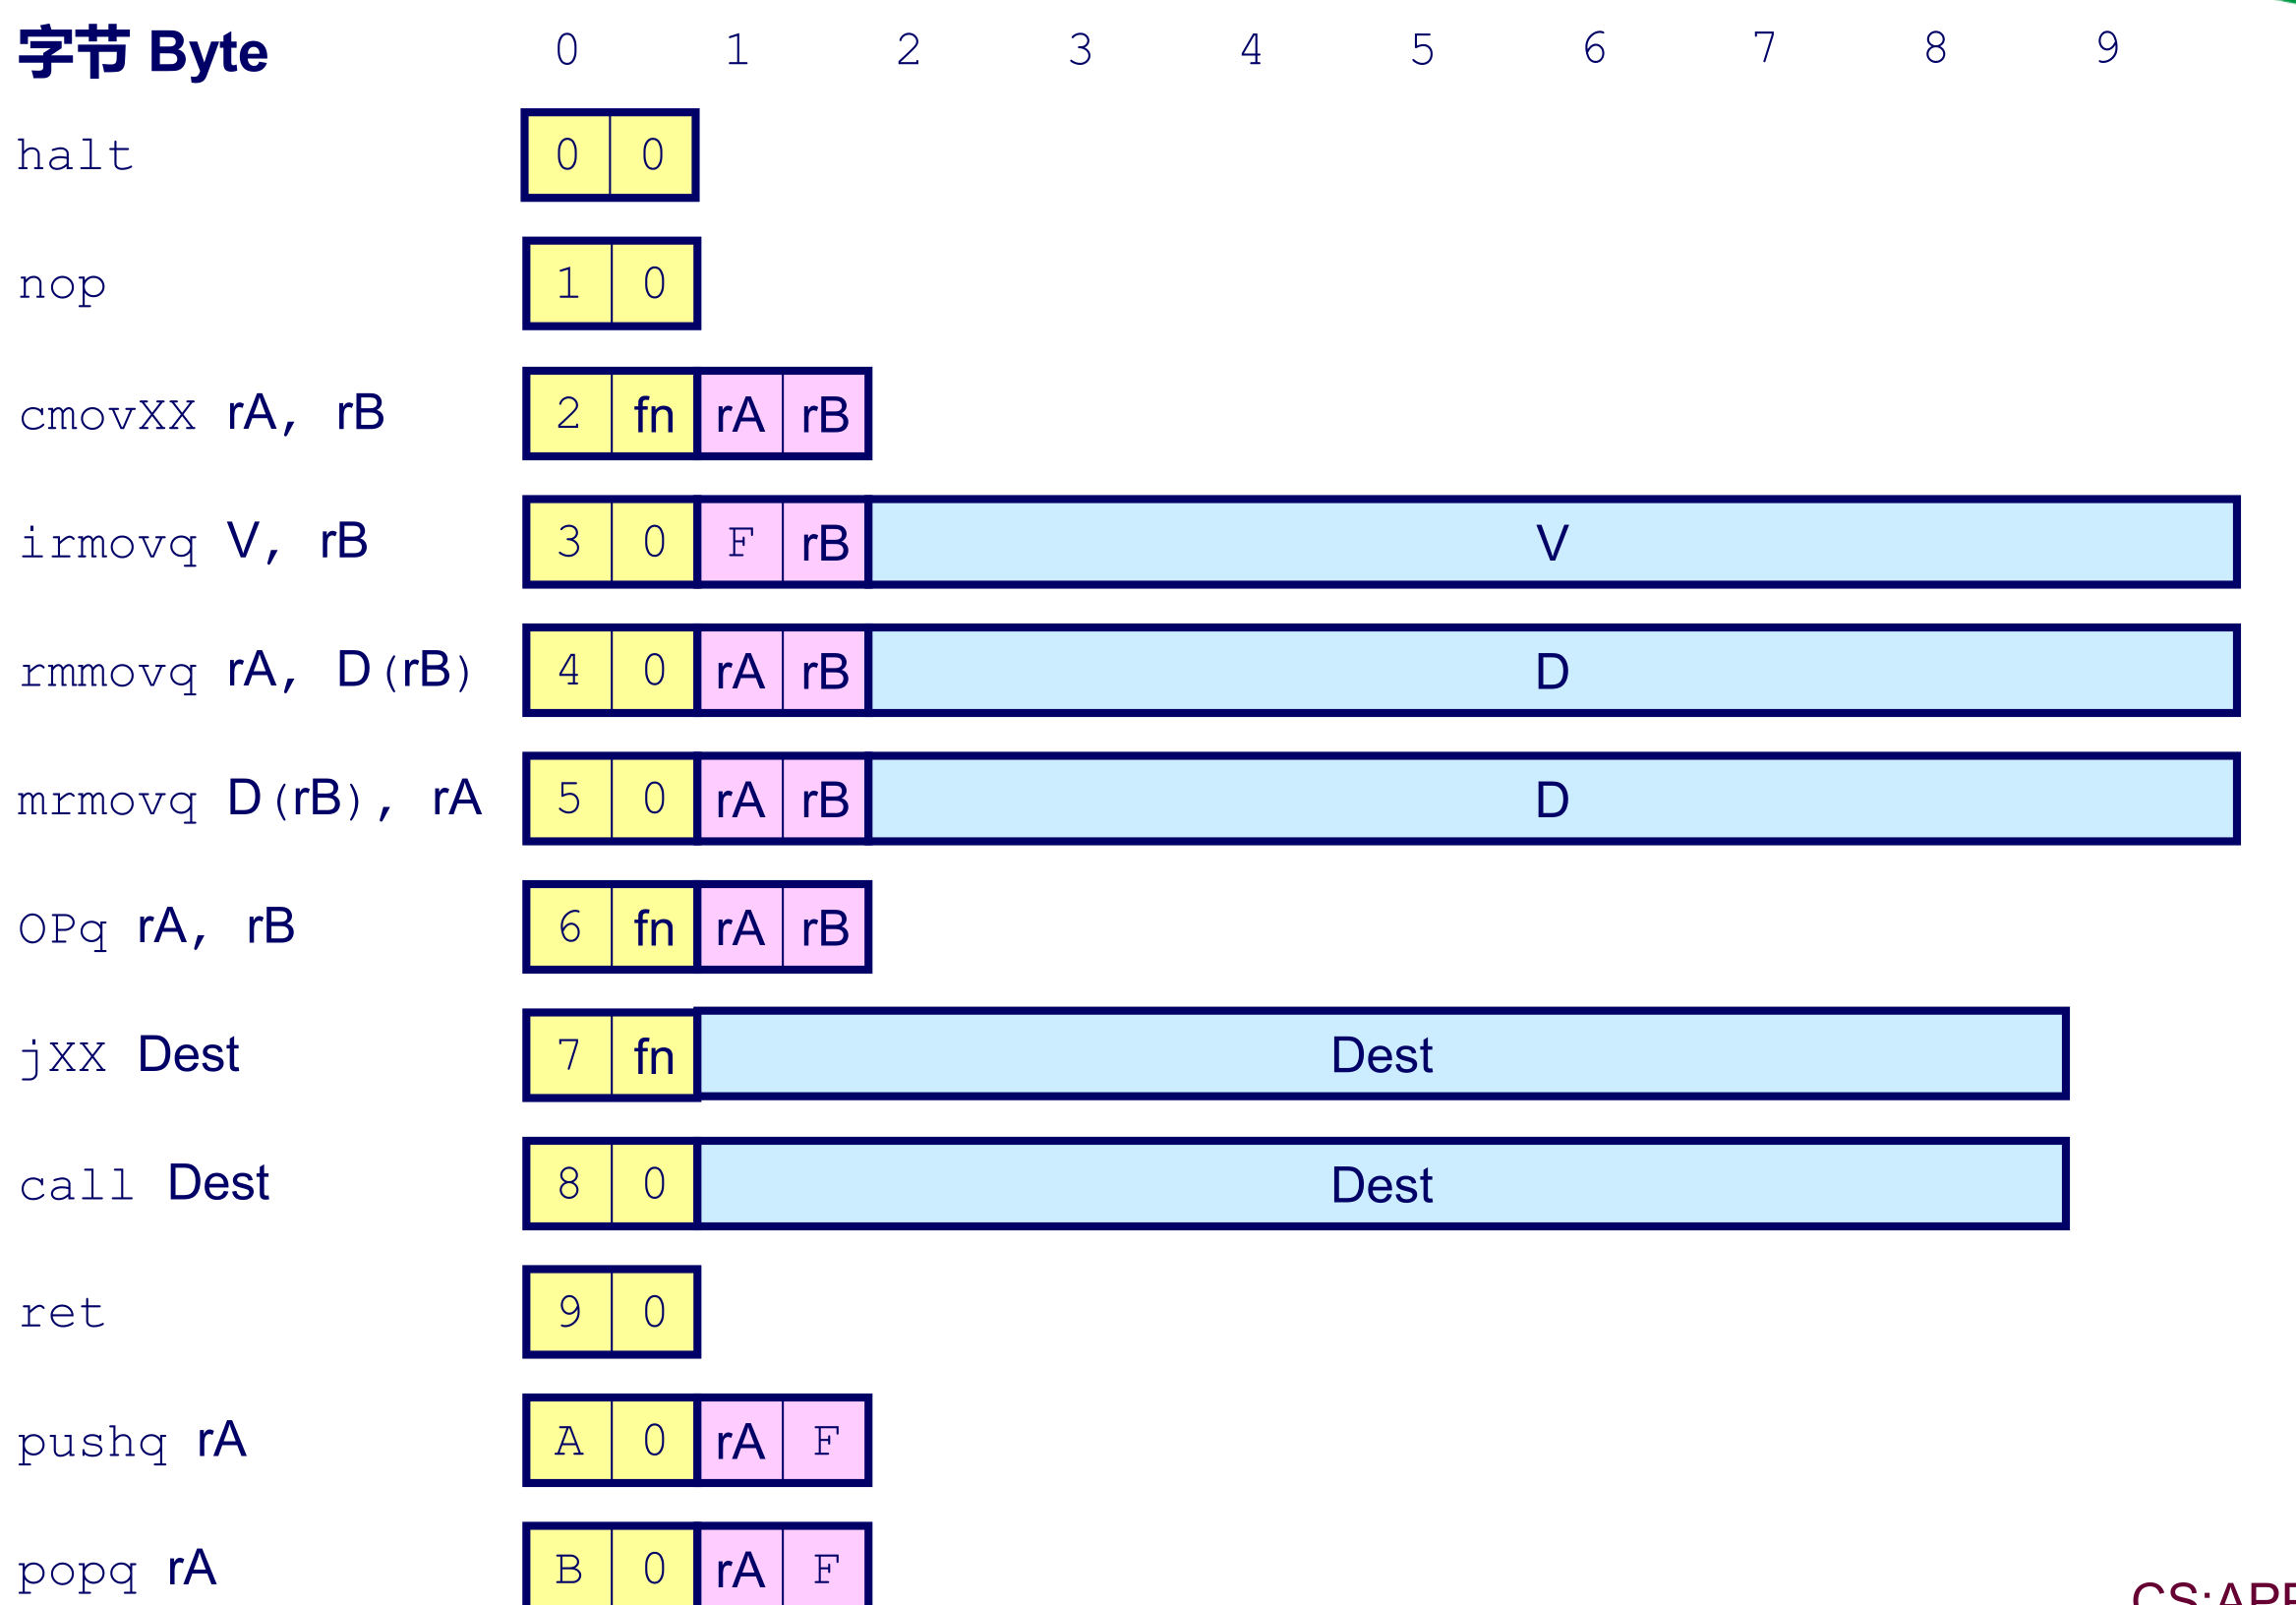
-
mov指令——xxmovq
与x86-64不同,movq指令被分成了4个指令:irmovq、rrmovq、mrmovq和rmmovq。他们显式的指定源与目的的格式:立即数(i),寄存器(r),存储器(m)
内存的引用方式包括基址和偏移量形式
第一个字是源,第二个是目的。
立即数(i)不能作为目的
-
整数操作指令——OPq
包括addq,subq,andq和xorq四个指令,只会对寄存器数据进行操作,并且会设置条件码ZF、SF和OF
-
跳转指令——jXX
与x86-64基本相同
-
条件传送指令——cmovXX
当满足条件XX时执行与rrmovq指令一样的效果
-
call、ret,pushq、popq指令
与x86-64相同
-
halt指令
停止处理器,并将状态码设置为HLT
指令编码
要编码一条指令,至少要做以下三件事:
- 编码指令类型
- 编码寄存器
- 编码常数
在Y86-64中,每条指令需要1-10个字节用于编码。每条指令的第一个字节用于表明指令的类型:这个字节的高4位为代码部分,低4位为功能部分。功能部分只有在一组相关指令共用一个代码部分时才会用到,如下图:
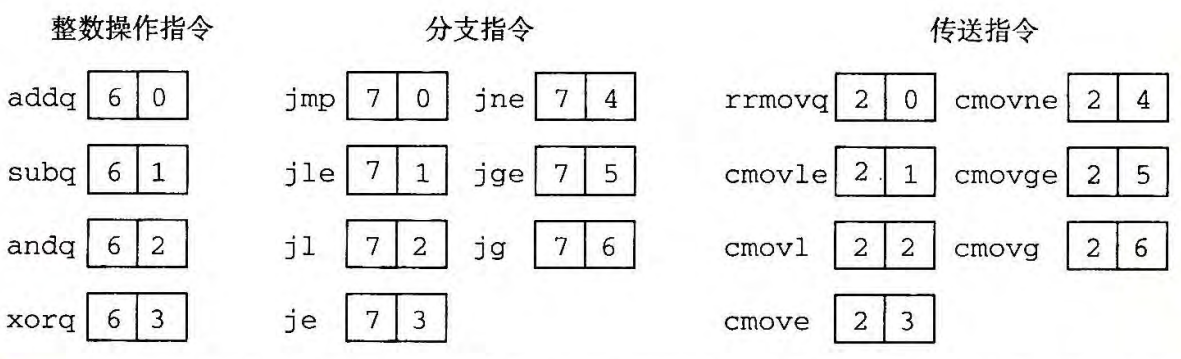
一部分指令只需要一个字节就能表示清楚,如ret指令;但是大部分指令还会涉及到常数(操作数)与寄存器,常数可以写进指令中,寄存器则需要我们专门编码。Y86-64中共有15个寄存器,4位bit即可将其全部编码。如图:
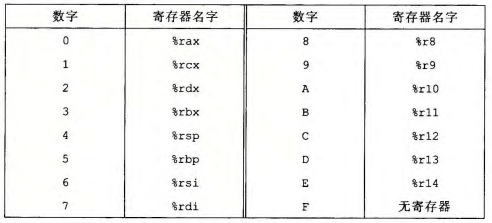
若一些指令只需用到一个寄存器,那么另外4位默认为0xF
有一些指令还需要附加一个常数字,这个字能作为立即数数据,也可以作为地址标识符的偏移量,或者是分支指令的地址(根据具体指令决定)。所有整数采用==小端法==编码,字节以相反的顺序出现
例如指令
rmmovq %rsp, 0x123456789abcd(%rdx)的编码为: 40 42 cd ab 89 67 45 23 01 00
对于每条指令的字节编码,我们必须要确保它只能有唯一的解释。Y86-64中每条指令的第一个字节有唯一的代码和功能组合,让处理器在得知第一个字节后就可以确定后面的其他的字节的长度与含义,保证了处理器可以无二意地执行目标代码程序
异常
Stat状态码描述程序执行的总体状态,在Y86-64中,它有以下这些取值:

对于Y86-64,当处理器遇到异常时,会简单的停止执行指令;而在完整的设计中,处理器会针对不同的异常调用不同的异常处理程序
逻辑设计与HCL
逻辑设计
逻辑设计指的是: 在不关心具体电路实现细节的前提下,用逻辑规则描述处理器各部件“应该如何工作”。
在 Y86 里,逻辑设计关注的不是晶体管,而是:
- 有哪些部件 程序计数器 PC、寄存器文件、ALU、内存、条件码
- 数据如何流动 哪个信号送到 ALU,结果写回哪里
- 控制信号如何产生 不同指令对应不同的控制选择
换句话说,逻辑设计回答的是:
给定当前状态和一条指令,下一步硬件状态应该是什么
例子:
以
addq rA, rB为例,逻辑设计要明确:
- ALU 的两个输入是什么 rA 的值、rB 的值
- ALU 做什么运算 加法
- 运算结果送到哪里 写回 rB
- 条件码是否更新 是
你会发现,这已经完全不关心:
- ALU 具体怎么加
- 寄存器内部怎么存
这就是逻辑层面的设计。
逻辑设计是体系结构和硬件实现之间的桥梁:
- 向上,对齐 ISA 确保每条指令语义正确
- 向下,可以直接映射为硬件电路 多路选择器、加法器、寄存器
硬件控制语言HCL
HCL(Hardware Control Language)是 CSAPP 为教学专门设计的一种硬件控制描述语言。
它不是用来“写程序”的,而是用来:
- 描述控制信号的产生规则
- 用类似 C 的条件表达式描述硬件选择逻辑
一句话概括:
HCL 是把“逻辑设计”写成一种可执行、可检查的形式
在HCL中,AND用 && 表示,OR用 || 表示,NOT用 ! 表示
HCL布尔表达式就是类似函数的一个式子,用若干个HCL布尔表达式即可以描述一个组合电路
按照返回值类型,HCL分为HCL布尔表达式与HCL字表达式
HCL布尔表达式
-
逻辑操作
如
result = a && b -
字比较
如
result = A == B -
集合关系
如
result = A in { B, C, D }(若A在集合{B,C,D}中则result为1,否则为0)
HCL字表达式
-
case表达式
语法为:
[
	select1 : expr1;
	select2 : expr2;
	.
	.
	.
	selectn : exprn;
]
该表达式会顺序检测表达式,输出第一个符合条件的结果
逻辑门与组合电路
简单的,逻辑门就是指与门、或门和非门;组合电路在数字逻辑中也学过,都略过。在这里只提一些组合电路与HCL的关系
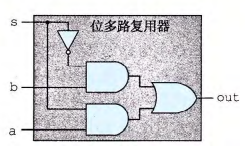
例如对于下图中的位级多路复用器,其HCL布尔表达式为:bool out = (s && a) || (!s && b)
对于下图的字级多路选择器,其HCL布尔表达式为:int Out = [ s : A; 1 : B; ]
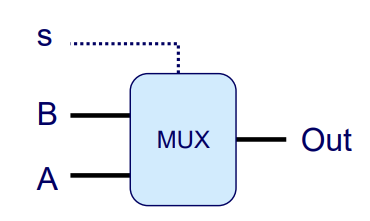
所谓的"字级多路选择器",就是数字逻辑中的"多路复用器",只不过输入是多个位,我们可以人为控制输入的位数是8,16,32,64位这种,使得输入以字节的形式组织
算术逻辑单元 ALU
根据输入的控制位,ALU可以对输入的X与Y进行不同的运算,并设置相应的条件码:

存储器和时钟
组合电路只能根据输入得出输出,无法存储信息。如果我们想要将信息存储,那就要使用时序电路
时序电路在数字逻辑中已经有过详细的介绍,如R-S锁存器、边沿触发器等。其中R-S锁存器我们可以通过将R与S置0来使得其保持上个状态;边沿触发器则只会在上升时钟时改变存储的数据,其他时间保持稳态
时钟寄存器
存储单个位或字,由时钟信号控制寄存器加载输入值。Y86-64使用时钟寄存器保存程序计数器PC、条件代码和程序状态Stat
如下图,时钟寄存器只有时钟上升沿时会把输入的值变成新的状态与输出,其他时间保持稳态

寄存器文件(属于SRAM)

如图,一个寄存器文件有两个读端口(A B)和一个写端口(W),可以同时读两个寄存器的值并更新一个寄存器的状态
-
读
将srcA或srcB设置成某个寄存器的ID,短暂延迟后对应寄存器的值就会出现在valA或valB
-
写
只会发生在每次时钟的上升沿,valW的值会被写入dstW所对应的寄存器;若dstW的值为0xF,则不会改变任何寄存器的值
Y86-64的SEQ实现
什么是 SEQ 实现
SEQ 是 Sequential implementation,也叫 单周期处理器。
处理一条指令需要很多操作,我们把它抽象为顺序的操作序列:取指、译码、执行、访存、写回与更新PC
SEQ核心思想只有一句话:
每一条 Y86-64 指令,在一个时钟周期内完成全部工作
这意味着:
- 取指、译码、执行、访存、写回
- 全部发生在同一个周期
- 周期必须“足够长”,能覆盖最慢指令
SEQ 的目标不是性能,而是逻辑清晰、便于理解
整体结构
可以把 SEQ 看成三个层次:
- 状态部件 PC、寄存器文件、条件码、内存
- 组合逻辑 指令解析、ALU 运算、地址计算、控制信号
- 时钟边界 周期结束时,状态一次性更新
一个周期的抽象流程是:
- 根据 PC 从内存取指
- 解析指令字段
- 计算结果和下一条 PC
- 在周期末写回寄存器 / 条件码 / PC
顺序结构的抽象视图:
顺序结构的硬件结构(蓝框为硬件块,灰框为控制逻辑):
SEQ 的数据通路组成
程序计数器 PC
- 保存当前指令地址
- 在周期结束时更新为
nextPC
nextPC 的来源可能是:
PC + 指令长度- 条件跳转目标
call的目标地址ret从栈中弹出的返回地址
指令内存
根据 PC 读出:
icode:指令类型ifun:指令功能码rA, rB:寄存器编号valC:立即数valP:顺序执行的下一条地址
这些字段只读,不修改内存。
寄存器文件
支持:
- 同时读两个寄存器(rA、rB)
- 同时写一个或两个寄存器(不同指令)
读出的值是:
valAvalB
写回发生在周期末。
ALU
ALU 在 SEQ 中承担多种角色:
- 算术运算 addq / subq / andq / xorq
- 地址计算 栈指针变化、访存地址
- PC 相关计算
PC + 1、PC + 9
通过控制信号选择:
- ALU 输入 A
- ALU 输入 B
- ALU 操作类型
数据内存
用于:
mrmovqrmmovqpushqpopqcallret
地址一般来自 ALU 输出。
条件码寄存器
包含:
- ZF
- SF
- OF
只在 OPq 指令中更新。
SEQ的阶段实现
取指
从内存读取指令字节,地址为PC的值。根据指令的第一个字节判断要取出的指令长度。
- 将读取出来第一个字节的高4位称为icode,低4位称为ifun
- 可能再取出一个寄存器指示符字节,指明rA和rB
- 还可能再取出一个8字节长度的常数valC
- 按顺序方式计算下一条指令的地址valP
指令可能包含的字段
| 字段 | 字节数 | 含义 |
|---|---|---|
| icode:ifun | 1 | 指令类型 + 功能 |
| rA:rB | 1 | 寄存器编号 |
| valC | 8 | 立即数 / 地址 |
但 不是每条指令都有全部字段。
电路实现示意图:

从控制逻辑上来看,该电路会判断指令是否合法、地址是否合法(imem_error)、指令是否有寄存器或常量字
译码与写回
这两个阶段因为都要访问寄存器文件,所以将他们放在一起
- 译码阶段根据取指阶段得到的icode、rA与rB,从寄存器文件读入最多两个操作数,得到值valA或valB
- 写回阶段可以将最多两个结果valE与valM写回到寄存器文件中dstE与dstM指定的寄存器
指令halt, nop, jXX, call, ret不需要译码,同理,不需要写寄存器或更改栈指针的指令也不需要写回
电路实现示意图:

控制逻辑:
-
srcA:根据icode和rA得出srcA用于读指令
-
srcB:根据icode和rB得出srcB用于读指令
-
dstE:根据icode, rB和Cnd得出dstE
-
dstM:根据icode, rA和Cnd得出dstM
dstE和dstM为0xF时无需更新寄存器的值
只有popq指令会同时用到寄存器文件的两个写端口
信号:
- Cnd:指明是否执行条件传送,在执行阶段产生
执行
在执行阶段,输入的icode和ifun会设置信号alufun,ALU会根据该信号决定执行具体执行哪种运算,并将计算得到的结果设置成valE,并且valE在不同指令下有不同的计算方式与含义,具体如表格:
| 指令 | OPq rA,rB | comvXX rA,rB | rmmovq rA,D(rB) | popq rA | call Dest | ret |
|---|---|---|---|---|---|---|
| valE的值 | valB OP valA | valA | valB + valC | valB + 8 | valB - 8 | valB + 8 |
| valE的含义 | 运算结果 | 要传送的寄存器 | 目标内存地址 | 新的栈指针 | 新的栈指针 | 新的栈指针 |
执行阶段还要设置条件码,但是我们希望只有OPq指令会设置条件码,所以用信号set_cc来控制是否更新寄存器
除此以外,执行阶段还会输出一个计算条件/传送信号Cnd,它根据功能码和条件码设置,在写回阶段控制更改寄存器的值实现条件传送,在更新PC阶段控制更改PC值实现程序跳转
电路示意图:

访存
访存阶段可以将数据写入内存或将数据从内存读出,读出的值称为valM
电路示意图:

-
Mem.read与Mem.write两个控制块产生该阶段是读内存还是写内存的信号
-
内存读和写的地址总是valA或valE,由Mem.addr决定;内存写的内容总是valA或valP,由Mem.data决定
例如rmmovq指令会将valA的值写入valE指向的内存地址;popq指令会读出valA指向的内存地址的值;而call指令是把valP写入valE指向的内存地址
-
最后根据取指阶段产生的instr_valid, imem_error, icode与访存阶段dmem_error信号来计算状态码Stat
更新PC
根据icode, Cnd, valC, valM, valP将PC设置成下一条指令的地址

word new_pc = [
	icode == ICALL : valC;
	icode == IJXX && Cnd : valC;
	icode == IRET : valM;
	1 : valP;
]
指令跟踪
irmovq V, rB语义:把立即数 V 写入 rB
执行过程:
- 取指 读出
valC = V- 译码 rB 是目标寄存器
- 执行 ALU = valC + 0
- 写回 rB ← ALU 结果
- PC 更新 PC ← valP
关键点:
- ALU 只是“中转站”
- 不访问数据内存
- 不更新条件码
addq rA, rB语义:rB ← rB + rA
执行过程:
- 取指 得到 rA, rB
- 译码 valA ← rA,valB ← rB
- 执行 ALU = valB + valA
- 条件码 更新 ZF/SF/OF
- 写回 rB ← ALU
- PC 更新 PC ← valP
关键点:
- ALU 同时负责计算和设置条件码
- SEQ 中没有“阶段分离”
mrmovq D(rB), rA语义:rA ← Mem[rB + D]
执行过程:
- 取指 得到 D
- 译码 valB ← rB
- 执行 ALU = valB + D
- 访存 valM ← Mem[ALU]
- 写回 rA ← valM
- PC 更新 PC ← valP
关键点:
- ALU 负责地址计算
- 数据内存只读
call Dest语义:
- rsp ← rsp - 8
- Mem[rsp] ← valP
- PC ← Dest
执行过程:
- 取指 得到 Dest、valP
- 译码 valB ← rsp
- 执行 ALU = rsp - 8
- 访存 Mem[ALU] ← valP
- 写回 rsp ← ALU
- PC 更新 PC ← Dest
关键点:
- 同时写寄存器和内存
- PC 不是 valP
ret语义:
- valM ← Mem[rsp]
- rsp ← rsp + 8
- PC ← valM
执行过程:
- 译码 valA ← rsp
- 执行 ALU = rsp + 8
- 访存 valM ← Mem[rsp]
- 写回 rsp ← ALU
- PC 更新 PC ← valM
关键点:
- PC 来自内存
- SEQ 中 ret 非常慢(也是设计难点)


各指令在各阶段:
- 所有指令都需要取指、执行和更新PC三个阶段
irmovq和jXX指令不需要译码阶段,因为它们不需要读取寄存器/内存中的值OPq、rrmovq、irmovq、jXX都不需要访存阶段,因为它们不需要读取内存中的值rmmovq、jXX指令不需要写回阶段,因为它们不需要更新寄存器里的值
特殊的指令:
- 注意
call和ret指令虽然指令中没有寄存器,但是需要译码,因为它们需要对%rsp进行修改 call和pushq指令都要读一个%rsp的值到valB中,用于减小栈指针- 注意
ret/popq指令在译码阶段读出两个%rsp,valA用于在栈中读出栈底数据;valB用于增加栈指针 popq指令在写回阶段要写回两个寄存器的值jXX在执行阶段不计算valE,只计算Cnd
SEQ时序
SEQ的实现包含组合逻辑与一些存储器:其中的组合逻辑如ALU,它只是根据输入得出输出,没有时序;但是跟存储有关的硬件单元,我们就要对他们的时序给出明确的控制,所有元件的更新全部在时钟上升沿时发生:
-
PC:每个时钟周期都会装载新的指令地址
-
Stat
-
CC:只有在执行OPq指令时才装载条件码寄存器
-
内存:只有在执行rmmovq, pushq和call指令时才会写数据内存
-
寄存器文件
每个周期开始时,以上的这些状态单元是根据前一条指令设置的;在本周期,信号传播通过组合逻辑创建出新的状态单元的值,在下一个周期开始时加载到状态单元中
组织计算的原则:从不回读
处理器从来不需要为了完成一条指令而去读由该指令更新了的状态
SEQ小结
这样设计处理器,可以完成一条条指令,但是它有显著的缺点:
- 太慢了,时钟必须非常慢才能让信号在一个周期内传播所有阶段
- 硬件单元利用率低,只在整个时钟周期的一部分时间被使用
流水线 Pipeline原理
Pipeline可以提高系统的吞吐量,但也会轻微的增加延迟
SEQ:
- 一个周期完成一条完整指令
PIPE:
- 一个周期只做一个阶段
- 多条指令并行
PIPE = 把 SEQ 的组合逻辑拆开,加寄存器串起来
非流水线系统与流水线系统比较
在非流水线系统中,开始一个指令之前必须先完成前一个。在如下图的系统中,完成组合逻辑需要300ps,还需要20ps把结果保存在寄存器中。延迟即为完成这条指令的总时间320ps,吞吐量为延迟的倒数即3.12GIPS

接下来把计算分成A B C三个阶段,每个阶段需要100ps,并在各个阶段之间增加==流水线寄存器==,使得每条指令都会经过3个阶段,==阶段的转移由时钟控制==,需要3个时钟周期。在这样的流水线系统中,只要一个指令完成一个阶段,下一个指令就可以进入。将这个系统流水线化,延迟增加了40ps,但是吞吐量翻了两倍不止

流水线的局限性
不一致划分
在上面的理想流水线系统中,A B C三个阶段的延迟相等;但是在实际的系统中,这几个阶段的延迟可能不同,甚至相差很大。如果流水线的多个阶段中有阶段很慢,那么时钟周期也要根据最慢的阶段而变慢,这样子系统就会出现空闲,降低吞吐量
例如,若阶段A延迟为50ps,阶段B延迟为150ps,阶段C延迟为100ps:

所以在设计流水线系统时,要尽可能的让每个阶段的延迟相同或接近,以达到更高的吞吐量
流水线深度影响收益
前面我们说要把每个阶段的延迟划分的相近,那直接把每个阶段划分的都比较短是不是就可以了?且看下图描述的流水线系统:
该流水线系统实现的功能与前面的几个系统一样,其吞吐量很高,但是延迟占到了整个时钟周期的28.6%
为了提高时钟频率,现代处理器采用了很深(15或更多阶段)的流水线
带反馈的流水线
到此为止我们设计的流水线系统都没有考虑==相邻两条指令的相关性==,而实际的指令执行过程中相邻的指令之间很可能会存在数据相关,这时简单的流水线系统设计就可能产生错误的结果!
所以在真正的流水线系统的实现中,我们必须以某种方式来处理指令间的数据和控制相关,以保证流水线的正确运行,并且还要最小化对性能的影响
Pipeline 实现
这是本章的终极目标:设计一个流水线化的Y86-64处理器
SEQ+
在实现流水化之前,先对SEQ进行微调:更新PC阶段在一个时钟周期的开始时执行。这种修改过的设计称为==SEQ+==
变为
相比SEQ直接用信号的值计算PC并存储,SEQ+用寄存器存储上一个时钟周期内的icode、cnd等,并在新的周期时采取和SEQ同样的逻辑计算当前的PC
插入流水线寄存器
在各个阶段之间插入流水线寄存器:
-
F:保存PC的预测值
-
D:处于取指和译码阶段之间,保存最新取出的指令的信息
-
E:位于译码和执行阶段之间,保存关于最新译码的指令和从寄存器文件读出的值的信息
-
M:位于执行和访存阶段之间,保存最新执行的指令结果
-
W:位于访存和反馈路径之间,反馈路径将计算出来的值提供给寄存器文件写,而当完成ret指令时,它还要向PC选择逻辑提供返回地址
得到"PIPE-"处理器:

因为同一时间会有多个指令在被执行,那么同一个值例如stat就可能会有多个版本。为了区分这些不同的版本,作出以下规定:
- 对于保存在流水线寄存器中的值
以大写字母F D E M W作为前缀,如F_stat, D_stat
- 对于在执行阶段逻辑计算得到的值
以小写字母f d e m w作为前缀,如f_stat, d_stat
如图,在译码阶段之后,为了确保写端口的地址和数据是来自同一条指令,dstM和dstE会在流水线寄存器中被指令携带到写回阶段
PIPE-相比SEQ+多了一个"Select A"块,他会从流水线寄存器D中的D_valP和译码阶段读出的d_valA中选择出一个,把它存储到寄存器E中作为E_valA,为什么能这样操作呢?因为只有call指令与jXX指令在后续会用到valP,而这两个指令都用不到译码阶段,也不会读出valA。所以把valP与valA合并为同一个信号穿越流水线,可以减少流水线寄存器的数量
数据冒险
当相邻的两条指令,其中一条指令会用到另一条指令的计算结果时,我们称这两条指令==数据相关==。数据相关可能导致计算错误,我们称为==数据冒险==
有多种方法避免冒险:
-
==暂停==
把一条指令阻塞在译码阶段,直至产生它的源操作数的指令通过了写回阶段
阻塞的方式称为"气泡"(bubble),可以理解为动态插入的nop,关于气泡的详细介绍会放在后面的Pipeline的控制逻辑中
-
==转发==
将结果值从一个流水线阶段传到较早阶段的技术称为==数据转发==
例如三条连续指令:
irmovq $10,%rdx,irmovq $3,%rax,addq %rdx,%rax分别设为指令A B C当指令C位于译码阶段时,指令A位于访存阶段,指令B位于执行阶段
若采用转发的方式,只需要将M_valE与e_valE发送给译码阶段替代D_valA和D_valB,指令C即可正确执行
-
==加载互锁==
将暂停与转发结合起来,避免加载/使用数据冒险
这种方法针对加载/使用数据冒险,这类数据冒险是因为一条指令的源操作数需要上一条指令从内存读出,由于读出这个值的时机已经到了访存阶段而这个值在下一条指令的译码阶段就要使用,所以仅凭转发无法避免数据冒险,必须与暂停相结合
以上的三种方法都需要额外添加控制逻辑,比如是否需要暂停的判断、转发的值与目标的决策等。这里只介绍应对方法,相关硬件实现在Pipeline控制逻辑中有详细解释
PC预测
首先,为什么我们要预测PC而不是计算准确的PC呢?
举个例子,ret指令:该指令只有到访存阶段得到valM之后才能确定下一个PC的值。但是从取出ret指令到访存阶段,要经历三个时钟周期,那在这三个时钟周期里系统就干等着什么都不干么?如果这样的话系统的利用率将会大大下降。所以,我们要尝试预测PC的值以期待系统每个时钟周期都能有一条指令进入。不过,任何对于PC的猜测都有可能会失败,我们必须以某种方式来处理预测错误,并选择成功率尽可能高的==分支预测策略==
分支预测策略
在本章的设计中,使用总是选择分支的预测策略:
-
对于
call与jmp指令预测下一个PC为valC,这种预测总是可靠的
-
对于条件跳转指令(除了
jmp的jXX指令)预测下一个PC为valC,大概有60%的正确率
-
对于
ret指令不进行预测,遇到ret指令时等到他执行完成访存阶段再读下一条指令
-
对于其他指令
不会发生跳转,预测下一个PC为valP,这种预测总是可靠的
控制冒险
当上一条指令要确定下一条指令的位置时,我们称这两条指令==控制相关==。控制相关可能导致计算错误,我们称为==控制冒险== 控制冒险只会发生在ret指令与条件跳转指令中,因为在这两种情况下我们对下一条指令位置的预测是不准确的,接下来针对这两种指令进行处理:
ret指令
取指阶段 F:暂停stall
译码阶段 D:气泡bubble
对于 ret 指令,由于返回地址要到访存阶段才能得到,流水线在 ret 指令执行期间会暂停取指阶段,防止取入错误的指令,从而引入若干个气泡。
条件跳转指令(jXX,jmp,call)
取指阶段 F:气泡bubble
译码阶段 D:气泡bubble
对于条件跳转指令,我们到执行阶段才会知道预测的PC是否正确;而运行到执行阶段时,已经有两条指令被读入流水线系统,如果预测失败,那么这两条指令就是错误的指令,它们一个执行到译码阶段,一个执行到取指阶段
处理这个错误也不是特别麻烦,因为两条指令都还没到执行阶段,所以只需要在流水线系统中的取指和译码阶段插入气泡,并同时取出跳转指令后面的指令(因为我们的预测策略是总是跳转),这样两条预测错误的指令就会从流水线中消失,损失是两个时钟周期
异常
处理器中很多事情都会导致异常控制流,破坏程序的正常流程。在Y86-64中,由三种不同的内部产生的异常:
- halt指令
- 非法指令和功能码组合的指令
- 取指或数据读写试图访问一个非法地址
在流水线化的系统中,异常处理包括一些细节问题
- 可能同时有多条指令会引起异常
- 一条指令导致了异常,但是后来由于分支预测错误取消了该指令
- 一条指令导致了一个异常,它后面的指令在异常指令完成之前改变了部分状态
对于异常指令我们期望:异常指令之前的指令全部正确完成,并且后面的指令对程序可见状态没有影响
Pipeline的阶段实现
PC与取指
这一阶段选择PC的当前值,并预测下一个PC值

- 当ret指令进入写回阶段时,SelectPC = W_valM
- 当预测错误的指令进入访存阶段时,SelectPC = M_valA
- 其他情况下,SelectPC = F_predPC
译码与写回
显而易见的,相比SEQ+,他多了两个块:"Set+Fwd A"和"Fwd B"。其中"Set+Fwd A"实现了valA与valP的合并和转发的逻辑,"Fwd B"实现了转发的逻辑

转发时我们要设置对应的==优先级==,简单来说就是==执行 > 访存 > 写回,valE > valM==
为什么要设置优先级呢?举个例子
指令A是
irmovq $1,%rax,指令B是irmovq $2,%rax,指令C是irmovq $3,%rax,指令D是addq %rbx,%rax。指令按ABCD的顺序执行,当指令D执行到译码阶段时,指令ABC都会向其转发信号,但显然我们应该用离指令D最近的那个。这就是优先级的意义所在,它确保了流水线的正确性
因为转发的选择逻辑比较复杂,在这里给出valA的HCL表达式:
int d_valA =[
	D_code in { ICALL, IJXX }  :  D_valP;
	#左侧判断条件是判断寄存器ID,右侧是数据字
	d_srcA == e_dstE  :  e_valE;	# ALU输出
	d_srcA == M_dstM  :  m_valM;	# 内存输出
	d_srcA == M_dstE  :  M_valE;	# 访存阶段对端口E未进行的写
	d_srcA == W_dstM  :  W_valM;	# 写回阶段对端口M未进行的写
	d_srcA == W_dstE  :  W_valE;	# 写回阶段对端口E未进行的写
	1  :  d_rvalA;
]
其实看到这里就能发现,转发的实现用一句话概括就是:检测在执行阶段以上的指令是否会改变在译码阶段的指令要读的寄存器的值,若是则用其他指令得到的值,若否则一切照常
执行阶段
与SEQ的执行阶段非常相似,区别是SetCC增加了输入W_stat和m_stat,决定是否要更新条件码。因为我们不希望异常的指令去更新条件码

访存阶段
与SEQ的设计基本相同

最终我们得到了流水线化的最终实现:

Pipeline控制逻辑
在前面的Pipeline设计中,我们在硬件上设置了转发解决了部分数据冒险。但是,对于加载/使用数据冒险、控制冒险和异常还没有检测与处理
所以现在我们要设计一个Pipeline控制逻辑来负责发现并解决这几种特殊情况,不过我们首先要详细的谈一下气泡
stall and bubble(暂停与气泡)
为流水线寄存器添加两个控制输入:暂停(stall)和气泡(bubble),两个控制输入的缺省值为0且认为两个信号同时为1是错误的情况
-
暂停状态:禁止更新状态,也就是寄存器会保持它以前的状态
-
气泡状态:将寄存器设置成一个固定的复位配置,icode设为INOP,其他字段设为常数RNONE

在这样子设置之后,流水线寄存器就被我们分成了加载、暂停与气泡三种状态
特殊控制条件
想要控制那些特殊情况,首先要知道在哪些条件下会出现,这里直接给出表格
| 条件 | 触发条件 |
|---|---|
| 加载/使用冒险 | E_icode in {IMRMOVq,IOPq} && E_dstM in {d_srcA, d_srcB} |
| 处理ret | IRET in { D_icode, E_icode, M_icode } |
| 预测错误的分支 | E_icode == IJXX && !e_Cnd |
| 异常 | m_stat in { SADR, SINS, SHLT } || W_stat in {SADR, SINS,SHLT} |
不难发现只有在E中指令是mrmovq或者popq时才有可能出现加载/使用冒险
特殊控制处理
| 状况 | F | D | E | M | W |
|---|---|---|---|---|---|
| 加载/使用冒险 | 暂停 | 暂停 | 气泡 | 正常 | 正常 |
| 处理ret | 暂停 | 气泡 | 正常 | 正常 | 正常 |
| 分支预测错误 | 正常 | 气泡 | 气泡 | 正常 | 正常 |
加载/使用冒险
触发加载/使用冒险之后,在下个周期向E插入一个气泡,并将F和D暂停。此时加载指令位于M,使用指令位于D,正常允许便可以在这个周期把在m阶段中读出的数据转发给d阶段
ret指令
触发ret之后,向译码阶段插入气泡。因为ret的触发条件总是会被连着触发三个时钟周期,所以也总是会连着三个时钟周期向译码阶段插入气泡
分支预测错误
当触发分支预测错误时,在下一个时钟周期向执行阶段与译码阶段添加气泡。相当于把取消掉两条不正确的指令
异常
当异常发生时,记录stat信息,然后继续指令,但是做出以下限制:
- 禁止执行阶段中的指令设置条件码
- 向访存阶段插入气泡,以禁止向数据内存中写入
- 当协会阶段有异常指令时,暂停流水线
控制条件的组合
目前我们对特殊控制的处理都是基于“一个时钟周期只出现一种特殊情况”,但是如果一下出现多种了呢?下面我们进行分析:
- 加载/使用冒险要求执行阶段中的指令把一个值从内存读到寄存器中同时译码阶段中的指令要以该寄存器为源操作数
- 预测错误要求执行阶段中的指令是
jXX ret要求D或E或F中的指令是ret指令

根据上面的图,我们很容易发现特殊情况在大部分情况下都是互斥的,比如加载/使用冒险跟上图中的ret2和ret3不可能同时出现;jXX不会把一个值从内存读到寄存器中,所以预测错误和加载/使用冒险也不可能同时发生
可能同时发生的只有:
-
预测错误和ret 1
这种情况预测错误紧跟着ret,那么ret这条指令本身就是错误的,那么要暂停F寄存器,并在D和E寄存器插入气泡
条件 F D E M W 处理ret 暂停 气泡 正常 正常 正常 预测错误的分支 正常 气泡 气泡 正常 正常 组合 暂停 气泡 气泡 正常 正常 从上面的这个表格可以看出来,只需要同时触发预测错误和ret处理就可以正确处理这种情况
-
加载/使用冒险和ret 1
简单的将两种处理叠加并不能得到我们想要的结果,所以这种情况应当特殊处理,也就是阶段D在遇到这种特殊情况的组合时要输出暂停信号,具体的HCL表达式在下面给出
条件 F D E M W 处理ret 暂停 气泡 正常 正常 正常 加载/使用冒险 暂停 暂停 气泡 正常 正常 组合 暂停 气泡+暂停 气泡 正常 正常 期望 暂停 暂停 气泡 正常 正常
bool D_bubble =  (E_icode == IJXX && !e_Cnd)  ||	# 预测错误
				!(E_icode in {IMRMOVQ, IPOPQ} && E_dstM in {d_srcA, d_srcB}) &&	# !加载/使用冒险
				IRET in {D_icode, E_icode, M_icode};	# ret
控制逻辑的实现

性能分析
流水线设计完了,那我们怎么衡量流水线的性能呢?使用==CPI==(每指令周期数)
因为遇到特殊控制情况时,我们的流水线会暂停或者插入气泡,那这就导致每个周期的平均执行时间是大于1个时钟周期的。下面看看CPI的计算方法:
是加载处罚,是由于加载/使用冒险造成暂停时插入气泡的平均数 是预测错误分支处罚,是是由于预测错误取消分支时插入气泡的平均数 是返回处罚,是由于ret指令造成暂停时插入气泡的平均数
Chapter 5 优化程序性能
编写高效程序要做到以下三点:
- 选择适当的算法和数据结构
- 必须编写出编译器能够有效优化以转换成高效可执行代码的源代码
- 并行计算
表示程序性能
想要优化程序性能,首先要有一个定量衡量程序性能的标准。为此,我们引入度量标准==每元素的周期数(CPE)==,作为一种表示程序性能并指导我们改进代码的方法
常见优化措施
代码移动
识别要执行多次但是计算结果不会改变的计算,然后将这类计算移动到代码前面不会被多次求值的部分
例子:
//初始版本
for(int j=0; j<n; j++){
    a[n*i+j] = b[j];
}
//代码移动
int ni = n * i;
for(int j=0; j<n; j++){
    a[ni+j] = b[j];
}
//O1优化
long ni = n*i;
double *rowp = a+ni;
for (int j = 0; j < n; j++){
    *rowp++ = b[j];
}
代码移动是与机器无关的,任何机器上避免重复的操作都是对程序的优化
计算强度削弱
使用简单的操作代替复杂操作。比如使用移位与加法代替乘法和除法
例如:
//初始版本
for(int i=0; i<n; i++){
    int ni = n*i;
    for(int j=0; j<n; j++){
        a[ni+j] = b[j];
    }
}
//计算强度削弱
int ni = 0;
for(int i=0; i<n; i++){
    for(int j=0; j<n; j++){
        a[ ni+j ] = b[j];
    }
    ni += n;
}
上面的优化把每次循环都要执行的乘法变为了加法
公共子表达式删除
重复利用表达式的一部分
//初始版本
up = val[(i-1)*n + j ];
down = val[(i+1)*n + j ];
left = val[i*n + j-1];
right = val[i*n + j+1];
sum = up + down + left + right;
//公共子表达式删除
long inj = i*n + j;
up = val[inj - n];
down = val[inj + n];
left = val[inj - 1];
right = val[inj + 1];
sum = up + down + left + right;
减少过程调用
看下面一段代码:
for(int i=0; i<strlen(s); i++){
	if (s[i] >= 'A' && s[i] <= 'Z')
		s[i] -= ('A' - 'a');
}
在循环的条件检测时调用了函数strlen。但是该函数是一个时间复杂度为
如果把代码改成这样:
int len = strlen(s);
for(int i=0; i<len; i++){
	if (s[i] >= 'A' && s[i] <= 'Z')
		s[i] -= ('A' - 'a');
}
所以在代码中,要尽量避免过程调用。不仅如此,编译器很少会针对过程调用做优化,这要求程序员在写程序时就要想到这个问题并做出优化
消除不必要的内存引用
内存别名
两个或多个不同的指针指向同一个位置
因为有多个指针指向同一个位置,那么这个位置也就可以被多个指针修改。那么假设我在时刻A使用指针甲读出了该位置的值,那哪怕就在下一个紧挨的时刻B,编译器也无法判断上一个时刻读出的值还是否与该位置的值相等。如果要再次用到该值,必须重新读
内存别名导致了在使用指针指向的值时,每次用都需要重新读,即使在此期间没有该值没有任何更改。那么显然这对程序的效率会产生影响
优化
//把结果累计在指针dest指向的位置
void combine3(vec_ptr v, data_t *dest){
	long length= vec_length(v);
	data_t *data= get_vec_start(v);
	*dest = IDENT;
	for (int i = O; i < length; i++){
		*dest = *dest OP data[i];
    }
}
//把结果累计在局部变量ace
void combine4(vec_ptr v, data_t *dest){
	long length= vec_length(v);
	data_t *data= get_vec_start(v);
	data_t acc = IDENT;
	for (int i = O; i < length; i++){
		acc= ace OP data[i];
	}
	*dest = acc;
}
函数combine4相比函数combine3,看似区别只是前者结果存在局部变量中,后者结果存在指针指向的地址。但事实并不是这样,下面是两个函数的汇编代码:
# combine3汇编
.L17:
	vmovsd (%rbx) , %xmm0
	vmulsd (%rdx), %xmm0
	vmovsd %xmm0, (%rbx)
	addq   $8, %rdx
	cmpq   %rax, %rdx
	jne    .Ll7
# combine4汇编
.L25:
	vmulsd (%rdx) , %xmm0, %xmm0
	addq   $8, %rdx
	cmpq   %rax, %rdx
	jne   .L25
仔细分析,函数combine3在每次循环需要读两次并写一次,而函数combine4只需要一次读。CPE差距:

针对内存别名这种情况,编译器很难进行优化,需要程序员在写程序时多加留意
指令级并行
首先介绍两种概念:
- 延迟界限:当操作严格按照顺序执行,并且数据相关限制处理器利用指令级并行的能力时,延迟界限能够限制程序性能
- 吞吐量界限:刻画处理器单元的原始计算能力,是程序性能的终极界限
乱序处理
乱序处理意为指令执行的顺序不一定与他们在机器级程序中的顺序一致
超标量处理器:每个时钟周期执行多个操作,也就是CPI<1,并且这些操作是乱序的
乱序处理器框图:

循环展开
循环展开是一种程序变换,通过增加每次迭代计算的元素的数量,减少循环的迭代次数
循环展开能够在两个方面改进程序的性能:
- 减少了不直接有助于程序结果的操作的数量
- 提供了减少整个计算中==关键路径==上的操作数量的方法
循环展开的方法
对一个循环按任意因子k进行展开,产生
- 循环上限设置为
,以确保第一次循环不会超出数组的界限 - 在循环内对元素
应用合并运算 - 每次迭代循环索引
加 - 对于最后几个元素,以每次处理一个元素的方式进行处理
例如,对于函数combine4进行循环展开得到combine5:
void combine5(vec_ptr v, data_t *dest){
    long i = 0;
    long length= vec_length(v);
    long limit = length - 1;
    data_t *data= get_vec_start(v);
    data_t acc = IDENT;
    //循环展开
    for (i = O; i < length; i+=2) {
        acc= (ace OP data[i]) OP data[i+1];
     }
    //余数计算
    for(; i<length; i++){
        acc = acc OP data[i];
    }
    *dest = acc;
}
从combine4到combine5的关键路径变化:


可以看到
性能提升:

局限
循环展开的性能最终会受到没有展开的代码的制约
注意,当代编译器会自动对程序进行循环展开优化,只要优化等级开的足够高(O3及以上)
提高并行性
多个累积变量
对于一个可结合和可交换的合并运算来说,比如说整数加法或乘法,我们可以通过将一组合并运算分割成两个或更多的部分,并在最后合并结果来提高性能
例如,设
void combine6(vec_ptr v, data_t *dest) {
    long i = 0;
    long length= vec_length(v);
    long limit = length - 1;
    data_t *data= get_vec_start(v);
    data_t acc0 = IDENT;
    data_t acc1 = IDENT;
    //循环展开
    for (i = O; i < length; i+=2) {
        acc0 = acc0 OP data[i];
        acc1 = acc1 OP data[i+1];
     }
    //余数计算
    for(; i<length; i++){
        acc0 = acc0 OP data[i];
    }
    *dest = acc0 OP acc1;
}
新的关键路径:
同理,可以每隔k个元素累积,得到
重新结合变换
void combine7(vec_ptr v, data_t *dest){
    long i = 0;
    long length= vec_length(v);
    long limit = length - 1;
    data_t *data= get_vec_start(v);
    data_t acc = IDENT;
    //循环展开
    for (i = O; i < length; i+=2){
        acc= acc OP (data[i] OP data[i+1]);
     }
    //余数计算
    for(; i<length; i++){
        acc = acc OP data[i];
    }
    *dest = acc;
}
其与combine5的区别仅在于迭代时的计算方式,从(ace OP data[i]) OP data[i+1]变为了acc OP (data[i] OP data[i+1]),但是这也改变了关键路径:
性能分析:
重新结合能够减少计算中关键路径上操作的数量,通过更好地利用功能单元的流水线能力得到更好的性能
限制因素
寄存器溢出
分支预测
在上一章中我们了解到分支预测失败会损失时钟周期,对于参考机来说这个损失是19个时钟周期,所以对于分支预测:
-
不要过分关心可预测的分支
现代处理器预测策略的成功率很高,很多分支的预测可以说是准确的
-
书写适合用条件传送实现的代码
因为程序中一些测试的结果的结果是完全无法预测的,那么如果编译器能够产生使用==条件数据传送==而不是使用条件控制转移的代码,可以极大地提升此程序的性能
这个工作由编译器完成,但是程序员可以写出更容易让编译器翻译成条件传送的代码
获取更高性能
- 高级设计:选择适当的算法和数据结构
- 基本原则:避免限制优化的因素
- 消除过程调用
- 消除不必要的内存引用
- 低级优化
- 展开循环
- 通过使用多个累积变量和重结合等技术,找到方法提高指令级并行
- 用功能性的风格重写条件操作,使编译器采用条件数据传送
Chapter 6 存储器层次结构
存储技术
随机访问存储器 RAM
RAM特点
- RAM通常封装为一个芯片
- 存储单元是一个cell(每个cell是1bit)
- 多个RAM芯片构成一个内存
SRAM与DRAM
RAM分为两类:SRAM和DRAM
| SRAM | DRAM | |
|---|---|---|
| 名称 | 静态随机访问存储器 | 动态随机访问存储器 |
| 存储方式 | 每个位存储在==双稳态==存储器单元里 | 每个位存储为对一个==电容==的充电 |
| 易失性 | 断电丢失信息 | 断电丢失信息 |
| 每位晶体管数 | 6 | 1 |
| 相对访问时间 | ||
| 刷新 | 只要供电就保持不变 | 需要刷新 |
| 干扰 | 对干扰不敏感 | 对干扰敏感 |
| 价格 | ||
| 应用 | Cache | Memory |
非易失性存储
刚才提到的SRAM和DRAM在断电后无法保存下任何数据,这是不符合我们对一些数据的持久化的要求的。所以人类发展了很多非易失性存储器来持久化我们想要存储的数据,这类存储器在断电后仍然保持着他们存储的信息:
-
ROM:只读存储器
-
PROM:可编程ROM,并且只能被编程一次
-
EPROM:可擦写可编程ROM,可以被擦写和重编程
-
falsh:闪存,寿命更长
访问主存
想要访问主存,首先要有物理上的CPU和内存传递信息的通道,这个通道叫做==总线(bus)==
总线是一组并行的导线,能携带地址、数据和控制信号。根据总线的的设计,数据和地址信号可以共享同一组导线,也可以使用不同的。每次CPU和主存的数据传送都是通过一系列步骤完成的,这些步骤称为==总线事务==

读事务(从主存传送数据到CPU),以movq A,%rax为例:
- CPU将地址A放到内存总线上
- 主存从内存总线获得地址A,读取对应的字x,并将其放置到总线上
- CPU从总线读取x并拷贝到寄存器%rax中
写事务(从CPU传送数据到内存),以movq %rax,A为例:
- CPU将地址A放到总线上,主存读取地址并等待数据到来
- CPU将数据字y放到总线上
- 主存从总线读取数据字y并将其写入地址A
磁盘存储
磁盘构成与容量
每个磁盘由多个==盘片(platter)==构成,每个platter有两个==surface==,每个surface由多个同心圆磁道==tracks==组成,每个track由多个被==gap==分割的扇区==sector==构成:


磁盘操作
磁盘表面以固定的速度旋转,读写头连接在臂的末端,并在薄气垫上飞过磁盘,通过径向移动,臂可以将读写头定位在任何磁道上
逻辑磁盘块
磁盘的组成过于复杂,所以要使用抽象的逻辑视图隐藏复杂的扇区布局
可用的扇区集合被看作是一个大小为b的逻辑块序列;磁盘封装中有一个小的固件设备,称为磁盘控制器,维护者逻辑块号和实际磁盘扇区之间的映射关系
当os想要对磁盘执行一个IO操作时,磁盘控制器会把逻辑块号翻译成一个(盘面,磁道,扇区)的三元组,使用这个三元组对磁盘进行物理上的实际操作
IO总线
在内存总线上扩充:

读取磁盘扇区
- CPU写入一个命令发起磁盘读操作,命令包括逻辑块号、目标内存地址
- 磁盘控制器读扇区并通过DMA将数据传送到主存
- DMA传输完成后,磁盘控制器通过中断通知CPU
固态硬盘

- 每个闪存以页与块来组织存储
- 数据以页为单位进行读写
- 只有整个块被擦除后才能写入页
固态硬盘相比机械硬盘,更快、更节能;但是损坏的几率更大,并且更昂贵
局部性
CPU、内存与大容量存储之间的速度差异在不断持续增大
利用计算机程序的一个重要特性:局部性,能够消除CPU和内存之间速度差异的影响
局部性原理
程序更倾向于使用临近或者最近使用过的数据和指令
- ==时间局部性==:最近使用的数据在不远的将来会继续使用
- ==空间局部性==:相邻的数据会在一段时间内一起访问
存储层次中的Cache机制利用局部性消除了层次之间的速度差异
局部性小结
- 重复引用相同变量的程序有良好的时间局部性
- 对于具有步长为
的引用模式的程序,步长越小,空间局部性越好 - 对于取指令来说,循环有好的时间和空间局部性。循环体越小,循环迭代次数越多,局部性越好
存储层次
- 更快的存储成本更高,容量更小,能耗更高
- 不同的存储之间速度、容量与价格的差异可能非常大

存储器层次结构的中心思想是,对于每个k, 位于k层的更快更小的存储设备作为位于k+1层的更大更慢的存储设备的缓存。换句话说,层次结构中的每一层都缓存来自较低一层的数据对象
使用这样一个存储分层机制,我们既获得了大量的存储,也拥有了非常快的数据访问速度
Cache机制
Cache 是位于 CPU 与主存(RAM)之间的一种高速存储器,用来存放 CPU近期访问的内存数据或指令,以提高访问速度。
CPU 访问内存的速度远慢于 CPU 执行速度,因此引入 Cache 来降低平均访问延迟。
下面的Cache泛指更快更小的存储,Memory泛指相比Cache更慢更大的存储
对Cache的访问
Cache会缓存Memory中的一部分内容,如图:
当访问Memory时,会先访问Cache。因为如果Cache中缓存了要访问的内容,那么访问时间可能只有访问Memory的百分之一。那么存在两种情况:
-
Cache==命中==:要访问的块在Cache中
-
Cache==丢失==:要访问的块不在Cache中,需要从内存中加载该块并将替换缓存中的一个块
命中的时候很简单,直接读出Cache中的目标块即可;但是丢失的时候很麻烦,需要把Memory中的块放入Cache中。这个时候就面临替换的问题(有点类似操作系统中的存储管理),要有一个合适的替换算法决定哪个块将被替换掉
Cache丢失的种类:
-
冷启动丢失:数据第一次被访问,Cache 里没有记录,必然丢失
-
冲突丢失:内存中的一些块映射到Cache中的同一个块,当他们反复被使用时,就会一直不命中
-
容量丢失:活跃使用的块大于Cache容量.
高速缓存存储器 Cache
Cache是有硬件自动管理的容量较小的SRAM,持有从主存装入的频繁访问的内容
Cache结构
假设每个存储器地址有
这里他直接给出了每个line的组成,实际上:
- 1bit的有效位用于标记"该line有没有存储主存中的块"
- t bit的标记位是为了和主存中的块对应,要访问主存时用tag来查找cache中是否已经缓存了主存中的目标块

寻址时的地址: ,分为tag、组索引和偏移量
高速缓存的大小:
用一个四元组
- tag和set index连起来唯一地标识了内存中的每个块
- 映射到同一个set的块由tag唯一的标识
直接映射高速缓存
每个主存块只能映射到 Cache 的一个固定位置。
优点:简单、速度快。
缺点:容易发生冲突丢失。
结构
每个set只有一个line的cache被称为直接映射高速缓存(

存取
高速缓存确定一个请求是否命中,然后抽取出被请求的字的过程,分为三步:
-
组选择:根据set index查找set
-
行匹配:检查set中的line是否有匹配的tag,若找到则检查valid位是否合法;若没找到则丢失
-
字选择:根据offset定位数据,得到该数据的地址
若丢失,则需要在下一层中取出被请求的块,然后进行行替换。对于直接映射而言,替换策略就是直接用新取出的行替换当前的行
当程序访问大小为2的幂的数组时,直接映射高速缓存中通常会发生冲突不命中
全相联高速缓存
数据可以放到 Cache 中的任意位置。
优点:冲突少。
缺点:硬件复杂,查找慢。
S = 1 :只有一个组
没有匹配或无效(不命中):
- 组0中的一行进行驱逐替换
- 替换策略:随机,最近最少使用(LRU)
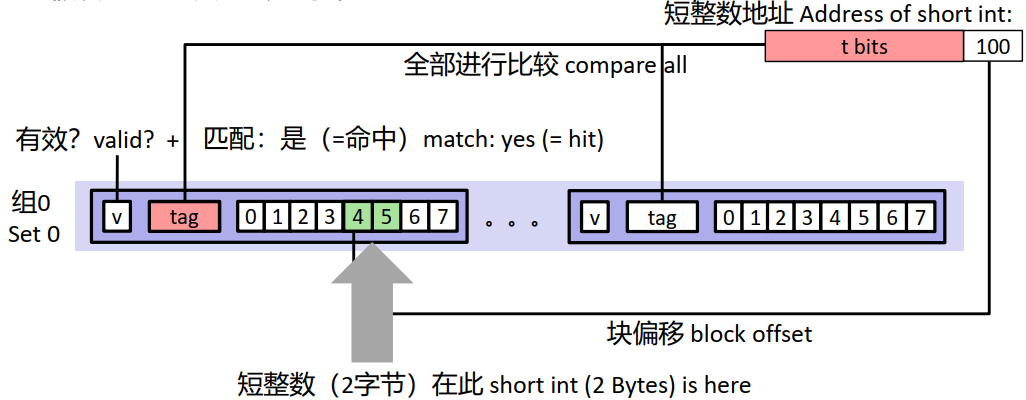
组相联高速缓存
Cache 分为若干组,每组有若干行。
数据映射到某组,但可放入该组任意行。
折中方案:减少冲突,硬件复杂度可控。
结构
每个set有E个Line,其中

E=2:每组2行
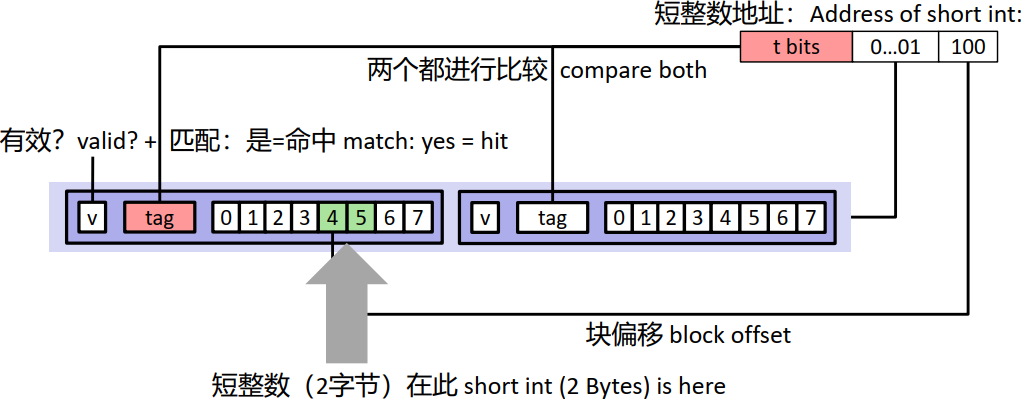
存取
组相联高速缓存的组选择与直接映射中的一样,但是行匹配和字选择会更麻烦:需要检查组内每个行的标记位和有效位,匹配之后根据偏移量从块中选择一个字
丢失发生时,优先替换空行;如果没有空行,一般采取LRU算法对块进行替换
Cache写
Cache读的情况在前面已经介绍过了,而Cache写要相对复杂些
写命中
假设我们要写一个我们已经缓存了的字
-
==直写==:立即将
的高速缓存块写回到紧接着的低一层中 这样虽然实现简单,但是每次写都会引起总线流量
-
==写回==:尽可能地推迟更新,只有当替换算法要驱逐这个更新过的块时,才把它写到紧接着的低一层中
要实现写回,cache必须为每个line添加一个==修改位==,来表明这个块是否被修改过
写丢失
- 写分配:加载相应的低一层中的块到高速缓存中,然后更新这个块
- 非写分配:避开高速缓存,直接把这个字写到低一层中
一般情况下cache有两种策略:
- 直写+非写分配
- 写回+写分配
Cache性能分析
- 丢失率(Miss Rate):内存引用没有在Cache中找到的比率
- 命中时间(Hit Time):从Cache行到处理器的时间
- 丢失开销(Miss Penalty):丢失需要额外的时间
编写Cache友好的代码
原则:
- 让最常见的最快
- 减少内层循环的丢失率
Cache对程序性能的影响
存储器山
- 读吞吐量:程序从存储系统中读数据的速率
- 存储山丘:根据空间和时间局域性测量的读吞吐率

重新排列循环以提高空间局部性
以矩阵相乘为例,考虑一对

下面对这些版本进行分析,分析的重点在==最内层循环==
-
ijk与jik版本
每次迭代都要去读两个与
相关的数,读 时因为是按行读所以命中率会较高;而在读 时因为是按列读,所以命中率会较低 -
jki与kji版本
读的
和 都是按列读,命中率基本就是0,所以这个版本应该是最慢的 -
kij与ikj版本
读的
和 都是按行读的,遵循时间局部性,命中率会较高,这个版本应该是最快的
结果:

使用blocking提升时间局部性
假设:
- 矩阵元素类型为double
- 块大小为64B,一次最多容纳8个double数据
- cache大小远小于n
若采用最简单的矩阵相乘算法,那么对于每一次行乘列,都会有
若采用分块矩阵乘法:
// 我真是服了这个B代码缩进6次
void mmm(double *a, double *b, double *c, int n) {
	int i, j, k;
	for (i = 0; i < n; i+=B)
        for (j = 0; j < n; j+=B)
            for (k = 0; k < n; k+=B)
                /* B x B mini matrix multiplications */
					for (i1 = i; i1 < i+B; i++)
                	 for (j1 = j; j1 < j+B; j++)
                   		for (k1 = k; k1 < k+B; k++)
								//c[i1*n+j1] += a[i1*n + k1]*b[k1*n + j1];
    							c[i1][j1] += a[i1][k1]*b[k1][j1]
}
看代码可以知道,分块矩阵乘法把矩阵分成

对于

每更新一个block,都要发生
Chapter 7 链接
链接是将各种代码和数据片段收集并组合成一个单一文件的过程,这个文件可被加载到内存并执行;链接可以发生在编译时、加载时、运行时
引入链接技术,我们可以将大型的项目模块化,并且提升写代码的效率(修改后只需要重新编译有变动的文件然后链接)
静态链接器
静态链接器以一组可重定位目标文件和命令行参数作为输入,生成一个完全链接的、可以加载和运行的可执行目标文件作为输出
基本事实:目标文件纯粹是字节块的集合。这些块中,有的包含程序代码,有些包含程序数据,其他的则包含引导链接器和加载器的数据结构。链接器将这些快连接起来,确定被连接块的运行位置,并且修改代码和数据块中的各种位置
链接器的任务
- ==符号解析==(sybbol resolution):
- 确定程序定义和引用的符号,并将符号定义保存在目标文件的符号表中
- 符号消解时,连接器把每一个符号引用恰好地和一个符号定义关联起来
- ==重定位==(relocation):
- 激情多个独立的代码和数据段和编导一个段中
- 将.o文件(可重定位目标文件)中的符号从相对位置改为执行文件最终的在内存中的绝对地址
- 更新所有引用,将其改为最新的位置
目标文件
目标文件有三种形式:
| 文件类 型 | 特点 | 拓展名 | 生成 |
|---|---|---|---|
| ==可重定位目标文件== | 其中的代码和数据可以和其他可重定位目标文件一起形成可执行目标文件 | .o | 编译器和汇编器 |
| ==可执行目标文件== | 其中的代码和数据可以直接拷贝到内存中执行 | a.out | 链接器 |
| ==共享目标文件== | 特定的可重定位目标文件,能以在加载时或者运行时装进内存并进行动态链接 | .so | 编译器和汇编器 |
目标文件是按照特定的目标文件格式来组织的,各个系统的目标文件格式都不相同;现代64位Linux和Unix使用ELF
ELF目标文件格式
可重定位目标文件

- ELF头:字大小、字节顺序、文件类型、机器类型等
- .text:已编译程序的机器代码
- .rotate:只读数据,如跳转表、格式串等
- .data:已初始化的全局和静态C变量
- .bss:未初始化的全局变量以及所有初始化为0的全局或静态变量
- .symtab:符号表,存放在程序中定义和引用的函数和全局变量的信息
- .rel.text:.text节中位置的列表,当链接器把这个目标文件和其他文件组合时,需要修改这些位置
- .rel.data:被模块引用或定义的所有全局变量的重定位信息
- .debug:调试符号表
在课本的表中没有,但实际还有一个COMMON节,存储未初始化的全局变量
局部C变量运行时被保存在栈中,既不出现在.data中,也不出现在.bss中
可执行目标文件

可执行目标文件有一个.init节,其中有_init函数,程序初始化代码会调用它;并且因为可执行目标文件已完成链接,所以没有.rel节
符号和符号表
每个可重定位目标模块m都有一个符号表,它包含m定义和引用的符号信息,有三种链接符号:
| 符号名称 | 定义 | 对应 |
|---|---|---|
| 全局符号 | 模块m定义,可以被其他模块引用的符号 | 非静态的C函数和全局变量 |
| 外部符号 | 模块m引用,在其他模块中定义的全局符号 | 其他模块中定义的非静态的C函数和全局变量 |
| 本地符号 | 模块m定义并且只在m中引用的符号 | 静态的C函数和全局变量 |
符号解析
链接器解析符号引用的方法是将每个引用与它的输入的可重定位目标文件的符号表中的一个确定的符号定义关联起来。对于本地符号的的解析比较简单,而对于全局符号的解析就麻烦的多
当编译器遇到一个不是在当前模块中定义的符号时,会假设该符号是在其他某个模块定义的,生成一个链接器符号表条目,并把它交给链接器处理。如果链接器在它的任何输入模块中都找不到这个被引用符号的定义,就输出一条错误信息并终止;除了找不到定义这种情况以外,多个目标文件还可能会定义相同名字的全局符号,这也会产生冲突
强/弱符号
- 强符号:过程和初始化的全局变量
- 弱符号:未初始化的全局符号

解析规则
- 不允许有多个强符号
- 当有一个强符号与多个弱符号同名,那么选择强符号
- 如果有多个弱符号同名,那么从这些弱符号中任意选择一个

重定位
当链接器完成了符号解析,那么代码中的每个符号引用就和一个符号定义关联起来,那么链接器就知道输入目标模块中的代码节和数据节的确切大小,可以进行重定位了
重定位将合并输入模块,并为每个符号分配运行时地址。由两步组成:
-
重定位节和符号定义
将所有的同类型节合并为一个新的节;然后把运行时内存地址赋给新的节、模块第一的每个节、每个符号
-
重定位节中的符号引用
链接器修改代码节和数据节中每个符号的引用,是他们指向正确的运行时地址
重定位条目
汇编器生成目标模块时并不知道数据和代码最后会放到哪里,所以当他遇到对最终位置未知的目标引用时,它就会生成一个==重定位条目==。来告诉链接器将目标文件合并成可执行文件时该如何修改这个引用
typedef struct {
	long offset; 	// Offset of the reference to relocate
	long type:32, 	// Relocation type
		symbol:32;	// Symbol table index
	long addend; 	// Constant part of relocation expression
} Elf64_Rela;
- offset:需要被修改的引用的节的偏移
- type
R_X86_64_PC32:重定位一个使用32位PC相对地址的引用R_X86_64_32:重定位一个使用32位绝对地址的引用
- symbol:表示被修改引用应该指向的符号
- addend
重定位符号引用
假设每个节s时一个字节数组,每个r是一个重定位条目,以下是重定位的伪代码算法:
foreach section s {
	foreach relocation entry r {
		refptr = s + r.offset; /* 指向要重定位的条目的指针 */

		/* Relocate a PC-relative reference */
		if (r.type == R_X86_64_PC32) {
			refaddr = ADDR(s) + r.offset; 	/* ref's run-time address */
			*refptr = (unsigned) (ADDR(r.symbol) + r.addend - refaddr);
		}

		/* Relocate an absolute reference */
		if (r.type == R_X86_64_32)
			*refptr = (unsigned) (ADDR(r.symbol) + r.addend);
		}
}
示例程序main.o:
0000000000000000 <main>:
	0: 48 83 ec 08 			sub $0x8,%rsp
	4: be 02 00 00 00 		mov $0x2,%esi
	9: bf 00 00 00 00 		mov $0x0,%edi 			# %edi = &array
						a: R_X86_64_32 array 		# Relocation entry

	e: e8 00 00 00 00 		callq 13 <main+Ox13> 	# sum()
						f: R_X86_64_PC32 sum-Ox4 	# Relocation entry
	13: 48 83 c4 08 		add $0x8,%rsp
	17: c3 					retq
重定位PC相对引用
在示例程序中,main函数调用在sum.o中定义的sum函数,其重定位条目r:
	r.offset = 0xf
	r.symbol = sum
	r.type = R_X86_64_PC32
	r.addend = -4
假设链接器已经确定ADDR(s)=ADDR(.text)=0x4004d0,ADDR(r.symbol)=ADDR(sum)=0x4004e8
那么根据算法计算可得:*refptr=(unsigned)(0x5)
在得到的可执行目标文件中,call指令的地址为0x4004de,PC也就是下一条指令的值为0x4004e3,得到的最终结果即为PC = PC + *refptr = 0x4004e8
重定位绝对引用
在示例程序中,main函数调用在sum.o中定义的array,其重定位条目r:
	r.offset = 0xa
	r.symbol = array
	r.type = R_X86_64_32
	r.addend = 0
假设链接器已确定ADDR(r.symbol)=ADDR(array)=0x601018,那么得新的*refptr=(unsigned)(0x601018)
加载

链接库
我们写代码不可能从最底层写起一个一个轮子造,总要用到一些公有的函数,那么问题就来了:怎么打包这些共用的函数呢?
静态链接库
将所有的相关目标模块打包成为一个单独的文件,称为静态库;当它作为链接器的输入来构造可执行文件时,只复制静态库里被程序引用的目标模块
- 将相关的重定位目标文件按照索引放入单个的文件中(称为档案)
- 链接器在不同的档案中查找未消解的符号
- 如果在某个档案中找到了引用的符号,则将这个文件链接到可执行文件中
创建静态链接库

链接静态链接库

消解外部引用的算法:
- 按照命令行顺序扫描.o文件和.a文件
- 在扫描过程中维护一个未消解的引用
- 当每遇到新的.o和.a文件,尝试使用这些目标文件中定义的符号对应那些未消解的符号
- 如果扫描结束还有未消解的符号则报错
注意如果在编译时文件顺序不对,也有可能导致报错;要解决这一问题,要把库放在命令行的末尾
动态链接库
一些函数如printf在很多进程中都会有用到,如果采用静态库,把他们复制到每个进程的text段中,有些浪费;并且如果这些函数有bug,那么每个应用都需要重新链接
解决方案是共享库(动态链接库),包含代码和数据的目标文件是在加载过程中或者运行时动态加载和链接的,其具有以下特点
- 当可执行文件第一次加载和运行时进行动态链接
- 程序开始执行后也可以进行动态链接
- 共享库可以被多个进程共享
加载时动态链接

运行时动态链接
在代码中获取动态库,用指针引用函数
链接实例
库打桩:一种强大的链接技术,能够让程序员截获任意函数调用
库打桩
库打桩是一种强大的链接技术,可以让程序员截获任意的函数调用
库打桩发生的时机
- 编译时
- 链接时
- 加载/运行时
库打桩应用
- 安全
- 调试
- 监控
- profiling
位置无关代码PIC
共享库的一个主要目的就是允许多个进程共享主存中的代码,从而节省主存。那么多个进程是如何共享程序的一个副本的呢?
- 给每个共享库分配一个事先预备的专用的地址空间片,但是这样分配对空间的使用率不高,比你高且难以管理
- 使用位置无关代码
gcc -fpic:可以把共享模块的代码段加载到内存的任何位置,而无需链接器做任何修改
Chapter 8 异常
异常控制流
控制流
操作系统把CPU从开机到停机设计为一个CPU读入指令序列的过程,这个序列就是CPU的控制流
改变控制流
目前我们已知的有跳转指令、调用/返回指令可以改变控制流,但是这些都是预先设定好的,它无法响应突发的一些系统状态的改变
异常控制流存在于系统的每个层次:
- 低层次机制
- 异常
- 高层次机制 2. 进程上下文切换 3. 信号 4. 非局部跳转
异常
异常:为了响应某些事件而将控制转移到内核
异常的基本思想:
异常表格
系统中可能的每种类型的异常都分配了一个唯一的非负整数的异常号,每个异常号在异常表中对应一段异常处理代码。异常表的起始地址放在异常表基址寄存器中

异常种类
| 名称 | 原因 | 异步/同步 | 返回行为 | 例子 |
|---|---|---|---|---|
| 中断 | 处理器的外部事件 | 异步 | 总是返回到下一条指令 | 时钟中断、I/O中断 |
| 陷阱 | 有意的异常 | 同步 | 总是返回到下一条指令 | 系统调用、断点、特殊指令 |
| 故障 | 潜在可恢复的错误 | 同步 | 可能返回到当前指令 | 缺页异常、保护异常、浮点异常 |
| 终止 | 不可恢复的错误 | 同步 | 不会返回 | 非法指令、校验错误、机器检查 |
中断

陷阱和系统调用

故障
故障由错误引起,它可能被故障处理程序修正
与其他异常不同,在故障处理程序执行完毕之后,不会跳到下一个指令,而是重新执行或者终止

终止
终止是不可恢复的致命错误造成的结果,通常是一些硬件错误
进程
进程是程序的运行的实例,系统中的每个程序都运行在某个进程的上下文中
进程为每个程序提供了两个关键抽象:==逻辑控制流==与==私有地址空间==
- 逻辑控制流使得每个程序看起来独占CPU
- 私有地址空间使得每个程序看起来独占主存
逻辑控制流
如果用调试器单步执行程序,我们会看到一系列的程序计数器值(PC)。这个PC值的序列叫做逻辑控制流

并发流
- 一个逻辑流的执行在时间上与另一个流重叠,称为并发流
- 如果两个流并发地运行在不同地处理器核或者计算机上,就称他为并行流
- 多个流并发地执行的一般现象被称为并发
- 一个进程和其他进程轮流运行的概念称为多任务
上下文切换
内核会为每个进程维持一个==上下文==,上下文就是内核重新启动一个被抢占地进程所需的状态。当内核代表用户执行系统调用时,可能会发生上下文切换
内核不是一个独立的进程,而是作为某些进程的一部分运行
在进程执行的某些时刻,内核可以决定抢占当前进程,并重新开始一个先前被抢占了的进程,这种决策就叫做调度,是由内核称为调度器的代码处理的
上下文切换使得控制流从一个进程切换到另一个进程:

私有地址空间
就是每个进程的虚拟内存:
系统调用错误处理
出错时,系统函数返回-1并通过全局变量errno给出出错原因
每次系统调用都要检查结果(返回值为void的除外)
错误处理包装函数
pid_t Fork(void){
	pid_t pid;
	if ((pid = fork()) < 0)
		unix_error("Fork error");
	return pid;
}

pid = Fork();
如上面的代码,将函数fork()包装成自带错误处理的Fork()
进程控制
获取进程
pid_t	getpid(void);		// 返回当前进程ID
pid_t	getppid(void);		// 返回当前父进程ID
进程的状态:
- 运行
- 挂起
- 终止
进程的终止
终止原因:
- 收到一个信号,该信号的默认行为是终止进程
- 从主程序返回
- 调用
exit函数
void exit(int status);
进程的创建
父进程通过fork函数创建一个新的运行子进程
pid_t fork(void);
子进程与父进程的异同
父进程与子进程最大的区别在于它们有不同的PID
- 创建时子进程虚拟空间是与父进程一模一样的副本
- 子进程获得与父进程任何打开文件描述符相同的副本
fork特点
-
==调用一次,返回两次==
一次在父进程返回,返回值为子进程PID;一次是在子进程,返回值为0
-
并发执行
内核可能以任意方式交替执行它们的逻辑控制流中的指令
-
重复的但是独立的地址空间
-
共享打开的文件
使用进程图描述fork
==进程图==是刻画程序语句偏序的一种简单的前趋图:每个顶点
对于运行在单处理器上的程序,对应进程图种所有顶点的拓扑排序表示程序中语句的一个可行的全序排列
举例,两个连续fork:
可能输出:L0 L1 Bye Bye L1 Bye Bye
不可能输出:L0 Bye .......
回收子进程
进程终止之后内核并不会立即将它清除,而是保持在终止状态,直至被它的父进程回收
捕获:
- 父进程等待子进程终止
- 父进程获得退出状态信息
- 内核删掉僵尸子进程
那如果父进程没有回收会怎么样?
- 父类不回收则init进程会出手
- 所以只需要显示回收长时间运行的进程
子进程同步
父进程通过wait函数重新对接子进程
int wait(int *child_status);
作用:挂起当前进程直到其中一个子进程退出,返回值是终止的子进程的PID
参数:如果child_status不为空,则该指针指向的值表示的是子进程终止和退出的原因
进程图实例:
等待特定进程
一个进程可以调用waitpid函数挂起当前进程等待它的某个子进程终止或者停止:
pid_t waitpid(pid_t pid, int *statusp, int options);
- 参数pid用来判定等待的集合,pid大于0则等待pid对应的子进程,如果pid=-1,则等待所有的子进程
- 参数options用来修改默认行为
- 参数statusp用来检查已回收子进程的退出状态
进程的休眠
sleep函数将一个进程挂起一段指定的时间。如果请求的时间到了则返回0,没到则返回剩余的休眠时间
unsigned int sleep(unsigned int secs);
pause函数让调用函数休眠,直到该进程收到一个信号,总是返回-1
int pause(void);
加载运行程序
execve函数在当前进程的上下文中加载并运行一个新程序:
int execve(const char *filename, const char *argv[], const char *envp[])
- filename就是可执行文件的名字
- argv就是运行该文件的参数
- envp是带有环境变量的列表
该函数会覆盖代码、数据和堆栈;保留PID、打开的文件和信号上下文
一次调用,不会返回
信号
Shell
Shell是按照用户要求运行程序的应用程序。Shell执行一系列的读/求值步骤,读步骤读取来自用户的命令行,求值步骤解析命令行并代表用户运行
但是简单的shell不会回收它的后台子进程,需要有东西提醒。Unix系统中这种提醒的机制就是信号
信号就是一条消息,它通知一个进程某种类型的事件在系统中发生了
- 信号机制类似于异常和中断
- 由内核发送给一个进程
- 信号的唯一信息就是一个ID以及信号到达的事实
- 信号的类型用1-30个小整型标识:

发送信号
内核通过更新目标进程的某些状态来发送一个信号给目标进程
发送信号的原因:
- 内核侦测到除零错误或者子进程终止等系统事件
- 另外一个进程调用了kill系统调用显式请求内核发送一个信号给目标
进程组
每个进程都只属于一个进程组,进程组是由一个正整数==进程组ID==来标识的
函数getpgrp获取当前进程组ID:
pid_t getpgrp(void);
函数setpgid改变自己或者其他进程的进程组:
int setpgid(pid_t pid, pid_t pgid);
用/bin/kill发送信号
/bin/kill程序可以发送任意信号给一个进程或者进程组,如:
/bin/kill -9 15213		# 发送信号9给进程15213
/bin/kill -9 -15213		# 发送信号9给进程组15213中的所有进程
从键盘发送信号
输入crtl-c(crtl-z)会导致系统内核发送一个SIGINT(SIGTSTP)信号给前台进程组的每个任务,最终结束(挂起)前台进程组中的每个进程
用kill函数发送信号
进程通过调用kill函数发送信号给其他进程(包括他们自己)
int kill(pid_t pid, int sig);
- 如果pid>0,那么发送信号给进程pid
- 如果pid=0,那么发送信号给调用进程所在进程组的每个进程
- 如果pid<0,那么发送信号给**进程组|pid|**的每个进程
用alarm函数发送信号
进程可以调用alarm函数向他自己发送SIGALRM信号
unsigned int alarm(unsigned int secs);
alarm函数安排内核在secs秒后发送一个SIGALRM信号给调用进程
接收信号
目标进程接收信号是由于内核强制其对某个信号的发送做出响应,比如在某个信号出现后内核强行改变某个进程的上下文。响应方式:
- 忽略
- 终止进程
- 调用用户级信号处理函数

一个发出而没有被接受的信号叫做==待处理信号==;一个进程可以有选择性地==阻塞==某种信号,不影响被阻塞信号的发送,但发送之后就会被丢弃
一个待处理信号最多只能被接收一次。内核为每个进程在pending位向量中维护着待处理信号的集合,在blocked位向量中维护着被阻塞的信号集合
当内核把进程p从内核模式切换到用户模式时,它会检查进程p的为被阻塞的待处理信号的集合(pending & ~blocked):
- 如果这个集合为空,那么内核将控制转移到p的逻辑控制流的下一条指令
- 如果集合是非空的,那么内核选择集合中的某个信号k,并强制p接收信号k,收到这个信号会触发进程采取某种行为,当进程完成这个行为,那么控制就传递回p的逻辑控制流的下一条指令
默认动作
每种信号有一个预定义的默认动作,可能是以下几种之一:
- 进程终止
- 进程终止并转储内存
- 进程挂起直到被
SIGCONT信号重启 - 进程忽略该信号
信号处理程序
函数Signal修改信号signum对应的默认行为:
handler_t *signal(int signum, handler_t *handler);
- handler是用于信号处理程序的地址,当进程接收到类型为
signum的信号时调用
例如我们捕获SIGINT信号并将器默认行为改为输出一条消息后再终止程序:
void sigint_handler(int sig){
    printf("Caught SIGINT!\n");
    exit(0);
}
嵌套信号处理
信号处理程序仍然可以被其他信号处理程序中断:

阻塞和接触信号阻塞
隐式阻塞机制
内核默认阻塞任何当前处理程序正在处理信号类型的待处理信号
显式阻塞机制
应用程序可以使用sigprocmask函数和它的辅助函数,明确地组合和解除阻塞选定的信号
#include <signal.h>

int sigprocmask(int how, const sigset_t *set, sigset_t *oldset);
int sigemptyset(sigset_t *set);				// 创建一个空的集合
int sigfillset(sigset_t *set);				// 对集合设置每个信号
int sigaddset(sigset_t *set, int signum);	// 对集合设置信号signum
int sigdelset(sigset_t *set, int signum);	// 将信号signum从集合删除
					// 如果成功返回0,出错返回-1
int sigismember(const sigset_t *set, int signum);
					// 如果signum是set的成员返回1,如果不是返回0,若出错返回-1
sigprocmask函数改变当前阻塞的信号集合,具体行为依赖于参数how的值:
SIG_BLOCK:将set中的信号添加到blocked中SIG_UNBLOCK:从blocked中删除set中的信号SIG_SETMASK:block = set
示例程序:
	sigset_t  mask, prev_mask;
	Sigemptyset(&mask);
	Sigaddset(&mask, SIGINT);
	/* Block SIGINT and save previous blocked set */
	Sigprocmask(SIG_BLOCK, &mask, &prev_mask);

		/* Code region that will not be interrupted by SIGINT */

	/* Restore previous blocked set, unblocking SIGINT */
	Sigprocmask(SIG_SETMASK, &prev_mask, NULL);
编写信号处理程序
安全的信号处理
启发性提示:
- 中断处理程序越简单越好
- 只调用异步安全的信号处理函数
- 进入和退出时保存
errno - 临时阻塞所有的信号后再访问全局数据结构
- 将全局变量声明为
volatile - 将全局标记声明为
volatile sig_atomic_t
信号处理程序中产生输出唯一安全的方法是使用write函数
正确的信号处理
有一个特别需要注意的点:当进程正在执行信号k的处理程序时,所有信号k都会被阻塞,并不会排队。所以,如果存在一个未处理的信号,表明至少有一个信号到达了;同理,不可以用信号来对其他进程发生的事件计数!
所以,必须等待所有终止的子进程。具体做法是把wait函数放入循环中以回收所有终止的子进程
同步控制流以避免竞争
显式等待信号
使用sigsuspend等待信号:
int sigsuspend(const sigset_t *mask);

// 实际上等价于
sigprocmask(SIG_BLOCK, &mask, &prev);
pause();
sigprocmask(SIG_SETMASK, &prev, NULL);
非局部跳转
将控制转移到任意位置的强大用户级机制,通常用于用户错误处理和信号处理
函数
int setjmp(jmp_buf j);
特点:
- 必须在
longjmp之前调用,给出后续longjmp对应的返回位置 - 调用一次,返回一次或多次
实现:
- 通过将寄存器上下文、堆栈指针和PC值等存储在jmp_buf中记住当前位置
- 返回0
void longjmp(jmp_buf j,int j);
特点:
setjmp之后调用- 一次调用但是不返回
实现:
- 从跳转缓冲区j中恢复寄存器上下文
- 将返回值寄存器%eax设置为i
- 跳转到缓冲j中指定的位置
限制
非局部跳转基于栈原理工作,只能跳转到已经调用但是还没完成的函数
Chapter 9 虚拟内存
为了更加有效地管理内存并且少出错,现代系统提供了一种对主存的抽象概念——==虚拟内存==,它提供了三个重要的能力:
- 更高效的使用主存:它将主存看成是一个存储在磁盘上的地址空间的高速缓存
- 简化了内存管理:它为每个进程提供了一致的线性地址空间
- 隔离地址空间:保护了每个进程的地址空间不被其他进程破坏
虚拟寻址
早期使用物理寻址,但是这个方法十分不方便(OS中有介绍过),所以现代处理器使用虚拟寻址:

地址空间
地址空间区分了数据对象(字节)和他们的属性(地址),允许每个数据对象有多个独立的地址,每个地址都选自一个不同的地址空间
-
线性地址空间
连续非负整型地址的有序集合:
-
虚拟地址空间
虚拟地址集合: -
物理地址空间
物理地址集合:
为什么要使用虚拟内存
- 更高效的使用主存
- 简化内存管理,每个进程都用同样的统一线性地址空间
- 隔离地址空间,使得一个进程不会与另一个进程冲突,用户程序也不能访问内核的信息和代码
基于虚拟内存的缓存机制
- 概念上而言,虚拟内存被组织为一个由存放在磁盘上的
个连续的字节大小的单元组成的数组。每个字节都有一个唯一的虚拟地址,作为到数组的索引。 - 磁盘上的数组的内容是缓存在物理内存中的:

DRAM缓存的组织结构
SRAM比DRAM快10倍,但是DRAM比磁盘快10000倍。所以DRAM缓存组织如果不命中,惩罚相比SRAM不命中要高很多。所以,为了尽量命中:
- 虚拟页往往很大,通常是4KB-2MB
- DRAM缓存是全相联的,即任何虚拟页都可以放置在任何的物理页中
- 替换策略更复杂精密
- 采用写回机制
页表
与任何缓存一样,虚拟内存系统必须有某种方法来判定一个虚拟页是否缓存在DRAM的某个地方。如果是,则需要确定该虚拟页存放在哪个物理页中;若不是,则需要确定虚拟页存放在磁盘的哪个位置
页表就是用于实现上述功能的结构之一(还有OS与MMU),实际上,页表是将虚拟页映射物理页的页表条目构成的数组
页表通过有效位判断页存在于物理内存还是虚拟内存中:

页命中
引用的虚拟内存在物理内存中称为页命中
缺页中断
引用的虚拟内存不在物理内存中称为缺页中断
缺页中断处理
缺页中断处理程序选择一个条目换出
分配页面
分配虚拟内存的一个新页
局部性的作用
局部性保证了在任意时刻,程序将趋向于在一个较小的活动页面集合上工作,这个集合叫做==工作集==
- 如果工作集的大小小于主存的大小那么效果比较好
- 如果工作集的大小大于主存的大小那么会产生抖动
基于虚拟内存的管理机制
关键点,每个进程都有自己的虚拟空间:
- 将内存看作简单的线性数组
- 用映射函数将地址分散到物理内存中

-
简化链接
独立的地址空间允许每个进程的内存映像使用相同的基本格式,而不管代码和数据实际存放在物理内存的何处;并且代码、数据和堆总是从相同的地址开始
-
简化加载
当加载可执行文件和共享对象文件时,直接先把.text和.data节加载到新创建的进程中并分配虚拟页;但是一直到要使用这些数据或代码时,虚拟内存系统才会调入页
-
简化共享
-
简化内存分配
基于虚拟内存的内存保护机制
给页表记录进行扩展增加权限位,MMU在每次内存访问时检查
例如:
地址翻译
地址翻译符号总结
基本参数
| 符号 | 描述 |
|---|---|
| 虚拟地址空间的地址个数 | |
| 物理地址空间的地址个数 | |
| 页大小(字节) |
虚拟地址组成部分
| 符号 | 描述 |
|---|---|
| TLBI | TLB索引 |
| TLBT | TLB标记 |
| VPO | 虚拟地址页偏移 |
| VPN | 虚拟地址页号 |
物理地址组成部分
| 符号 | 描述 |
|---|---|
| PPO | 物理页偏移量 |
| PPN | 物理页编号 |
| CO | 缓冲块内字节偏移量 |
| CI | 高速缓存索引 |
| CT | 高速缓存标记 |
基于页表的地址翻译
这个地址转换在OS里都背下来了,看看图得了:

页命中

- 处理器将虚拟地址发送给MMU
- MMU用页表基址访问页表
- MMU将内存中页面里面的页表记录取出来
- MMU将物理地址发给Cache或者主存
- Cache或者主存将数据发送给处理器
缺页中断

- 处理器将虚拟地址发给MMU
- MMU用页表基址访问页表
- MMU从内存中的页表取出页表记录
- 当合法位为0时MMU触发缺页中断异常
- 异常处理程序找到一个换出页(如果是脏页则要写回磁盘)
- 异常处理程序拷贝页并更新页表记录
- 异常处理程序返回原进程中断的指令重新执行
结合Cache和虚拟内存
就快表
使用TLB加速地址翻译
TLB:翻译后备缓冲器(OS课中叫他联想存储器),是一个在MMU中的关于PTE的小缓存
TLB是一个小的、虚拟寻址的缓存,其中每一行都保存着一个由单个PTE组成的块
TLB访问
MMU使用VA的VPN部分访问TLB:其中TLBI用于查找set,TLBT用于查找tag

TLB命中

TLB不命中

多级页表
如果主存中只有一个页表,那么页表会占用很多主存的空间,甚至主存放不下页表,为解决这个问题,我们引入多级页表
一级页表总是驻留在内存中,每个页表记录指向一个页表

多级页表的地址翻译,虚拟地址被划分多个VPN和一个VPO,如:

地址翻译实例
Linux内存系统
内存映射
共享对象
两个进程映射了物理内存中的同一个对象到各自的虚拟地址空间:

采用==写时复制==技术,当有进程要对这个共享对象写时,才会创建该对象的副本;也就是说把创建私有对象副本延迟到最后的时刻,最充分的利用主存
动态内存分配
应用可以通过mmap函数来手工管理内存,但是绝大多数程序还是采取动态内存分配器
==动态内存分配器==维护着一个进程的虚拟内存区域,称为堆;它把堆视作一组不同大小的块的集合来维护
分配器有两种风格,他们都显式的分配块,但是释放时则不同:
- 显式分配器:要求显式释放任何已分配的块
- 隐式分配器:要求分配器检测一个已分配的块是否不再被程序所用,若是就释放这个块,也被称为垃圾收集
malloc与free
malloc函数用于分配地址空间,free函数用于释放。此外还有calloc函数用于初始化分配、realloc用于重新分配
注意:malloc返回大小至少是size的内存块指针,x86上是按8字节对齐,x86-64是按16字节对齐。题目里遇到的话,如果它不说,就当它没有对齐
性能指标
- 吞吐率:单位时间内完成的请求数量
- 峰值利用率
碎片
造成堆利用率较低的主要原因就是有==碎片==的存在,碎片分为:
- 内部碎片:已分配的块比有效载荷大,也就是说已分配的块内部有未利用的部分
- 外部碎片:当空闲内存合计起来能够满足一个分配需求,但是没有一个单独的空闲块能处理这个请求
问题
一个好的分配器要在吞吐率和利用率之间取得平衡,就要考虑以下问题:
- 空闲块组织:如何记录空闲块?
- 放置:如何选择合适的空闲块来放置新的块?
- 分割:将一个新分配的块放到某个空闲块之后,如何处理空闲块的剩余部分?
- 合并:如何处理一个刚刚被释放的块?

隐式空闲链表
一个块由一个字的头部、有效载荷,以及可能的填充组成。头部编码了这个块的大小、以及这个块是已分配的还是空闲的:
这样,我们就可以把堆组织为一个连续的已分配块和空闲块的序列:

把这种结构称呼为隐式链表是因为没有指针,而是使用块头的大小隐式链接的。除此之外,我们还需要一个结束块
隐式空闲链表虽然简单,但是操作开销比较大
放置块
当应用请求一个k字节的块时,分配器搜索空闲链表,查找一个足够大的可以放置所请求块的空闲块,常见的有这几种查找策略:
- 首次适配(First Fit)
- 下一次适配(Next fit):每次从上一侧查询结束的地方开始
- 最佳适配(Best fit)
分割块
由于分配的空间可能会比空闲空间小,因此可能会拆分空闲块

释放与合并
分配器释放块时,如果直接直接清除已分配标记位,可能会导致伪碎片,即可能有其他的空闲块与刚刚释放的块相邻。此时则需要进行合并:

合并可以选择立即合并还是推迟合并,推迟合并就是指等到不够用的时候再把碎片合并
双向合并
上面的合并方式无法解决与前一个块合并的问题,为解决这个问题,我们给每个块的结尾再添加一个脚部:

以额外的空间换取反向遍历列表功能,可以实现常量时间的合并,并且块可以与前后的块合并
显式空闲链表
已分配的块与隐式空闲链表中的一样,空闲的块则增添两个指针:

分配

释放
相比隐式空闲链表,显式空闲链表只维护==空闲块链表==。空闲块链表可采取的排序策略有:
- 后进先出:将新释放的块放在链表的开始处
- 优点:简单并且常数时间就能完成释放
- 缺点:会有更多随便
- 地址排序:插入空闲块后列表中的地址总是排序的
- 优点:碎片少
- 缺点:释放时需要搜索
比较
与隐式列表相比:
- 分配时间与空闲块的数量成线性时间,而不是所有的块
- 由于从列表中删除和向链表中插入块,分配和释放稍微复杂一些
- 链接需要一些额外的空间,会增加内部碎片
分离的空闲列表
每个不同大小类块有自己的空闲列表:

通常比较小的块有自己单独的类;对于比较大的块,每个2的指数区间有一个类
垃圾收集
应用程序不用负责释放,自动回收堆中分配的内存块
假设
- 内存管理器能够区分指针和非指针
- 所有的指针指向块的开始地址
- 不能隐藏指针
基本知识
垃圾收集器将内存视为一张有向可达图,该图的节点被分成一组根节点和一组堆节点:
- 每个堆节点对应于堆中的一个已分配块
- 有向边
意味着块 中的某个位置指向块 中的某个位置 - 根节点包含指向堆中的指针,可以是寄存器、栈里的变量,也可以是虚拟内存中读写数据区域内的全局变量

如果从根节点到某个节点有路径,则这个节点是可达的;没有路径则是不可达的
不可达的都是垃圾
垃圾收集算法
- 标记清除算法:一直使用malloc到空间不够用,之后先标记,再清除
- 引用计数算法
- 拷贝收集算法
- 按代垃圾收集算法
内存相关的风险和陷阱
- 间接引用问题指针
- 使用未初始化内存
- 允许栈缓冲区溢出
- 假设指针和它们指向的对象是相同大小的
- 造成错位错误
- 引用指针而不是它所指向的对象
- 误解指针运算
- 引用不存在的变量
- 引用空闲堆块中的数据
- 引起内存泄漏
Chapter 10 系统级I/O
Unix I/O
一个Linux文件就是一个
并且,所有的I/O设备都被模型化文件,所有的输入输出也都被当作对I/O设备对应文件的读写。这种将设备映射成文件,允许Linux内核引出一个简单、低级的应用接口,称为Unix I/O:
- 打开/关闭文件:
open()/close() - 读/写文件:
read()/write() - 改变当前文件位置,指明下次读或写操作的文件偏移位置
文件
每个文件都有一种类型:
-
==普通文件==:包含任意的数据。应用程序通常把文件进一步分为文本文件和二进制文件
- 文本文件是仅仅包含ASCII或统一编码字符的普通文件,是文本行的序列。文本行是以换行字符(‘\n’)结束的字符序列
- 二进制文件可以包含一切内容
对于内核来说,文本文件和二进制文件没有区别
-
==目录==:相关文件组的索引
目录由链接数组构成,每个链接映射一个文件名到文件
每个目录至少包含两个条目:"."链接到自身,".."链接到父目录
-
==套接字==:用于和另外一台机器上的进程通信
除此之外还有命名管道、符号链接、字符/块设备,在本课程中不讨论
Linux内核将所有文件都组织成一个==目录层次结构==,由名为"/"的根目录确定

内核为每个进程维护==当前工作目录==(cwd)来确定其在目录层次结构中的位置
目录层次结构中的位置用==路径名==来指定:
- 绝对路径名:以一个斜杠开始,表示从根节点开始的路径
- 相对路径名:以一个文件开始,表示从当前工作目录开始的路径
文件操作
打开文件
#include <sys/types.h>
#include <stat.h>
#include <fcntl.h>
// 成功返回文件标识符,失败则返回-1
int open(char *filename, int flags, mode_t mode);
Linux shell创建的每个进程存活期都有三个打开文件,这些文件和终端设备相关联:
- 0: 标准输入(stdin)
- 1: 标准输出(stdout)
- 2: 标准错误(stderr)
open总是返回最低的未打开的描述符,也就是从3开始
关闭文件
#include <unistd.h>
int close(int fd);
注意关闭一个已经关闭的文件在线程化的程序中将导致灾难
读/写文件
#include <unistd.h>
// 成功返回读的字节数,若EOF则为0,出错为-1
ssize_t read(int fd, void* buf, size_t n);
// 成功返回写的字节数,出错为-1
ssize_t write(int fd, const void *buf, size_t n);
read函数从描述符为fd的当前文件位置复制最多
write函数从内存位置buf复制最多
不足值
- 读文件时需要EOF会返回不足值(此处会是0)
- 从终端读文本行:如果打开文件是和终端相关联的,那么每个
read函数将一次传送一个文本行 - 读/写网络套接字:内部缓冲约束和较长的网络延迟会导致返回不足值
以下情况不会发生不足值:
- 从磁盘文件读(除了EOF)
- 写入磁盘文件
读取元数据和目录
读取元数据
元数据是关于数据的数据,文件的元数据由内核维护,用户可以用函数stat和函数fstat访问:
#include <unistd.h>
#include <sys/stat.h>

int stat(const char* filename, struct stat *buf);
int fstat(int fd, struct stat *buf);
函数stat通过文件名访问文件元数据;函数fstat通过文件描述符访问
读取目录
应用程序可以用readdir系列函数来读取目录的内容
#include <sys/types.h>
#include <dirent.h>

struct dirent *readdir(DIR *dirp);
DIR *opendir(const char *name);
int closedir(DIR *dirp);
共享文件
内核用三个相关的数据结构来表示打开的文件:
-
==描述符表==:每个进程一个
表项由文件描述符索引,指向文件表中的一个表项
-
==文件表==:所有进程共享
每个文件表的表项包括文件位置、引用计数、一个指向v-node表中对应表项的指针
关闭一个文件会使得文件表中该文件引用计数-1,直至引用计数变为0时内核才会将该表项删除
-
==v-node==表:所有进程共享
每个表项包含
stat结构中的大多数信息
示例,当某进程3/4描述符指向磁盘上同一个文件时的共享:

I/O重定向
Linux Shell提供了I/O重定向操作符,允许用户将磁盘文件和标准输入输出联系起来,例如:
# 把ls的结果保存在foo.txt中
linux> ls > foo.txt
实现方式是使用dup2函数:
#include <unistd.h>

int dup2(int oldfd, int newfd);
dup2函数会赋值描述符表表项oldfd到描述符表表项newfd,覆盖描述符表表项newfd以前的内容
- 打开重定向目标文件
- 调用
dup2函数

RIO(robust I/O)包
自动处理不足值,提供两种函数:
- 二进制数据的无缓冲输入和输出:特别适用于在网络套接字上传输数据
- 文本行和二进制数据的缓冲输入:从部分缓存在内部内存缓冲区中的文件中有效读取文本行和二进制数据
为何加入缓冲
应用程序通常一次读写一个字符,如果每次需要读写的时候都调用Unix I/O,因为Unix I/O需要调用内核,这会消耗大量的时间。比如:
- 从文件中一个一个读出字符,每次都调用
read - 向文件中一个一个写入字符,每次都调用
write
显然这是一种纯纯杀软的行为,我们应该建立一个缓冲区,想要读字符时先调用read并把结果保存在这个缓冲区,下次读时先从缓冲区里读,一直到把缓冲区读完位置;写时同理,先向缓冲区内写,遇到"\n"时或者写满时再调用write写入文件中
标准I/O
C语言定义了一组高级I/O函数,称为标准I/O库,例如:
- 打开和关闭文件(fopen and fclose)
- 读和写若干字节(fread and fwrite)
- 读和写文本行 (fgets and fputs)
- 格式化读和写(fscanf and fprintf)
标准I/O库将一个打开的文件模型化为一个==流==,对于程序员而言一个流就是一个指向FILE类型的指针。流实际上是对文件描述符和流缓冲区的抽象。C程序开始时会有三个打开的流:
- stdin (标准输入)
- stdout (标准输出)
- stderr (标准错误)
该如何选择I/O函数

- 只要有可能就使用标准I/O
- 不要使用scanf或者rio_readlineb来读取二进制文件
- 对网络套接字的I/O使用RIO函数
- 对磁盘或终端文件使用标准I/O
- 信号处理程序内部使用Unix I/O
| 特性 | Unix I/O | 标准 I/O (stdio) | 健壮 RIO |
|---|---|---|---|
| 接口类型 | 文件描述符 | FILE* 流 | 文件描述符 |
| 缓冲 | 无 | 有 | 可无/可缓冲 |
| 稳健性 | 可能短读/短写 | 由库处理 | 处理短读短写、信号中断 |
| 性能 | 每次系统调用开销大 | 缓冲提高效率 | 适用于网络/文件,保证可靠性 |
| 用途 | 低级 I/O、系统编程 | 文本处理、一般文件 I/O | 网络编程、高可靠读写 |
Chapter 11 网络编程

客户-服务器事务: Client-Server Transaction
多数网络应用基于客户-服务器模型:
- 一个服务器进程和一个或多个客户进程
- 服务器管理一些资源
- 服务器通过操作资源为客户提供服务
- 服务器由来自客户的请求激活

计算机网络
==网络==是一个按地理邻近度组织的盒子和电线的分层系统
- LAN
- WAN
对主机而言,网络只是一种设备,扩展在I/O总线上
以太网
以太网段由一组通过电缆(双绞线)连接到集线器的主机组成
- 每个以太网适配器都有一个唯一的48位地址(MAC地址)
- 主机以称为==帧==的块向任何其他主机发送比特
- 集线器(现在是交换机、路由器)将每个位从每个端口复制到每个其他端口
网桥连接的以太网
网桥能够了解哪些主机可以从哪些端口访问,然后有选择地将帧从一个端口复制到另一个端口

局域网
集线器、网桥和电缆通常显示为连接到单个电缆的主机集合

互联网络 internet
多个不兼容的局域网可以通过称为==路由器==的专用计算机进行物理连接

internet可以采用完全不同和不兼容技术的各种局域网和广域网组成。在这里,LAN1和LAN2可能完全不同,但是这并不影响它们通过router和WAN互相收发消息
但是怎么能让某台源主机,跨过所有这些不兼容的网络发送数据到另一台目的主机呢?
在每个主机和路由器上运行协议软件
互联网络协议
这种协议必须提供两个基本能力:
- 命名机制:为每个主机(和路由器)分配至少一个唯一标识它的互联网络(网际)地址
- 传送机制
通过封装传输互联网络数据

但这并不能解决所有的问题,比如:
- 如果不同的网络具有不同的最大帧大小该怎么办?
- 路由器如何知道向哪里转发帧?
- 当网络拓扑发生变化时,如何通知路由器?
- 如果分组丢失了怎么办?
Internet
基于TCP/IP协议簇实现
- IP:提供基本命名方案和主机之间不可靠分组(数据报)传输能力
- UDP:使用IP提供进程之间不可靠数据报传输
- TCP:使用IP提供在连接上进程之间可靠的字节流

对于程序员来说,可以把Internet看做一个世界范围的主机集合:
- 主机集合被映射为一组32位的IP地址
- 这组IP地址被映射为一组称为因特网域名的标识符
- 因特网主机上的进程能够通过连接和任何其他因特网主机上的进程通信
IP地址
32位IP地址存储在IP地址结构中
- IP地址始终以网络字节顺序(大端字节顺序)存储
- 采用点分十进制记法
域名
32位长的IP地址难记,所以使用相对容易记忆的==域名==来映射IP

IP与域名之间的映射由==DNS==(Domain Name System)来维护。DNS由上百万条主机条目结构组成,其中每条定义了一组域名和一组IP地址之间的映射
连接
客户端和服务器通常通过TCP连接发送字节流进行通信。每个连接是:点对点的、全双工的、可靠的
套接字是连接的端点,套接字地址是"IP:port"。IP前面讲过,==端口==是一个16位整数,用于标识进程
连接由其端点(套接字对)的套接字地址唯一标识:
套接字接口
套接字接口是与Unix I/O结合使用的一组系统级函数,用于构建网络应用程序

套接字地址结构
- 对于内核来说,套接字是通信的端点
- 对于应用程序,套接字是一个文件描述符,它允许应用程序从网络读取/向网络写入
struct sockaddr_in{
    uint16_t 		sin_family;
    uint16_t 		sin_port;
    struct in_addr	sin_addr;
    unsigned char	sin_zero[8]
}

struct sockaddr{
    uint16_t	sa_family;
    char		sa_data[14];
}
通用套接字地址:

互联网(IPv4)特定套接字地址:
- 再函数使用套接字地址参数的时候,必须强制转换

主机和服务转换
getaddrinfo
getaddrinfo是将主机名、主机地址、端口和服务名的字符串表示转换为套接字地址结构的现代方法
- 可重入
- 同时适用于IPv4和IPv6,提升代码可移植性
int getaddrinfo(const char *host, 				/* Hostname or address */
				const char *service, 			/* Port or service name */
				const struct addrinfo *hints,	/* Input parameters */
				struct addrinfo **result); 		/* Output linked list */
getaddrinfo返回结果为指向addrinfo结构的链表,每个addrinfo结构指向对应的套接字地址结构,并且包含套接字接口函数的参数
getnameinfo
getnameinfo的功能与getaddrinfo的功能相反,它将一个套接字地址转换成对应的主机和服务
具体接口
- socket
- bind
- listen
- accept
- connect

Web服务器
客户和服务器使用超文本传送协议(HTTP)通信
- 客户和服务器建立TCP连接
- 客户请求内容
- 服务器对请求内容进行响应
- 客户和服务器关闭连接
Web内容
Web服务器返回内容给客户,内容可分为静态与动态:
-
静态内容:存储在文件中并响应HTTP请求检索的内容
如HTML文件、图像、音频剪辑、Javascript程序等;请求标识哪个内容文件
-
动态内容:响应HTTP请求而动态生成的内容
如由服务器代表客户端执行的程序生成的内容;请求标识包含可执行代码的文件
每条由Web服务器返回的内容都与它管理的某个文件相关联,这些文件都有一个唯一的名字叫做==URL==(通用资源定位符)
HTTP事务
HTTP请求
HTTP请求是一个请求行,后跟零个或多个请求首部,再跟随一个空行来终止包头列表
请求行的格式为:method URI version
HTTP响应
HTTP响应是一个响应行,后跟零个或多个响应报头,再跟随一个终止响应报头列表的空行,再跟随一个响应主体
响应行的格式为:version status-code status-message
服务动态内容
使用==CGI==解决参数传递、输出传递等棘手的问题
Chapter 12 并发编程
并发编程
三种构造并发程序的方法:
- 进程:内核自动调度多个逻辑流,每个流都有自己的私有地址空间
- I/O多路复用:程序员手动管理控制流,所有流共享同一个地址空间
- 线程:内核自动调度逻辑流,每个流共享同样的地址空间
基于进程的并发编程
以fork函数为核心启用新进程,有以下几点需要特别注意:
-
回收所有僵尸子进程(
SIGCHLD) -
及时回收不用的文件描述符
比如fork之后,父进程要关闭connfd,子进程要关闭listenfd,因为这两个描述符用不到了
-
直到父进程与子进程的connfd都关闭了,到客户端的连接才会停止
优点:
- 可以并发处理多个连接
- 共享模型比较清晰
- 简单并直观
缺点:
- 进程控制引入额外开销
- 进程之间共享数据比较麻烦
基于I/O多路复用的并发编程
重复以下步骤:
- 检查哪个描述符有等待的输入
- 如果listenfd有输入,则accept连接
- 对所有有挂起输入的connfd进行处理
优点:
- 可以进行单步调试
- 没有进程或者线程控制开销
缺点:
- 与基于进程或线程的设计相比代码更加复杂
- 难以实现细粒度并行
- 无法利用多核的优势
基于线程的并发编程
一个进程可以有多个线程:
- 线程就是运行在进程上下文中的逻辑流
- 每个线程共享同样的代码、数据和内核上下文
- 每个线程有局部变量的本地栈
- 每个线程有自己的ID
- 与一个进程关联的所有线程构成一个对等线程池
线程并行的切换开销比进程切换小
Posix线程
Pthreads提供了很多关于线程操作的函数
- 创建和回收线程:
pthread_create(),pthread_join() - 确定线程ID:
pthread_self() - 终止线程:
pthread_cancel(),pthread_exit(),exit()
共享变量
线程内存模型
寄存器是从不共享的,而虚拟内存总是共享的
变量映射到内存
- 全局变量:在虚拟内存中只有一个实例
- 局部非静态变量:每个线程栈都有一个局部变量实例
- 局部静态变量:虚拟内存中只有一个局部静态变量实例
共享变量
如果一个变量,它至少有一个实例被多个线程引用,那么这个变量就是==共享变量==。显然局部非静态变量不可能是共享变量
使用信号量同步线程
多个线程并发的执行,我们没有办法确定它们之间的顺序
进度图
用来分析多个进程的并发行为,一个进度图描述了并发线程离散的执行状态空间
- 每个轴对应每个线程中指令的执行顺序
- 每个点对应一个可能的执行状态
- 一个轨迹是一系列合法的状态转换,描述了线程一个可能的并发执行过程

线程中一些指令的执行会形成临界区,临界区中的指令不应该交叉执行,那些可能出现这种交叉的状态集就是不安全区域

一个轨迹是安全的只有当其不进入任何不安全区域;只有当一个轨迹是安全的才是正确的
信号量
信号量:非负全局整型同步变量,由P和V操作
使用P/V操作可以阻止程序进入禁止区,而不安全区域一定被包含在禁止区内,所以P/V操作避免了并发错误
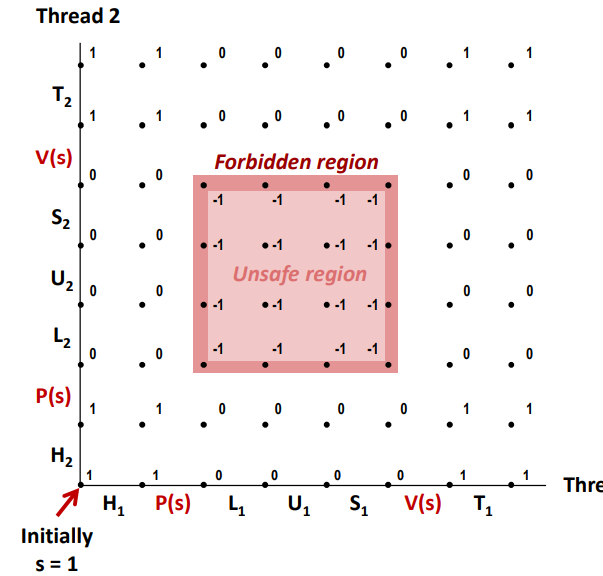
刻画并行程序的性能
定义:
加速比
这个公式有时也被称为==强扩展==
- 如果
是并行版本代码在1个核上的运行时间,那么 代表相对加速比 - 如果
是串行版本代码在1个核上的运行时间,那么 代表绝对加速比
通常认为绝对加速比能够更加真实的表示并行加速收益
并行效率
效率是对由于并行化所造成的开销的衡量,高效率的程序在同步和通信上花费的时间更少
阿姆达尔定律
:串行运行时间 :可并行加速比例 :加速因子
得到: