 SUN
本次考试的重点内容是基本原理和实验,所列出的内容要深入理解基本概念(没有列出的内容基本不考),这些基本概念包括实验中的很多内容,如:如何设置NameNode。除此之外,还要求掌握HDFS、HBase的基本操作命令。请大家在准备考试时按下面内容进行,特别是实验部分。
一、 大数据基本概念
-
大数据特征
-
大数据面临的挑战
-
关系数据库与NoSQL数据库的差异
-
大数据库关键技术
-
大数据处理流程
-
大数据系统架构
二、 Hadoop
-
什么是Hadoop
-
Hadoop的核心架构
-
Hadoop生态圈
-
Hadoop的优点
-
Hadoop处理大数据的优势
三、 什么是HDFS
-
HDFS的目标
-
HDFS体系结构
-
HDFS块副本
-
HDFS元数据
-
HDFS读写流程
-
HDFS访问方式
四、 什么是HBase
-
HBase的特点
-
HBase处理大数据
-
HBase体系结构
-
HBase数据模型
-
行式存储与列式存储的区别
-
HBase日志
-
HBase读写流程
五、 MapReduce
-
MapReduce是什么?
-
MapReduce体系架构与处理流程
-
MapReduce分区
-
MapReduce如何在分布环境中处理词频统计、倒排索引
六、 实验部分
-
Hadoop本地、伪分布与全分布部署模式
-
HDFS上传文件(原理与分析命令)
-
配置文件及具体的使用方法
-
MapReduce的主要接口
-
MapReduce实现倒排索引(原理及代码分析)
-
MapReduce如何实现移动计算?
-
HBase写入记录的过程(原理与分析代码)
-
Hadoop进行开发搜索引擎的优势
注:不要求写代码、安装、部署等相应的命令,给出代码、命令能够识别与分析,例如,能够识别Mapper接口方法、该接口的作用及使用方法(例如,分析代码)。
大数据考试复习
大数据基本概念
大数据特征
4V特征:
-
Volume
数据量大,非结构化的数据增长速度快
-
Variety
数据多样,有很多不同形式(文本,图像,视频,机器数据)
-
Value
价值密度低,大量不相关信息
-
Velocity
速度要快,实时分析而非批量分析
大数据面临的挑战
- 数据量指数级增加,低密度,高价值
- 数据结构日趋复杂:半结构化数据爆发式增长
关系数据库与NoSQL数据库的差异
-
存储方式不同
-
关系型数据库主要存在磁盘中;
-
NoSQL主要存在内存中
-
-
存储结构不同
-
关系型数据库采用表格,按照结构化方法存储数据;
-
NoSQL采用键值对、列、文档和图等结构存储
- 键值对存储:查询速度快
- 列示存储:查找速度快,更容易进行分布式拓展
- 文档存储: 数据结构要求不严格,表结构可变
- 图结构存储:高效匹配图结构相关算法
-
-
存储规范不同
- 关系数据库把数据按照最小关系表的形式进行存储;
- NoSQL采用平面数据集的方式集中存放
-
扩展方式不同
- 关系数据库只具备纵向扩展能力;
- NoSQL因为其是以平面数据集的方式存放数据,也就可以添加更多服务器到资源池,以横向的方式扩展
-
查询方式不同
- 关系型数据库使用SQL进行查询,结构化查询
- NoSQL没有统一标准,非结构化查询
-
规范化不同
-
关系型数据库需要数据规范
-
NoSQL不需要对数据规范化,鼓励冗余
-
-
事务性不同
- 关系型数据库强调原子性、一致性、隔离性和持久性
- NoSQL一般不强调数据性
-
读写性能不同
- 关系型数据库为保证数据的一致性牺牲了大量读写性能;
- NoSQL在一些场景下的性能远超关系型数据库
-
并发支持
- 关系数据库,通过事务和锁来支持并发,高并发情况下执行效率低
- Nosql,打破事务一致性,并发性能高
大数据库关键技术
-
数据采集技术
如ETL工具
-
大数据存储技术
关系数据库、NoSQL
-
大数据管理技术
-
大数据分析与挖掘技术
大数据处理流程
-
数据采集
-
数据存储
如HDFS
-
数据处理
如MapReduce
-
数据分析与挖掘
-
数据可视化与决策
大数据系统架构
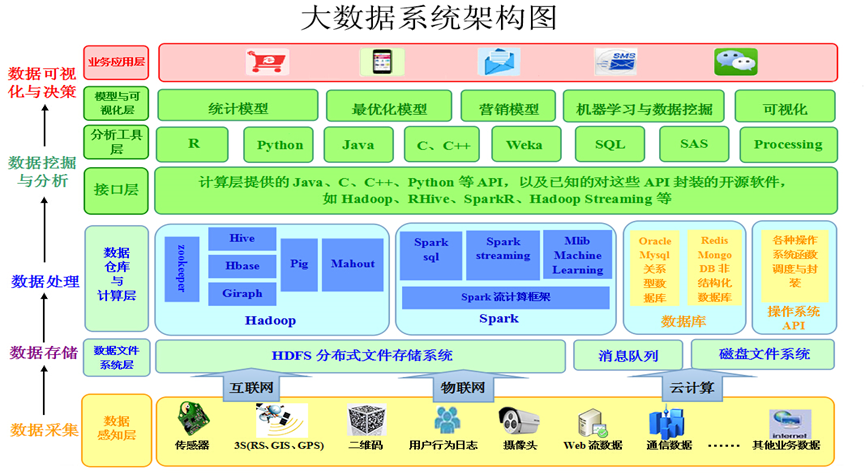
Hadoop
什么是Hadoop
一个能够对大量数据进行分布式处理的软件框架,一个能够让用户轻松架构和使用的分布式计算平台,用户可以轻松地在Hadoop上开发和运行处理海量数据的应用程序
Hadoop的核心架构
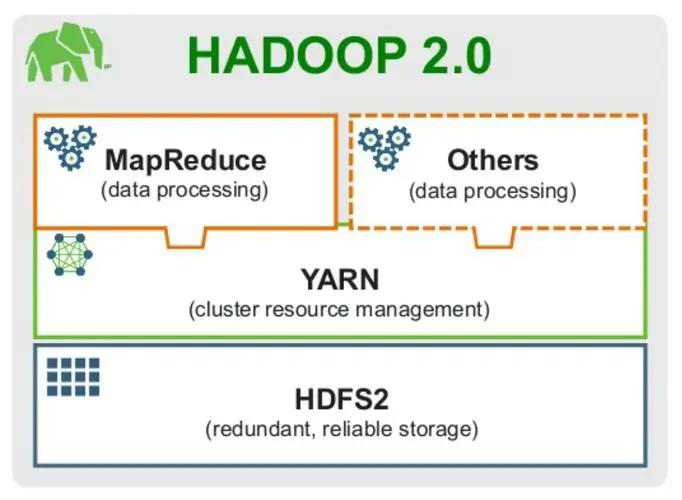
HDFS、Yarn(智能分配任务)、MapReduce(为海量数据提供了计算框架)
Hadoop生态圈
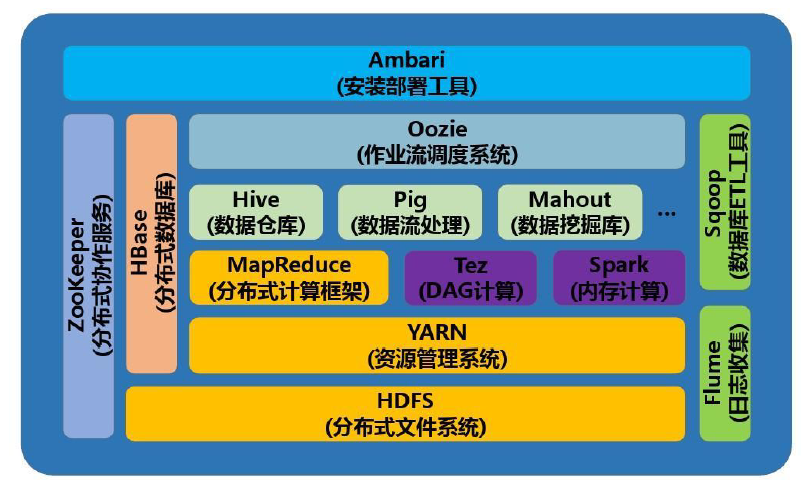
- HBase
- Hive
- Pig
- ZooKeeper分布式协调服务
- Ambari
- Sqoop
- Mahout
Hadoop的优点
-
高可靠性
可以自动保存数据的多个副本。可以自动将失败的任务重新分配
-
高扩展性
在可用的计算机集簇间分配数据并完成计算任务,这些集簇可以方便德拓展到数以千计的节点中
-
高效性
Hadoop可以在各节点间动态移动数据,实现节点间的动态平衡,因此处理速度非常快
-
高容错性
Hadoop自动保存数据的多个副本,并能将失败的任务重新分配
-
低成本
通过廉价的机器组成服务器集群来分发处理数据,成本低
hadoop开源,软件成本低
Hadoop处理大数据的优势
-
在数据提取、变形和加载方面上的天然优势
-
分布式架构
-
MapReduce功能实现了将单个任务打碎,并将碎片任务发送到多个节点上,之后再以单个数据集的形式加载到数据仓库里
HDFS
什么是HDFS
HDFS 是一种分布式文件系统,用于处理在商业硬件上运行的大型数据集。
- 它用于将单个 Apache Hadoop 集群扩展到数百 甚至数千个节点。
- HDFS 是 Apache Hadoop 的主要组件之一,其他组件包括 MapReduce 和 YARN。
- HDFS是用Java编写的,任何支持Java的机器都可以部署HDFS。
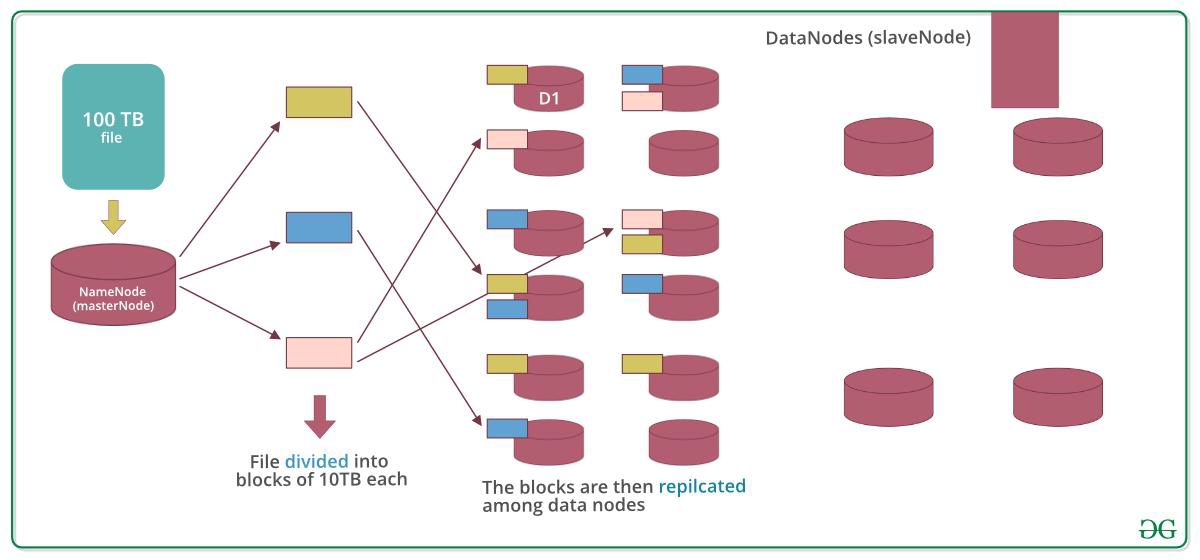
HDFS的目标
-
硬件故障
硬件故障是常态,而不是异常。整个HDFS系统将由数百或数千个存储着文件数据片段的服务器组成。HDFS里总是有一些部件是失效的。
故障检测与自动快速恢复是HDFS一个很核心的设计目标。
-
实现流式数据访问
运行在HDFS之上的应用程序必须流式地访问数据集,这些不是运行在普通文件系统之上的普通应用。重点在于数据吞吐量,而不是数据访问的反应时间。
-
大数据集
典型的HDFS文件大小是GB到TB的级别。HDFS被调整为支持大文件。它应该提供很高的聚合数据带宽,一个集群中支持数百个节点,一个集群中还应该支持千万级别的文件。
-
简单一致性模型
大部分的HDFS程序对文件操作需要的是一次写多次读的操作模式;一个文件一旦创建、写入、关闭之后就不需要修改了。这个简单化了数据一致的问题,这样的假定使得高吞吐量的数据访问变得可能
-
移动计算
在靠近计算数据所存储的位置进行计算,消除网络拥堵,提高系统的整体吞吐量。
-
异构软硬件平台间的可移植性
HDFS被设计成可以简便地实现平台间的迁移。
HDFS体系结构
来个图先:

在上图我们可以了解到HDFS有以下这些组成部分:Client, NameNode, DataNode,以及承载数据的实体磁盘,下面将对除了磁盘的其他部分的功能进行概述
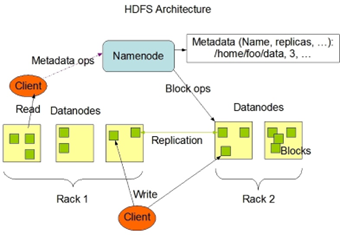
Namenode、client、datanode通信协议:建立在TCP/IP之上。
Client
-
文件切分
Client将上传的文件切分成一个一个的Block,可以提高硬盘的效率,同时Block也是该文件系统中数据的读写单位
数据块的信息对于用户来说是透明的,HDFS默认的数据块大小是64MB,实际部署中默认会被设置为128M甚至更多以更好的支持大文件
-
与NameNode和DataNode交互
与NameNode交互获取文件的位置,与DataNode交互来读取和写入数据
-
管理HDFS
NameNode
client之间的协议:Client Protocol;
-
管理HDFS的元数据
HDFS的元数据包括命名空间(整个HDFS的目录结构),数据块与文件名的映射表,每个数据块副本的位置信息(每个数据块默认3个副本)等;缺失这些元数据相当于缺失了HDFS中所存储的所有数据
-
管理数据块映射信息
-
处理客户端的读写请求
当NameNode启动时,首先装载fsImage文件,然后按照EditLog中的记录执行一遍所有记录的操作,最后把信息的目录树写入fsImage中,并删掉EditLog文件,重新启用新的EditLog文件。
DataNode
- 存储实际的Block
- 执行数据块的读、写操作
- 执行块的创建、删除和来自NameNode的块复制指令
当DataNode启动时,它将扫描其本地文件系统,生成与每个本地文件相对应的所有HDFS数据块的列表,并将此报告发送到NameNode。
HDFS块副本
每一个文件都可以配置块副本数量,默认是3
Datanode向namenode发送的块报告包含数据节点所拥有的数据块的列表。
副本作用
设置副本可以防止某个datanode故障而导致的数据丢失,也可以通过多副本来提升读取的速度
副本放置策略
HDFS的副本放置策略是将第一个副本放在本地节点,将第二个副本放到本地机架上的另外一个节点而将第三个副本放到不同机架上的节点
副本选择
由近到远,同机架优先,本地优先
HDFS元数据
元数据实际上就是指==数据的属性==,元数据由NameNode维护,目前有三种存储方式:
-
内存元数据
为提升性能,定期从磁盘加载一份镜像到内存中
-
命名空间镜像文件(fsImage)
保存整个文件系统的目录树
-
编辑日志文件(EditLog)
记录文件系统元数据发生的所有更改,如文件的删除或添加等操作信息
元数据存储的持久化
NameNode使用叫做==EditLog==的事务日志来持久记录每一个对文件系统元数据的改变,如在HDFS中创建一个新的文件,NameNode将会在EditLog中插入一条记录来记录这个改变。类似地,改变文件的复制因子也会向EditLog中插入一条记录。名字节点在本地文件系统中用一个文件来存储这个EditLog。整个文件系统命名空间,包括文件块的映射表和文件系统的配置都存在一个叫==fsImage==的文件中,FsImage也存放在名字节点的本地文件系统中。
FsImage和EditLog是HDFS的==核心数据结构==。这些文件的损坏会导致整个集群的失效。因此,NameNode可以配置成支持多个FsImage和EditLog的副本。任何FsImage和EditLog的更新都会同步到每一份副本中。
NameNode在内存中保留一个完整的文件系统命名空间和文件块的映射表的镜像。这个元数据被设计成紧凑的,这样4GB内存的NameNode就足以处理非常大的文件数和目录。NameNode启动时,它将从磁盘中读取FsImage和EditLog,将EditLog中的所有事务应用到FsImage的仿内存空间,然后将新的FsImage刷新到本地磁盘中,因为事务已经被处理并已经持久化的FsImage中,然后就可以截去旧的EditLog。这个过程叫做检查点。当前实现中,检查点仅在名字节点启动的时候发生,正在支持周期性的检查点。
HDFS数据组织
HDFS设计是用于支持大文件的,其典型的块大小为64MB,但经常被调为128MB
HDFS读写流程
写流程
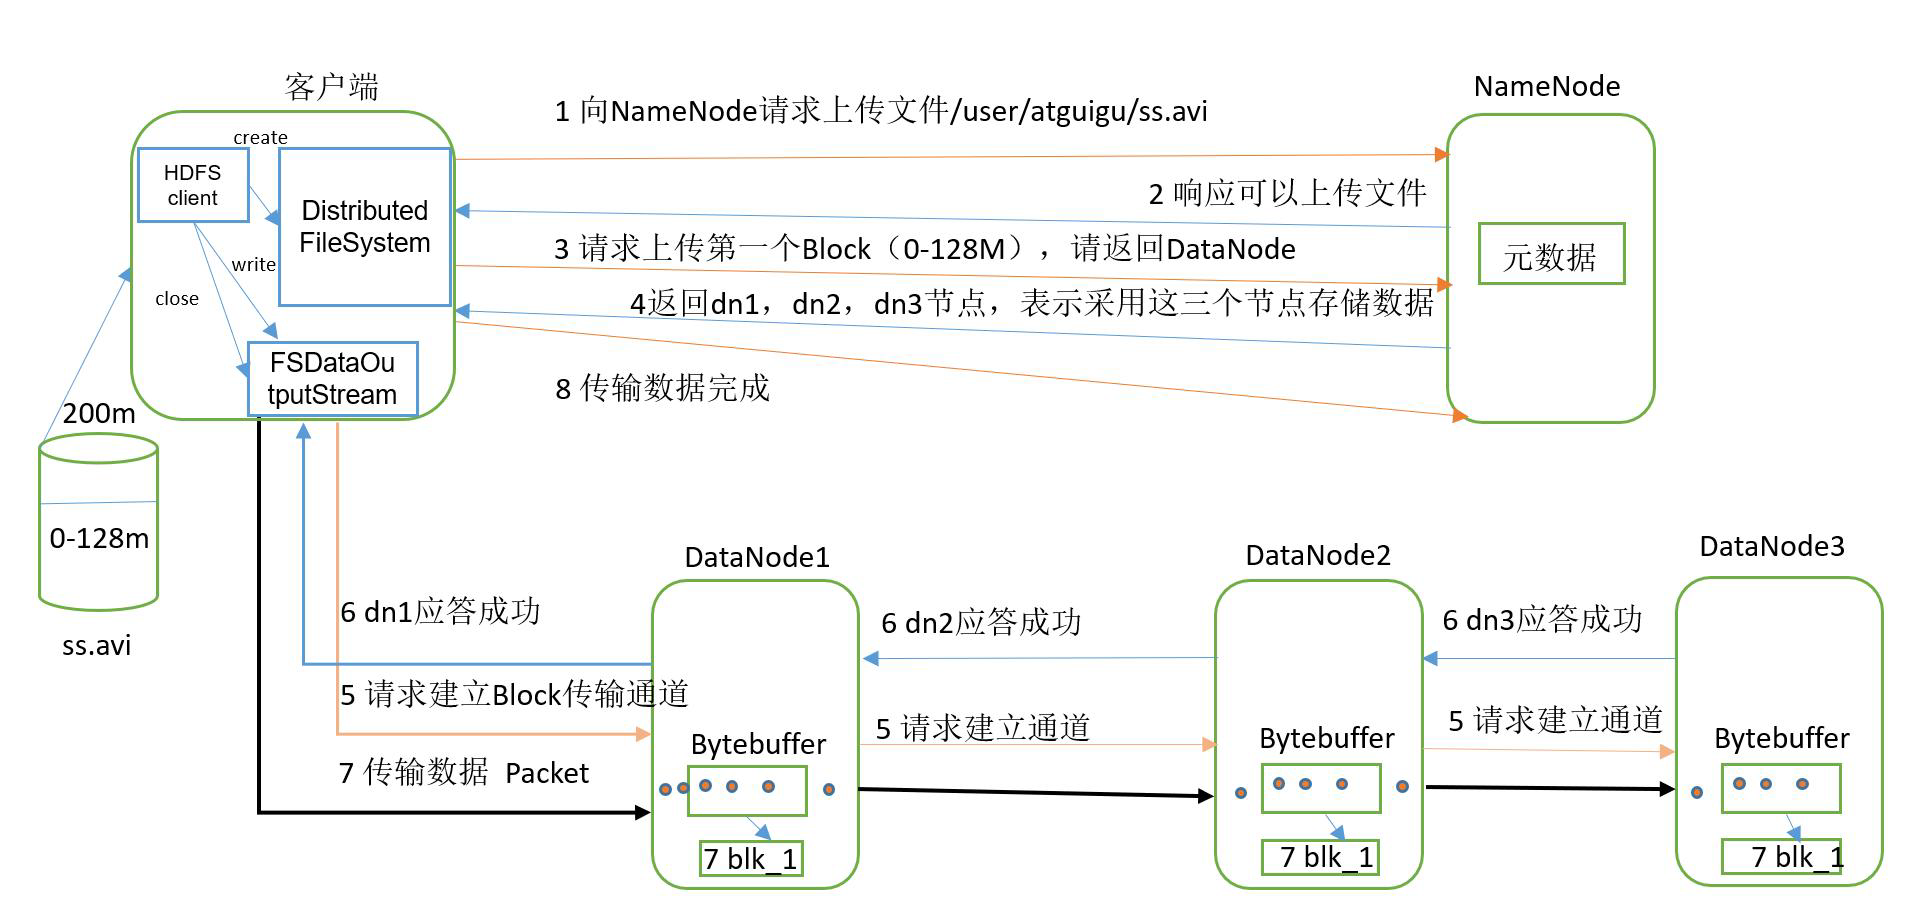
- client向HDFS发起写文件请求
- 将创建的命令告知NameNode
- client把文件块写入到本地的输入流
- 把数据从输入流写入DataNode
- 收到DataNode对于写操作的响应信息
- 关闭输入流
- 告诉NameNode写流程已经完成
读流程
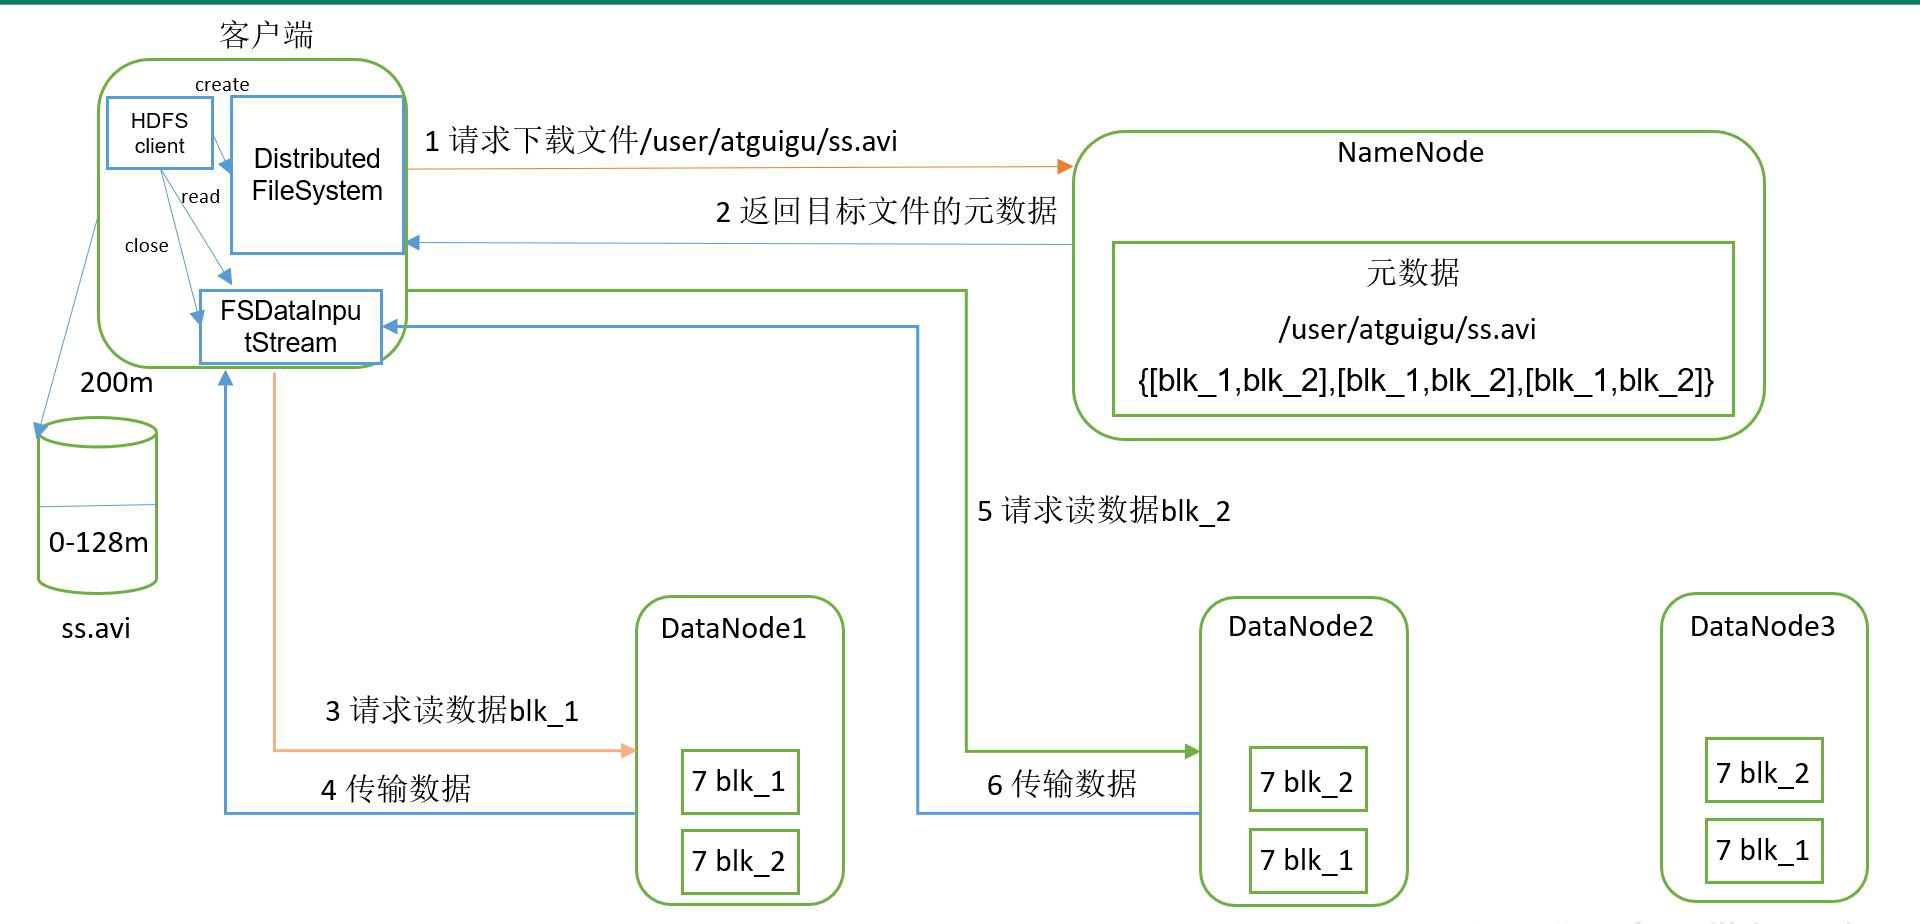
- 第1步:client提交读操作
- 第2步:向NameNode请求文件块的位置,若该client有相关文件的权限,则会返回存放数据块的节点信息
- 第3-5步:客户端在拿到NameNode所返回的目标块所在的DataNode信息之后,会和相关的DataNode建立输入流,读取相应数据块
- 第6步:读取完毕,按照块编号拼接为完整文件并关闭输入流
HDFS访问方式
-
DFS shell:用户可以和HDFS中的数据交互。命令集的语法类似bash
创建目录 /foodir:
hdfs dfs -mkdir /foodir
查看文件 /foodir/myfile.txt:
hadoop dfs -cat /foodir/myfile.txt
删除文件/foodir/myfile.txt hadoop:
dfs -rm /foodir myfile.txt
-
DFS admin命令集
-
web接口-
-
Java api
HBase
什么是HBase
HBase是一个面向==列式存储==的==分布式数据库==,底层存储基于 HDFS 实现,集群的管理基于 ZooKeeper 实现。
HBase良好的分布式架构设计为海量数据的快速存储、随机访问提供了可能,基于数据副本机制和分区机制可以轻松实现在线扩容、缩容和数据容灾,是大数据领域中 Key-Value 数据结构存储最常用的数据库方案。
HBase的特点
-
易扩展
可以通过增加RegionServer节点的数量提升HBase上层的处理能力
也可以通过增加HDFS中DataNode节点的数量来对存储扩容
-
海量存储
面向 PB 级别数据的实时入库和快速随机访问
-
高可靠性
WAL机制保证了数据写入时不会因集群异常而导致写入数据丢失;Replication 机制保证了在集群出现严重的问题时,数据不会发生丢失或损坏
-
稀疏性
在HBase的列族中,可以指定任意多的列,为空的列不占用存储空间,表可以设计得非常稀疏
HBase体系结构
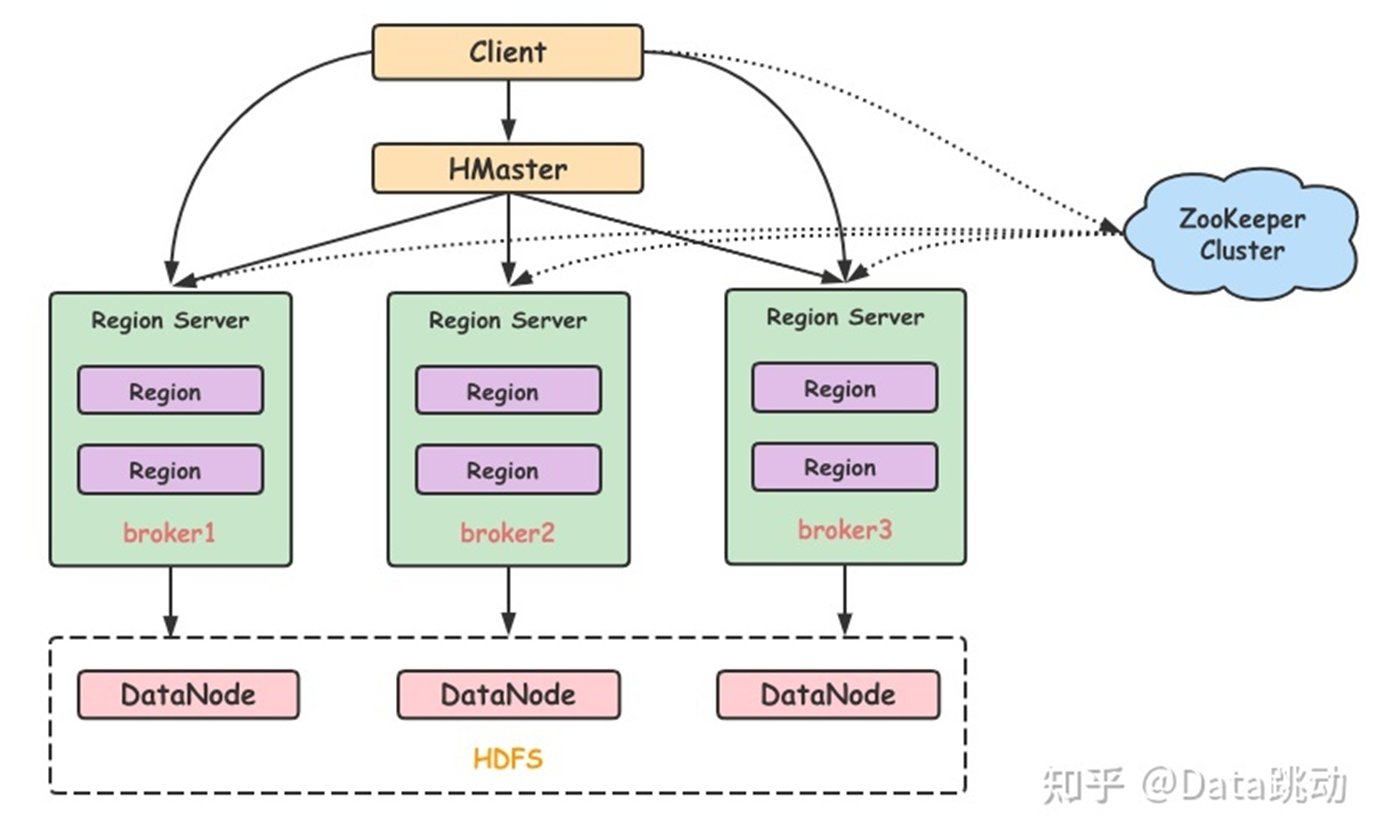
HBase集群主要由HMaster、Region Server和ZooKeeper组成
Client
Client为用户提供了访问 HBase 的接口,可以通过元数据表来定位到目标数据的 RegionServer
HMaster
-
负责管理RegionServer以实现负载均衡
面对数据存储,HMaster讲用户的数据均衡地分布在各个RegionServer上
面对数据请求,HMaster讲数据的请求均衡地分配给各个RegionServer
-
管理和分配Region
当某一个Region变大超过阈值之后进行Spilt时分配新的Region
RegionServer退出时把其中的Region迁移到其他RegionServer上
-
管理namespacce和table的元数据
-
权限控制
RegionServer
直接面向用户的读写请求
- 存放和管理本地Region
- 负责Region变大超过阈值之后的拆分
- 读写HDFS,管理Table中的数据
- Client从HMaster中获取元数据,找到RowKey 所在的RegionServer进行读写数据
ZooKeeper
HBase 通过 ZooKeeper 来完成选举HMaster、监控RegionServer、维护元数据集群配置等工作,存放整个HBase集群的元数据以及集群的状态信息
Region
Region是HBase中分布式存储和负载均衡的最小单元
Region由多个store构成,每个store包含MemStore和StoreFile:
- StoreFile:存储有序的Key-Value文件,存储在HDFS上
- MemStore:写缓存,键值对在其中进行排序和临时的存储;当MemStore的大小超过阈值时将会把其中的内容写入到一个新的StoreFile中
每个Region都有起始RowKey和结束RowKey,代表存储的Row的范围;一开始每个表都只有一个Region,但随着数据量不断增大、Region的大小超过某个阈值时,Region就会被RegionServer等分成两个新的Region,这个过程叫做Spilt
每个Region都可以对其包含的数据内容进行读写
HBase数据模型
HBase 表中,一条数据拥有一个全局唯一的键(RowKey)和任意数量的列(Column),一列或多列组成一个列族,HBase会将表按主键划分为多个 Region 存储在不同 RegionServer 上,以完成数据的分布式存储和读取

Column Family
列族,一个列族可以包含任意多的列
一般把同一类型的列放在一个列族中,每个列族都会有一组存储属性
一个表中列族的数量最好不超过3
RowKey
类似于主键,HBase除了全表查询外,只能根据RowKey或者RowKey的范围来查询
TimeStamp
用于实现HBase多版本,使用不同的TimeStamp可以标识相同RowKey不同版本的数据
行式存储与列式存储的区别

从上图就可以看出行式存储与列式存储在底层存储组织方式上的不同,行式存储是一行一行挨着存储,而列式存储是以列为单位的存储

在数据写入时
- 行式存储的写入是一次完成
- 列式存储因为把一行记录拆分为了多列,需要写入多次
在数据写入、修改这一方面,是行式存储占优
在数据读取时
- 行式存储时将一行数据全部读出,如果只是需要其中几列数据的话,会额外损失处理数据的时间
- 列式存储只会读需要的数据
所以在数据读取这方面,是列式存储占优
数据压缩
列式存储同列的数据的类型相同,所以在对数据进行压缩时也是列式存储占优
数据压缩举例:
总结
在大数据系统中,数据读取的频率远远高于数据写入的频率,一般都是“一次写入多次读取”的情况;再加上大数据的数据量大,数据压缩也是非常关键的。列式存储在数据读取和数据压缩两个方面都相比行式存储更有优势,那么大数据系统采用列式存储的数据库也就是当然的了。

HBase读写流程
写流程
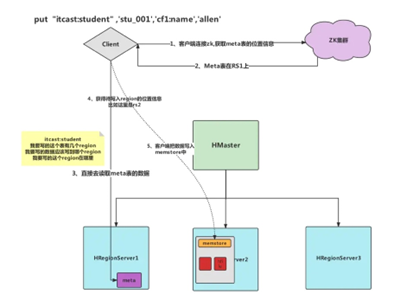
//命令格式:put 'namespace:table','rowkey','column','value'
put "BIT:ComputerScience",'114514','p1:name','lbw'
- Client访问ZooKeeper获取META表存储在哪个RegionServer
- 访问该RegionServer,读取META表
- 根据META表和要写入的Namespace、TablebName、RowKey,找到要写入的Region的信息
- 先把数据写到HLog中,再把输入写入MemStore中;若这两步操作均写入成功,则这条数据写入成功
在写入过程中,若StoreFile太多,会触发合并操作,将多个StoreFile合并为一个大的StoreFile;如果Region太大,则会触发Split操作,将Region一分为二
读流程
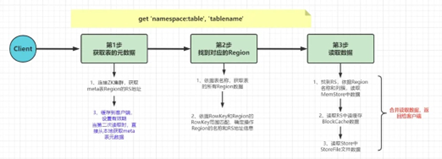
get `namespace:table`,`tablename`
-
Client访问ZooKeeper获取META表存储在哪个RegionServer
-
访问存放META的RegionServer,读取META表
META表中存储了用户表的region信息;client在读取META表之后会在本地缓存,下次读取先尝试缓存META表中的内容,失败再重新读取META
-
根据META表和要读取的Namespace、TablebName、RowKey,找到存放相应数据的region信息
-
找到存放这些Region的RegionServer并查找其中的目标Region
-
先从Region中的MemStore查询数据;若没有则再到其中的StoreFile上查询
HBase日志
在这里重点了解预写日志WAL(Write-Ahead-Log)
在把数据写到Region中之前,先把数据写到WAL中,若连写到WAL中都失败,那么这次写数据就是失败的;若成功写入WAL中,之后再把数据写入Region中,在这个过程中若写入失败,则可根据WAL中的数据重做这次写操作

除此以外,WAL与关系数据库中的日志类似,他记录所有的数据改动,通过重做其中所记录的改动,可以恢复崩溃之前的数据
MapReduce
MapReduce是什么?
Hadoop的MapReduce功能实现了将单个任务打碎,并将碎片任务(Map)发送到多个节点上,之后再以单个数据集的形式加载(Reduce)到数据仓库里
Hadoop MapReduce是一个==软件框架==,基于该框架能够容易地编写应用程序,这些应用程序能够运行在由上千个商用机器组成的大集群上,并以一种可靠的,具有==容错==能力的方式==并行地处理==上TB级别的==海量数据集==。
MapReduce体系架构

MapReduce和HDFS、HBase类似,采用了Master/Slave的架构,即:一个Master宏观把握全局信息,多个Worker微观专注细节工作
Client
client负责把job交给Master,可以有多个client同时向Master发送job
Master
master在接收到client发送的job后,负责将大的job分成小的task,并给每个task分配worker,其中包含map worker和reduce worker
Worker
负责特定的数据处理,比如map worker负责接收输入进行map操作,并将结果写到本地磁盘(这也是MapReduce后来被淘汰的原因,写磁盘太慢了)
MapReduce工作原理

Client
向JobTracker提交job,除此之外,client也会计算后输入的分片信息和作业等拷贝到 HDFS 上方便JobTracker后续读出,分片信息决定了map任务的数量
JobTracker
JobTracker负责资源监控和作业调度。
- JobTracker监控全部TaskTracker与job的健康状况。一旦发现失败,就将相应的任务转移到其它节点
- JobTracker 会跟踪任务的执行进度、资源使用量等信息,并将这些信息告诉任务调度器,而调度器会在资源出现空暇时,选择合适的任务使用这些资源
- JobTracker负责接收client提交的任务,并根据具体的分区信息决定要启动多少个TaskTracker
TaskTracker
TaskTracker受JobTracker管理,需要定期向JobTracker汇报自己的情况;同时,JobTracker会给TaskTracker分配任务,TaskTracker负责具体任务的执行
Task
task分为map task和reduce task两种,均由TaskTracker启动
如果一定量的Task失败,那么JobTracker会将这个Job标记为失败
总结
- Client 启动一个作业 Job 并向
JobTracker提交一个JobId,运行作业所需要的资源文件比如 jar 包,Client 计算后输入的分片信息等拷贝到 HDFS 上。分片信息决定了 map 任务的数量,并由JobTracker分配计算。 JobTracker接收到作业任务后,将作业放置在作业队列中,作业调度器根据自己的调度算法调度到某个作业时会跟根据分片信息,为每个分片数据创建一个 map 任务,并将 map 任务分配给TaskTracker执行。需要注意的是 map 任务并不是随意分配给TaskTracker(数据本地化Data Local:分配给含有该map任务的数据块中的tasktracker中,只有map考虑reduce不考虑,reducetasktracker根据key的hashcode%reducer数量的值分配,一个reducetask对应一个partition/region即分区)。每个节点上可以运行 map 的数量是有限的,TaskTracker根据主机核的数量和内存的大小有固定数量的 map 槽和 reduce 槽。TaskTracker会定时的向JobTracker发送心跳,若一定时间没有收到心跳,JobTracker就默认这个TaskTracker节点挂了要做资源回收,并把这个节点上的 task 重新分配到其他节点上。JobTracker会监听 task 的执行情况,执行完成,JobTracker会更新Job的状态为完成,若是一定数量的 task 执行失败,这个 Job 就会被标记为失败,JobTracker将发送 Job 的运行状态信息给 Client 端。
不难看到MapReduce过程中竟然要把数据写到磁盘中再读出来,这样或许能在一定程度上减轻内存压力,但毫无疑问的对整个计算的效率与硬盘都是一个很大的损害
MapReduce工作流程
Input
存储在HDFS中的文件被切分成一定大小的块,在Input阶段通过InputFormat读入
Split
在Input读取完数据后会对数据进行切片,切片的数量根据Block的大小决定,一个split会分配一个maptask进行处理
Map

在这一阶段,输入的切片会被处理,其中每一行都变成key-value对,key是该行的字节偏移量,value是该行的内容。每一行得到的key-value对都会作为输入等待后续处理。map函数接受key-value对作为输入进行计算,计算的结果同样是key-value对,并将其输出
map计算完成之后便要把输出的数据给ReduceWorker进行reduce操作。但是应该哪些输出给哪些worker、怎样把输出传递给ReduceWorker,这些问题由Shuffle负责解决
Shuffle
Shuffle分为Map Shuffle和Reduce Shuffle,二者都属于Shuffle过程的一部分,只是面向的对象不同。Shuffle虽然不需要用户专门编程实现,但是也在MapReduce过程中发挥巨大的作用

下面1-3属于Map Shuffle过程,4-5属于Reduce Shuffle:
- 在map过程中,每个map函数会输出一组key-value对,这些数据会先被写入缓冲环形内存中(默认大小100M,可通过配置修改),在写入时会进行分区,为每个key-value对添加一个partition属性值
- 当缓冲区的内容达到80%之后会开始溢出,将数据写入本地磁盘形成多个spill file,在将数据写入磁盘之前会根据分区号和key的数据进行排序与合并
- 把所有溢出的spill file一次合并成一个文件,确保一个MapTask只产生一个中间数据文件(Combine)
- ReduceTask到已经完成MapTask的节点上复制数据,这些数据默认会保存在内存的缓冲区中,当内存的缓冲区达到一定的阈值的时候,就会将数据写到磁盘之上
- 在复制数据的同时,ReduceTask也会对内存和本地磁盘中的数据文件进行合并操作
- 在对数据合并的时候也会进行排序
Reduce

输入ReduceTask的数据是key-values形式的键值对,也就是说同一个key有很多value,ReduceTask接受这样的输入并在reduce函数处理后以key-value对的形式输出
Finalize
把ReduceTask生成的key-value对使用OutputFormat的write方法,将结果写到文件中,计算完成
MapReduce分区

分区(partitioner):我们可以通过指定分区,将同一个分区的数据发送到同一个ReduceTask中处理。在map输出之后,写入缓存之前,会调用partition函数,计算出数据所属的分区,并且把这个元数据存储起来。当数据要在缓存中溢出时),读取缓存中的数据和分区元数据,然后把属与同一分区的数据合并到一起
默认是通过map输出结果的key值取hashcode对代码中配置的ReduceTask数量取模运算,哈希值一样的分到一个区,也就是一个reduce任务对应一个分区的数据。这样做的好处就是尽可能地负载均衡。
MapReduce如何在分布环境中处理词频统计、倒排索引


实验部分
Hadoop本地、伪分布与全分布部署模式
本地模式
这种模式在一台单机上运行,没有分布式文件系统,而是直接读写本地操作系统的文件系统。在单机模式(standalone)中不会存在守护进程,所有东西都运行在一个JVM上。这里同样没有DFS,使用的是本地文件系统。单机模式适用于开发过程中测试和调试MapReduce程序,这也是最少使用的一个模式。
伪分布模式
也是在一台单机上运行,但用不同的Java进程模仿分布式运行中的各类结点(NameNode,DataNode,JobTracker,TaskTracker,SecondaryNameNode),伪分布式(Pseudo)适用于开发和测试环境。在这个模式中,所有守护进程都在同一台机器上运行,模拟集群环境,并且是相互独立的Java进程。在这种模式下,Hadoop使用的是分布式文件系统,各个作业也是由JobTracker服务,来管理的独立进程。在单机模式之上增加了代码调试功能,允许检查内存使用情况,HDFS输入输出,以及其他的守护进程交互。类似于完全分布式模式,因此,这种模式常用来开发测试Hadoop程序的执行是否正确。
全分布模式
全分布模式通常被用于生产环境,使用N台主机组成一个Hadoop集群,Hadoop守护进程运行在每台主机之上。这里会存在NameNode运行的主机,DataNode运行的主机,以及TaskTracker运行的主机。在分布式环境下,主节点和从节点会分开,不同节点担任不同的角色。在实际工作应用开发中,通常使用该模式构建企业级Hadoop系统。
HDFS上传文件(原理与分析命令)

命令:
- 创建一个文件夹
hdfs dfs -mkdir /myTask - 创建多个文件夹
hdfs dfs -mkdir -p /myTask1/input1 - 上传文件
hdfs dfs -put /opt/wordcount.txt /myTask/input - 查看总目录下的文件和文件夹
hdfs dfs -ls / - 查看myTask下的文件和文件夹
hdfs dfs -ls /myTask - 查看myTask下的wordcount.txt的内容
hdfs dfs -cat /myTask/wordcount.txt - 删除总目录下的myTask2文件夹以及里面的文件和文件夹
hdfs dfs -rm -r /myTask2 - 删除myTask下的wordcount.txt
hdfs dfs -rm /myTask/wordcount.txt - 下载hdfs中myTask/input/wordcount.txt到本地opt文件夹中
hdfs dfs -get /myTask/input/wordcount.txt /opt
配置文件及具体的使用方法
所有的配置文件都储存在/etc/hadoop/目录下
- hadoop-env.sh:包括一些hadoop的环境的配置
- core-site.xml:核心模块配置
- hdfs-site.xml:HDFS文件系统模块配置
- mapred-site.xml:MapReduce模块配置
- yarn-site.xml:yarn模块配置
- workers:集群配置
MapReduce的主要接口
Mapper
Mapper类提供了以下几种方法:

Reducer
Reducer类提供以下几种方法:

MapReduce实现倒排索引(原理及代码分析)
倒排索引就是每个单词出现在哪些文档里,这样就能快速检索。最终外部输入每行文档的ID及内容,我们可以把它拆解成单词出现在哪个文档里。Reduce过程输入是每个关键词key,输出是key出现在哪些文档里就放到一起。
首先输入很多的文档,这里面每一行的不是文档编号了,我们要存它的文档编号。拆解的时候我们加入新的概念,Worker,这里有三个Worker,每个Worker负责1行,当然有很多数据时每个Worker可以负责多行,每个Worker就需要进行Map拆解,把每个单词都拆成单词和出现的文档ID。接着Shuffle有两个新Worker,他们把单词一拆,一部分交个Worker4,一部分交给Worker5,让他们去前面拿数据,拿到以后会排个序,这也是最基本的Shuffle过程。接着就是Reduce,把相同的东西合并到一起去,比如food出现在两个文档里,就是0和2。最终就是把这些结果放到一起去就可以让我们查找了。
InvertedIndex.java:
import java.util.*;
import java.io.IOException;
import java.util.HashMap;
import java.util.Map;
import java.util.Set;

import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.FileSystem;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.Mapper;
import org.apache.hadoop.mapreduce.Reducer;
import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;
import org.apache.hadoop.mapreduce.lib.input.FileSplit;
import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;
import org.apache.hadoop.util.GenericOptionsParser;

import org.apache.hadoop.hbase.HBaseConfiguration;
import org.apache.hadoop.hbase.client.Put;
import org.apache.hadoop.hbase.io.ImmutableBytesWritable;
import org.apache.hadoop.hbase.mapreduce.TableMapReduceUtil;
import org.apache.hadoop.hbase.mapreduce.TableReducer;
import org.apache.hadoop.hbase.util.Bytes;

public class InvertedIndex {
    //偏移量\文本\单词\文件编号
    static class MyMapper extends Mapper<LongWritable, Text, Text, Text> {
        String fileName = null;
        Text mk = new Text();  //map端输出的键
        Text mv = new Text();  //map端输出的值

        // 在setup中通过切片来获取文件名
        @Override
        protected void setup(Mapper<LongWritable, Text, Text, Text>.Context context)
                throws IOException, InterruptedException {
            FileSplit files = (FileSplit) context.getInputSplit();
            fileName = files.getPath().getName();
        }

        @Override
        //偏移量,字符串,暂存处理结果
        protected void map(LongWritable key, Text value, Mapper<LongWritable, Text, Text, Text>.Context context)
                throws IOException, InterruptedException {

            String[] datas = value.toString().split(" ");
            String line = datas[0];
            int line_num = Integer.parseInt(line);
            //文件编号
            int file_num = line_num / 100000 + 1;
            //map存储单词和出现次数
            Map<String, Integer> map = new HashMap<String, Integer>();
            //更新单词出现次数
            for (int i = 1; i < datas.length; i++) {
                String word = datas[i];
                if (map.containsKey(word))
                    map.put(word, map.get(word) + 1);
                else
                    map.put(word, 1);
            }
            //获取所有单词
            Set<String> keySet = map.keySet();
            for (String s : keySet) {
                mk.set(s);
                // 拼接信息,这里本来写入了文件名、行号和出现次数
                //但考虑到hbase写入内容的大小上限,仅写入单词出现的文件编号
            //    mv.set(fileName + ":" + line + "," + map.get(s));
                mv.set(Integer.toString(file_num));
                context.write(mk, mv);
            }

        }

    }


    static class MyReducer extends TableReducer<Text, Text, ImmutableBytesWritable> {
        Text rv = new Text();

        @Override
        protected void reduce(Text key, Iterable<Text> values, Context context)
                throws IOException, InterruptedException {
            // 用StringBuilde来进行拼接
            StringBuilder s = new StringBuilder();
            //存储该单次出现的所有文件的编号
            List<String> mylist = new ArrayList<>();
            for (Text v : values) {
                String str1 = v.toString();
                if (!mylist.contains(str1)) {
                    mylist.add(str1);
                }
            }
            for (String i : mylist) {
                s.append(i).append(",");
            }
            // 去掉最后一个符号
            rv.set(s.substring(0, s.length() - 1));
            //设置单次为Row Key 构建Put对象
            Put put = new Put(key.toString().getBytes());
            //指定插入的列族、列名和值
            put.addColumn("col_family".getBytes(), "info".getBytes(), rv.toString().getBytes());
            context.write(null, put);
        }
    }

    public static void main(String[] args) throws IOException, ClassNotFoundException, InterruptedException {
        Configuration conf = new Configuration();
        conf = HBaseConfiguration.create(conf);
        String[] otherArgs = new GenericOptionsParser(conf, args).getRemainingArgs();
        Job job = Job.getInstance(conf);
        job.setJarByClass(InvertedIndex.class);
        job.setMapperClass(MyMapper.class);
        job.setReducerClass(MyReducer.class);
        job.setMapOutputKeyClass(Text.class);
        job.setMapOutputValueClass(Text.class);
        job.setOutputKeyClass(Text.class);
        job.setOutputValueClass(Text.class);
        // 设置HBase表输出:表名,reducer类
        TableMapReduceUtil.initTableReducerJob("test_table", MyReducer.class, job);
        FileInputFormat.addInputPath(job, new Path(otherArgs[0]));
        job.waitForCompletion(true);
    }

}
map阶段
假设输入为"0 Jay eats food",map函数会将该句的所有单词按照空格分离,那么第一个“单词”显然就是该行文档标题的编号,所以从第二个单词开始,分别以这些单词为key,以编号为value作为输出
reduce阶段
reduce阶段将相同key的键值对合并,合并的具体方式是key不变,value的值以分号为分隔符放到一起,并最终将其写入HBase中
结果
最终得到一个Rowkey为单词,列为该单词出现在了哪些编号的文档中的HBase表
MapReduce如何实现移动计算?
一句话:==数据不动,把任务分到数据所在的节点,在该节点上进行计算==
MapReduce设计的一个理念就是“计算向数据靠拢”,而不是“数据向计算靠拢”, 因为移动数据需要大量的网络传输开销, 尤其是在大规模数据环境下,这种开销尤为惊人,所以,移动计算要比移动数据更加经济。
所谓计算向数据移动就是我们尽可能的将MapTask分配给含有该map处理的数据块的TaskTracker上,同时将程序JAR包复制到该TaskTracker上来运行,这叫“运算移动,数据不移动”。
HBase写入记录的过程(原理与分析代码)
//设置word为RowKey构建Put对象
Put put = new Put(key.toString().getBytes());
//指定插入到哪个列族,插入的列名和值
put.addColumn("col_family".getBytes,"info".getBytes(),tv.toString().getBytes())
单行添加数据:
//单行添加数据
Put row = new Put(byte[] rowkey);
row.addColumn(byte[] columnfamily,byte[] column,byte[] value);

//多行
List<Put> rows = new ArrayList();
rows.add(row);
常用命令行命令:
-
查看当前数据库中有哪些表:
list -
创建表:
create "employee","info"(表名称,列族名字) -
给表插入数据:
put "employee","1001","info:sex","male"(表名 ,rowkey名,列簇名:字段名,字段值) -
扫描查看表数据:
scan '表名' -
查看“指定行”或“指定列族:列”的数据:
get 'employee','1001' #表名 + rowkeyget 'employee','1001','info:name' #表名 + rowkey + 列簇:字段名 -
统计表数据行数:
count 表名 -
删除某 rowkey 的全部数据:
deleteall "employee","1001" -
删除某 rowkey 的某一列数据:
delete "employee","1002","info:sex" -
清空表数据:
truncate '表名'
Hadoop进行开发搜索引擎的优势
随着互联网用户量的激增,使得网络中数据量飞速累积且数据格式也随之增多,搜索引擎成为了处于大数据背景下的网络用户获取所需信息的主要手段之一。数据量的增加同时使得搜索引擎需要处理的数据流同步增加,而分布式计算技术能够更好的应对海量数据的存储和高并发计算,而Hadoop拥有一系列优点。
- 高可靠性。Hadoop按位存储和处理数据的能力值得人们信赖。
- 高扩展性。Hadoop是在可用的计算机集簇间分配数据并完成计算任务的,这些集簇可以方便地扩展到数以千计的节点中。
- 高效性。Hadoop能够在节点之间动态地移动数据,并保证各个节点的动态平衡,因此处理速度非常快。
- 高容错性。Hadoop能够自动保存数据的多个副本,并且能够自动将失败的任务重新分配。
- 低成本。与一体机、商用数据仓库以及QlikView、Yonghong Z-Suite等数据集市相比,Hadoop是开源的,项目的软件成本因此会大大降低。