 SUN
一 Roofline 性能分析模型
1.1 Roofline 模型原理
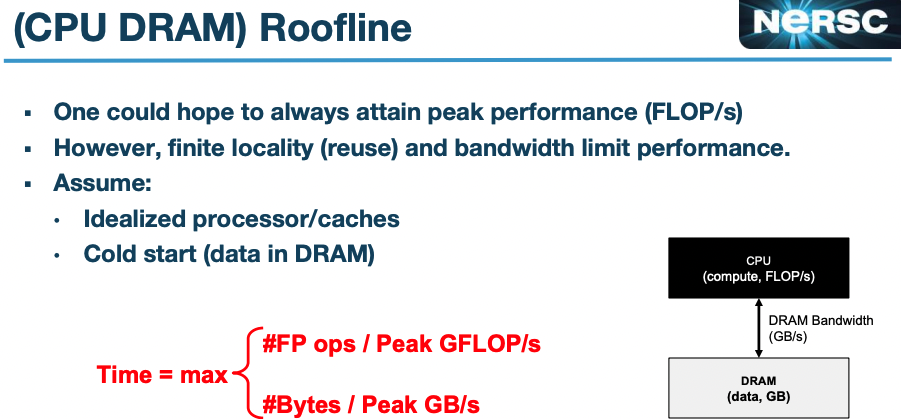
为了做性能分析,Roofline 模型论文引入了“操作强度”(operational intensity)这个概念,表示每字节 DRAM/HBM 数据传输(traffic)所对应的操作次数(每字节 flops),这里的字节数是指那些经过缓存层过滤后进入主内存 DRAM/HBM 的字节,即我们关注的是缓存与内存之间的数据传输,而不是处理器与缓存之间的数据传输(traffic)。因此,操作强度反映了在特定计算机上某个计算核所需的 DRAM 带宽。公式定义如下:
Roofline 模型可视化曲线如下图所示:
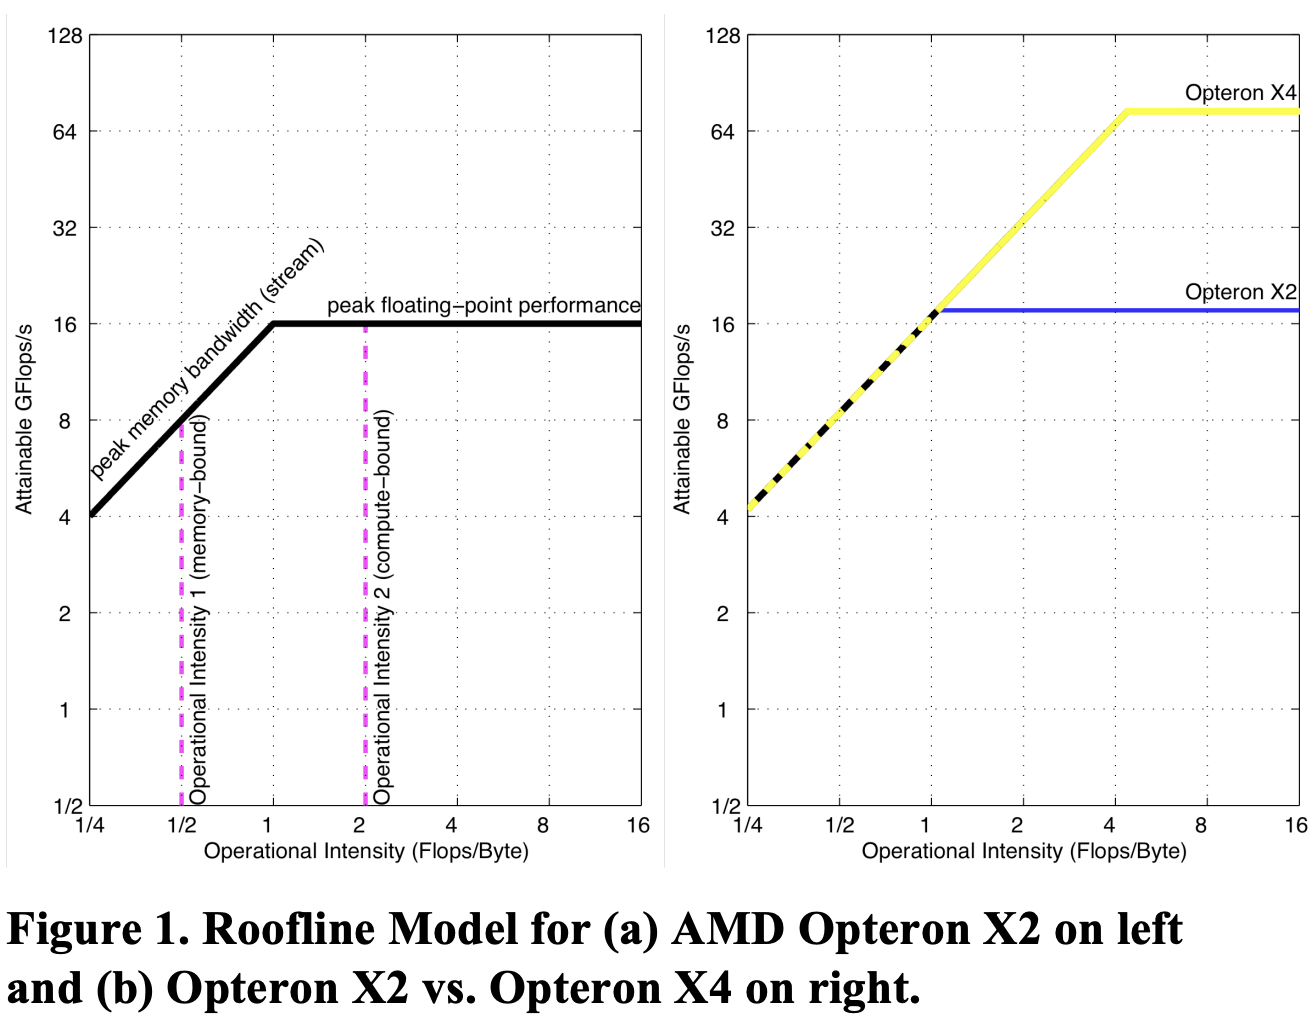
Roofline 模型曲线图的 X 轴表示 Flops/byte(GFlops per byte)即操作强度,Y 轴表示 GFlops/s(GFlops per second)。
- 通过绘制一条水平线表示计算机的峰值浮点性能,任何浮点运算的实际性能都不会超越这条线,因为它代表硬件限制。
- 通过绘制一条斜线,表示该计算机内存系统在不同操作强度下支持的最大浮点操作性能。公式如下:
- 斜线和直线的交点对应的是处理器同时达到峰值浮点操作性能和峰值内存带宽的条件,这发生在特定的操作强度下。
水平和斜线的组合为该模型命名为“Roofline model”。Roofline 模型为每个内核算法设定了性能上限,具体取决于内核的操作强度。形象理解的话,我们可以将操作强度视为触及屋顶的一个柱子。
- 如果触及平坦的屋顶部分,表明性能受计算限制;
- 如果触及斜屋顶部分,表明性能受内存限制。
在图 1a 中,操作强度为 2 的内核受芯片计算限制,而操作强度为 1 的内核受芯片内存限制。可以在不同内核上重复使用 Roofline model,而芯片的 Roofline 模型曲线不会变化。
1.2 Roofline 模型数学表达
如果需要用数学公式表示 Naive Roofline 模型,可以表示为如下:
CPU/NPU/GPU 芯片相关参数:
: 可用的峰值浮点性能 [操作数/秒] : 可用的峰值内存带宽 [字节/秒]
内核/算子相关参数:
: 计算强度 [操作数/字节]
1.3 Roofline 模型作用
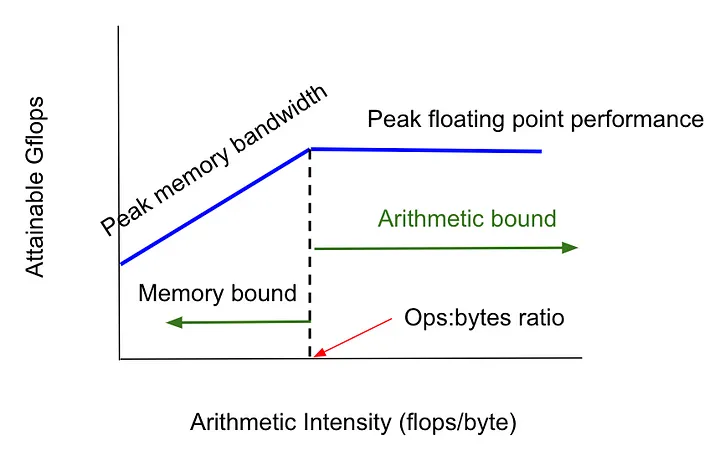
Roofline 性能分析模型通过将算法 kernel 的实际操作强度和芯片硬件的理论最大操作强度对比,以揭示 kernel 是受到计算性能的限制还是受到内存带宽的限制。性能瓶颈分析过程:
- 内存受限:当算子/模型的算术强度 < (CPU/GPU)芯片的
OI,性能受内存带宽限制,需要想办法减少算子的内存交换次数MAC。 - 计算受限:当算子/模型的算术强度 > (CPU/GPU)芯片的
OI,受限于处理器的计算性能,需要想办法减少算子的浮点运算次数FLOPs
总结:Roofline 可以帮助识别程序/内核的性能瓶颈,并指导优化(减少内存访问次数还是算法计算量 FLOPs),以及是否达到了硬件的能力上限。
下表是 v100、a100、h100 卡的常用性能指标和 FP16 Tensor 算力的操作强度 oi:
| GPU | 显存 | CUDA 核心数 | FP16 Tensor Core 浮点运算能力 | FP32 浮点运算能力 | 最大内存带宽 | Tensor 运算强度(OI) |
|---|---|---|---|---|---|---|
| V100-SXM | 16 GB | 5120 | 125 TFLOPS | 15.7 TFLOPS | 900 GB/s | 138 TOPS (FP16) |
| A100-SXM | 40 GB / 80 GB | 6912 | 312 TFLOPS | 19.5 TFLOPS | 2039 GB/s | 153 TOPS (FP16) |
| H100-SXM | 80 GB | 8192 | 989 TFLOPS(不开启稀疏计算) | 60 TFLOPS | 3350 GB/s | 295 TOPS (FP16) |
在 A100 GPU 中,ops:byte ratio 是 208,这意味着:
- 每访问 1 字节内存时,GPU 可以完成 208 次浮点运算。
- 如果我们计算的 OI(FLOPs/byte)低于 208,程序性能会受到内存带宽的限制。
二 Roofline 性能分析示例
2.1 计算 kernel 的 Roofline 性能分析
矩阵乘法: FP16。矩阵乘法 GEMM 的最小内存访问代价
在 A100_SXM 卡上运行,如果
在 V100_PCIE 卡上运行,假设在 FP16 输入上进行 Tensor Core 操作,并使用 FP32 累积,下表显示了一些常见网络层的算术强度。
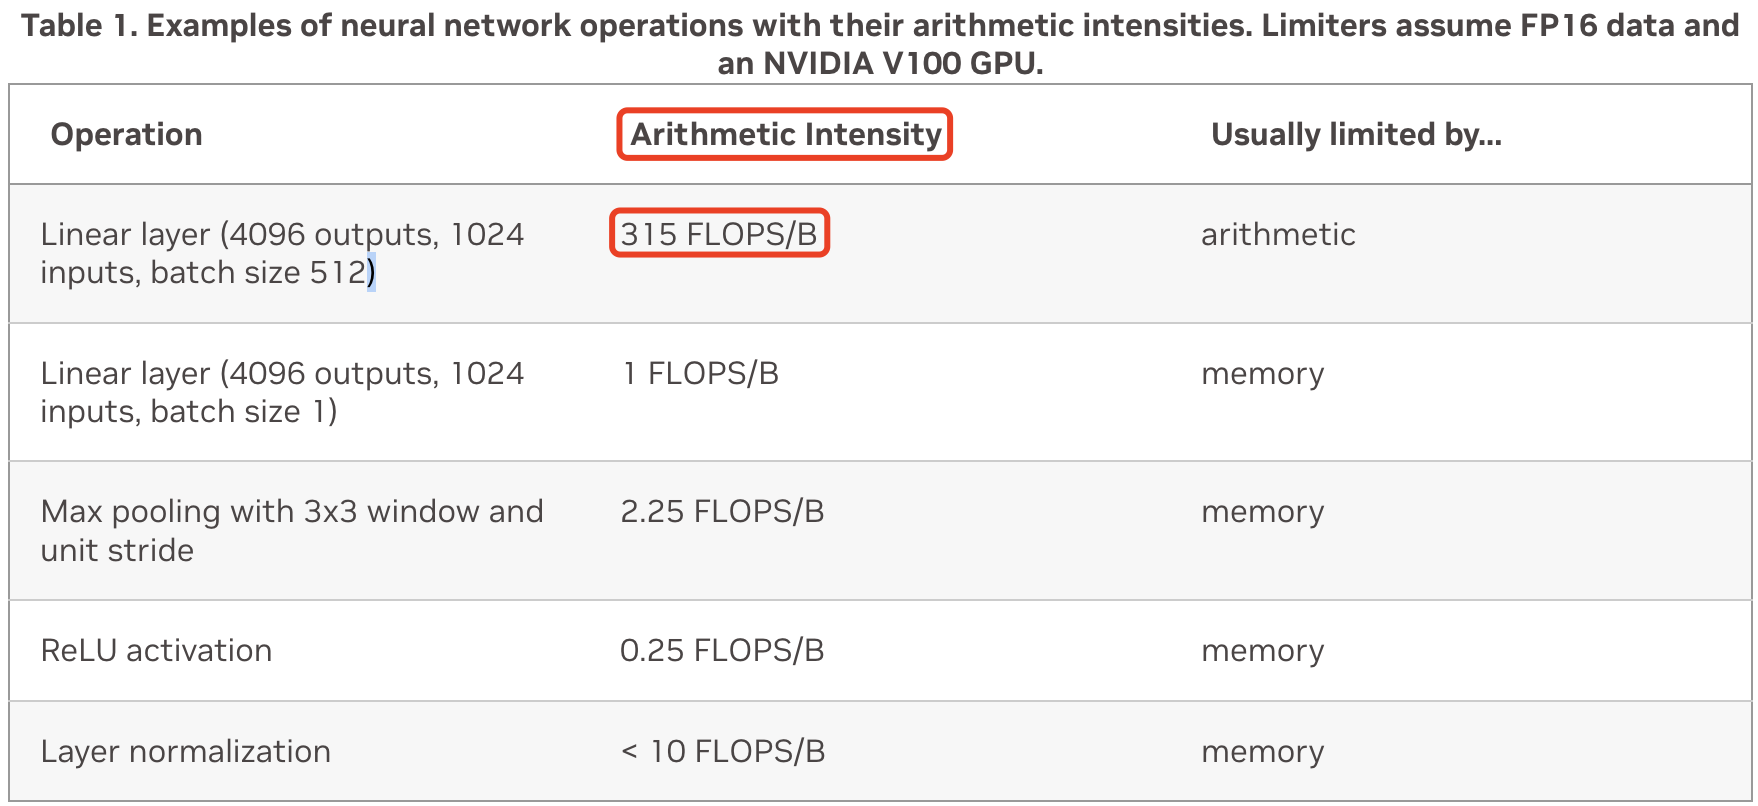
上述表格第一行的计算过程如下:
即该线性层(矩阵乘法)的算术强度为
值得注意的是,算术强度分析的前提是工作负载足够大,可以完全占用处理器的数学运算和内存流水线。然而,当工作负载较小或缺乏足够的并行性时,处理器会因资源未充分利用而受限于延迟。举例来说,如果仅启动一个线程来访问 16 字节的数据并执行 16000 次数学运算,尽管算术强度达到 1000 FLOPS/B,理论上在 V100 GPU 上应该是计算受限的,但单线程会导致 GPU 资源大部分处于闲置状态,极大浪费其数学流水线和执行能力。此外,算术强度的计算默认输入和输出从内存中各读取一次,而在实际实现中,重复读取输入数据的情况很常见,这会进一步降低实际的算术强度。因此,算术强度只是一个粗略的估算,如需更精确的分析,应结合性能分析工具的数据。
2.2 LLM 推理的 Roofline 性能分析
对于 A100 卡,其 GPU 的内存带宽为 2039 GB/s,GPU 的理论 FP16 计算能力为 312 TFLOPs(Tensor 运算强度
实际 llm 推理的内存占用和传输数据量的分析是非常复杂且要考虑不同应用场景、不同推理框架、不同优化模式等等,因此为了简化分析过程,这里考虑的是理想情况下的分析,且是非超长上下文场景聊天情形:conext_lenght < 1024,提示词的长度较小时其值 << hidden_size,这个时候 llm 的参数、计算量分析都可以更为简单,且有类似结论:“在一次前向传播中,对于每个 token 和 每个模型参数,需要进行 2 次浮点数运算”,分析过程见这篇文章。
考虑理想场景且 batch_size = 1,很明显,随着输入提示词长度的增加,llm 的操作强度成线性增加!
- prefill 阶段:当 seq_len > 200 时,llm 操作强度达到了
,很明显 llm 在 prefill阶段基本都是是计算受限的。 - decode 阶段:
seq_len 固定且 = 1,llm 推理时的操作强度也固定为,很明显 llm 在 decode阶段基本都是是内存受限的。
总结:llm 推理时,prefill 和 decode 阶段是处于不同瓶颈的,那么其执行过程是否可以完全分开呢?包括但不限于计算/数据存储在不同的节点机器上。
三 AI 应用性能优化策略
总结:
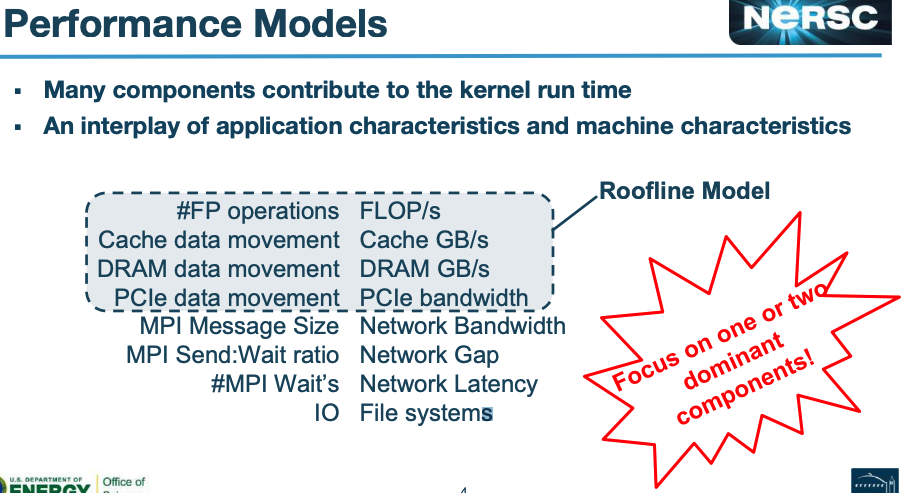
- AI 应用的推理时间取决于多个因素,我们应该关注主要因素,比如:内存读写和数学计算时间,而不是次要因素:网络带宽和磁盘读写时间。
Roofline Model有两个区域:内存带宽受限和算力受限区域,分别对应两种不同的优化策略:硬件不变的前提下,优化模型结构/内核算法,目的是减少内存访问代价MAC或者浮点运算次数FLOPs。- AI 模型推理的实际时间取决于内存读取时间和 CPU/GPU 数学(乘加)计算时间,取决于哪个时间更长。一般来讲,当处于内存受限时,内存读取时间长;当处于算力受限时,数学计算时间长。
以 A100 GPU 为例,该硬件的 ops:byte ratio 是 kv 值的计算强度是 1,那么计算 208 个 tokens 的 kv 值的计算强度则是 208(kv 计算量和 seq_len 线性相关)。
这也意味着如果我们计算一个 token 的 kv 值,与计算多达 208 个 token 的时间几乎是相同的!因为低于这个数,会受到内存带宽的限制,且内存加载时间 > 数学计算时间;高于这个数,我们会受到算力 FLOPS 的限制。
这也可以延伸出,当 llm 推理时的操作强度低于硬件的 ops:byte ratio(如 208),则内存加载时间主导性能。
前面的假设中,为什么计算 1 个 token 和 208 个 token 的时间几乎相同?
- 当只计算 1 个 token 时,操作强度非常低,程序性能主要受限于内存读取时间,而数学计算时间占比很小,即程序性能是由内存带宽指导。
- 计算 1 个 token 时,GPU 需要加载相关的权重数据到缓存中。计算 208 个 token 时,GPU 也是使用同样的权重数据。
- 因为权重加载的时间是固定的,计算更多 token 并不会显著增加内存传输时间。
参考资料
- Roofline: An Insightful Visual Performance Model for Floating-Point Programs and Multicore Architectures*
- LLM Inference Unveiled: Survey and Roofline Model Insights
- Understanding the Roofline Model
- 《Performance Tuning of Scientific Codes with the Roofline Model》
- https://hackernoon.com/understanding-the-roofline-model