 SUN
摘要
Softmax 函数在机器学习中应用广泛,此前的多项研究提出了更快的替代方案。本文针对提升原始 Softmax 性能,提出了一种一次遍历输入数据来计算 Softmax 函数归一化项的方法,作用是减少内存访问次数,并称其为“在线 Softmax”,并推测这种减少内存访问的方法可以提升 Softmax 在实际硬件上的性能。基准测试也证实了这一推测:Softmax 的速度最多提升 1.3 倍,且 Softmax 和 TopK 结合并融合后的速度提升最多可达 5 倍。
1. 原来的 Softmax
Softmax 函数是一种常用于机器学习,特别是多分类问题中的激活函数。它的作用是将一个任意实数向量转换为一个概率分布,并确保输出的概率和为 1。
给定输入向量
其中,
Softmax 函数中,分母的求和项被叫做归一化项
,作用是将输入向量中每个元素 变为比例较小的数值,保证它们的和为 1,从而符合概率的定义。
$\text{算法 1 朴素 softmax} \ \begin{aligned} 1: & \quad d_0 \leftarrow 0 \ 2: & \quad \textbf{for} \ j \leftarrow 1, V \ \textbf{do} \ 3: & \quad \quad d_j \leftarrow d_{j-1} + e^{x_j} \ 4: & \quad \textbf{end for} \ 5: & \quad \textbf{for} \ i \leftarrow 1, V \ \textbf{do} \ 6: & \quad \quad y_i \leftarrow \frac{e^{x_i}}{d_V} \ 7: & \quad \textbf{end for} \end{aligned}$
在实际硬件上,由于表示对数字范围有限,算法 1 的第 3 行可能会因指数运算而发生溢出或下溢,因此目前通用的 Softmax 实现(更安全的形式)中为了防止数值溢出还需要再额外减掉一个 max 最大值:
大部分深度学习框架都是采用这个更安全的朴素实现,算法流程见 [算法2]。但安全 Softmax 对输入向量进行了三次遍历:第一次计算最大值 4 次内存访问,即原始的 Softmax 算法的内存访问(MAC)偏大,本文希望对此进行改进。
$\text{算法 2 安全 Softmax} \ \begin{aligned} 1: & \quad m_0 \leftarrow -\infty \ 2: & \quad \textbf{for} \ k \leftarrow 1, V \ \textbf{do} \ 3: & \quad \quad m_k \leftarrow \max(m_{k-1}, x_k) \ 4: & \quad \textbf{end for} \ 5: & \quad d_0 \leftarrow 0 \ 6: & \quad \textbf{for} \ j \leftarrow 1, V \ \textbf{do} \ 7: & \quad \quad d_j \leftarrow d_{j-1} + e^{x_j - m_V} \ 8: & \quad \textbf{end for} \ 9: & \quad \textbf{for} \ i \leftarrow 1, V \ \textbf{do} \ 10: & \quad \quad y_i \leftarrow \frac{e^{x_i - m_V}}{d_V} \ 11: & \quad \textbf{end for} \end{aligned}$
2. 在线归一化计算
算法 3 通过一次遍历输入向量,同时计算最大值 Softmax 函数计算的内存访问次数从每个向量元素的 4 次减少到 3 次。灵感来源于数值稳定的方差在线计算算法 [18]。算法对应的计算公式如下所示:
这里
$\text{算法 3 带在线归一化计算的安全 Softmax} \ \begin{aligned} 1: & \quad m_0 \leftarrow -\infty \ 2: & \quad d_0 \leftarrow 0 \ 3: & \quad \textbf{for} \ j \leftarrow 1, V \ \textbf{do} \ 4: & \quad \quad m_j \leftarrow \max(m_{j-1}, x_j) \ 5: & \quad \quad d_j \leftarrow d_{j-1} \times e^{m_{j-1} - m_j} + e^{x_j - m_j} \ 6: & \quad \textbf{end for} \ 7: & \quad \textbf{for} \ i \leftarrow 1, V \ \textbf{do} \ 8: & \quad \quad y_i \leftarrow \frac{e^{x_i - m_V}}{d_V} \ 9: & \quad \textbf{end for} \end{aligned}$
算法 3 的 pytorch + python 实现如下所示:
def online_softmax(x: torch.Tensor) -> torch.tensor:
    """Iterative calculation and 2.5x faster than native softmax """
    row_cont, col_count = x.shape
    assert x.ndim == 2, f"only accepts 2D tensor now"
    output = torch.zeros_like(x)

    for r in range(row_cont):
        row_max = x[r][0]
        normalizer = 0
        for c in range(1, col_count):
            pre_max = row_max
            cur = x[r][c]
            row_max = max(pre_max, cur)
            # if cur > pre_max:
            #     print(f"Update row max now is {row_max}, row = {r}")
            normalizer = normalizer * torch.exp(pre_max - row_max) + torch.exp(cur - row_max)
        output[r, :] = torch.exp(x[r, :] - row_max) / normalizer

    return output
算法 3 本质上就是在遍历输入数组元素的过程中,持续更新最大值
定理 1:算法 3 的第 1-6 行计算
定理 1 可通过数学归纳法进行证明:
-
基础情况:当
$m_1 \leftarrow x_1 \ \quad;; = max_{k=1}^1x_k\qquad\qquad\qquad\qquad; \text{根据算法 3 第 4 行}$ $d_1 \leftarrow e^{x_1 - m_1} \ \quad;; = \sum_{j=1}^1 e^{x_j - m_1} \qquad\qquad\quad\qquad;; \text{根据算法 3 第 5 行}$ 上述公式仅 对于
,定理成立。 -
归纳步骤:假设定理在
时成立,即算法的第 1-6 行可以计算得到 且 。现在,我们来看看当 时,算法计算的结果。 $m_S \leftarrow \max(m_{S-1}, x_S) \qquad\qquad\qquad; \text{根据算法 3 第 4 行} \ \quad;; = \max\left(\max_{k=1}^{S-1} x_k, x_S\right) \qquad\qquad \text{根据归纳假设} \ \quad;; = \max_{k=1}^{S} x_k$
$d_S \leftarrow d_{S-1} \times e^{m_{S-1} - m_S} + e^{x_S - m_S} \qquad; \text{根据算法 3 第 5 行} \ \quad;; = \left(\sum_{j=1}^{S-1} e^{x_j - m_{S-1}}\right) \times e^{m_{S-1} - m_S} + e^{x_S - m_S} \quad \text{根据归纳假设} \ \quad;; = \sum_{j=1}^{S-1} e^{x_j - m_S} + e^{x_S - m_S} \ \quad;; = \sum_{j=1}^{S} e^{x_j - m_S}$
归纳步骤同样成立(
的推导第三行成立是因为 是常数)。
算法 3 被证明可以计算公式 (2) 中定义的 Softmax 函数,并且是安全的:
是运行中的最大值: ,对于所有 不会发生下溢或上溢。 同样有界: ,对于所有 。这一点可以通过归纳法轻松证明。对于 ,32 位浮点数存储保证可以处理最多 个向量元素而不会发生上溢。这是一个合理大的数,但如果你的向量更大,则需要使用 64 位浮点数存储 。
算法 2 提供了相同的保证:
算法 3 意义:上述公式证明了
2.1 并行在线归一化计算
算法 3 的 1-6 行定义了一种通过一次遍历输入向量来顺序计算归一化项的方法,这样的实现虽然减少了内存访问次数,但因为是使用 for 循环串行执行,所以还是不够快。如果能通过并行分块计算归一化项就更好了,但因为
算法 3 第 5 行(
| index | 0 | 1 | 2 | 3 | j |
|---|---|---|---|---|---|
| 1 |
上述
定义分块计算:
同样可以得到相同的
论文没有给出证明,在线 softmax 计算支持分块计算的数学证明来源于FlashAttentions,我做了些细节修改。
3. Softmax 和 top-k 融合
在线 Softmax[算法 3] 对每个向量元素执行三次内存访问:一次用于归一化计算的读取,一次用于 Softmax 函数值
TopK 函数生成一个包含输入向量最大值索引的
其中,
TopK 至少需要读取输入向量的每个元素一次。如果分别运行安全的 Softmax 和 TopK 则每个输入元素需要进行 5 次内存访问,如果使用在线 Softmax 而非安全 Softmax(但仍然分别依次运行),则需要 4 次内存访问。如果我们继续改进算法 3,不仅在遍历输入向量时保持最大值
4. Benchmarking
理论分析:softmax 函数明显是“内存受限”(每字节 flops 很低)操作,这意味着内存带宽可能限制了性能,即使在线 Softmax 在每个元素上有额外的少量浮点运算,减少内存访问次数应该也能提升性能,本文的实验也直接证实了这一点。
实验硬件:Tesla V100 PCIe 16 GB,CUDA Toolkit 9.1,ECC和持续模式都打开。基准测试的源码可在 github.com/NVIDIA/online-softmax 上获得。
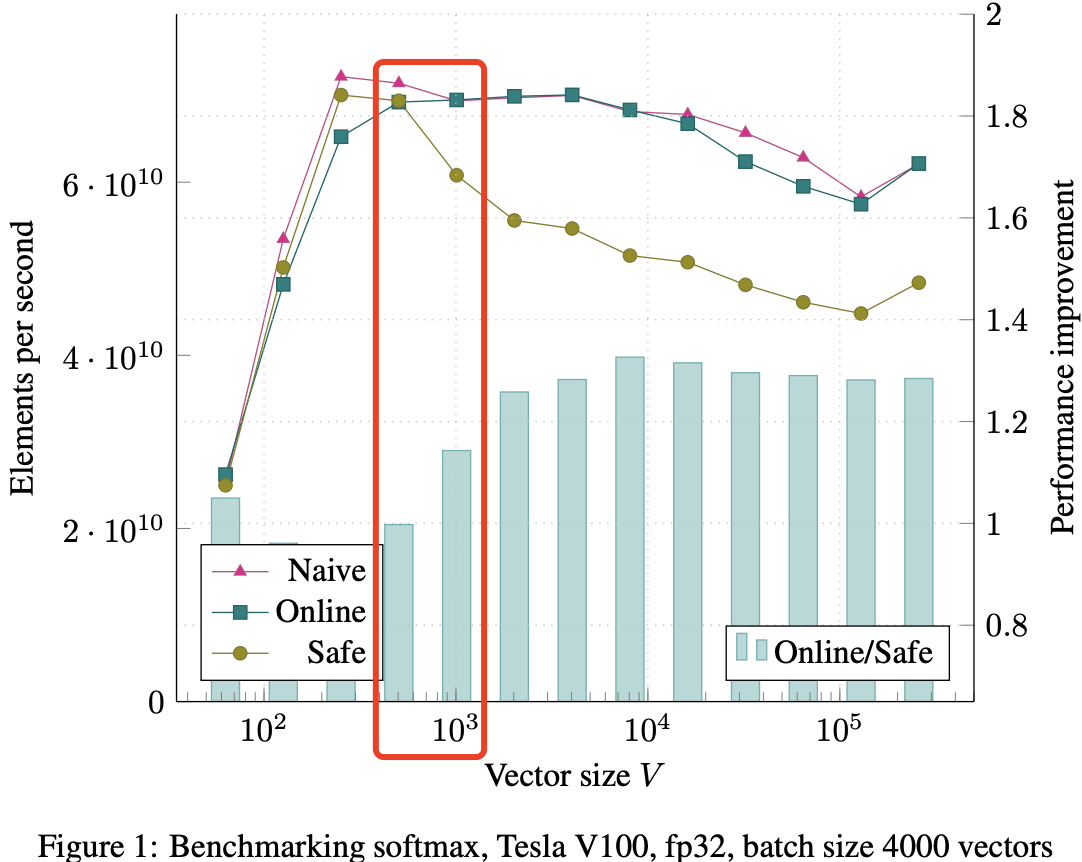
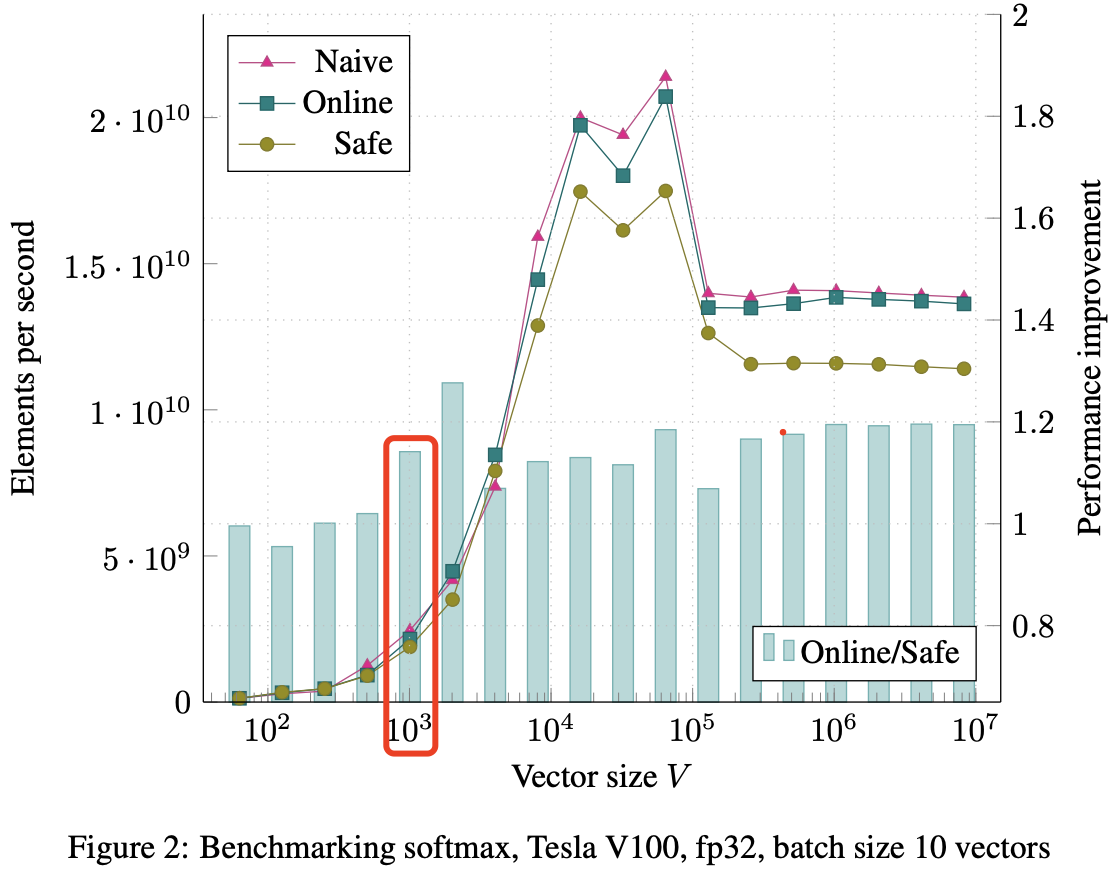
输入数据配置:批次大小分别为 4,000 和 10,大批量 gpu 算力充分发挥,小批量 gpu 算力无法充分发挥。向量大小范围
对于大批次情况(见图 1),所有三种算法在向量大小 V = 1000 之前表现相似。NVIDIA Visual Profiler 显示在此时,L1 和 L2 缓存抖动开始导致所有三种算法都受到 DRAM 带宽的限制。当这种情况发生时,在线和朴素算法的速度比 Safe 算法更快,在 V = 4000 时达到了约 1.3 倍的提升(参见图中的条形图,显示了在线 Softmax 相较于 Safe Softmax 的性能提升)。这与内存访问次数减少 1.33 倍相当接近。
在向量大小小于 1000 时,GPU 的 SRAM 能放下输入数据,因为 SRAM 速度极快,所以此时算法不受内存带宽限制,三种 softmax 速度差不多;但当向量大小小大于 1000 时,SRAM 空间不够,数据存取与 HBM,此时所有三种算法都受到 DRAM 带宽的限制。
在小批次情况下,所有算法的绝对性能都较低,见图 2(图 2 的柱子普遍低于 图 1)。基准测试为每个向量运行一个线程块;因此在小批次情况下(10 个向量)网格中仅有 10 个线程块。这不足以充分利用 GPU,导致计算和内存子系统未被完全使用,各种延迟暴露出来。同样在批量推理的情况下,所有三种算法在 V = 1000 之前表现相似。之后朴素和在线算法的表现优于 Safe 算法,约为 1.15 倍。
5. 结论和讨论
结论:本篇论文在算法上其实有两个创新:
- 提出并证明了通过一次遍历输入数据来计算 Softmax 函数归一化项的方法,该方法将 Softmax 函数的内存访问次数减少了
倍 - 证明了可以分块计算归一化常数,这个方法可以发挥 GPU 多线程的特性。
在 Tesla V100 上的基准测试显示,当向量大小 V ≥ 1000 时,性能提升为 1.15 倍,而在大批次模式下,当 V ≥ 4000 时,性能提升可达 1.3 倍。
如果使用的是朴素 Softmax,那么切换到在线版本可以在不影响性能或仅产生可忽略性能影响的情况下提高数值精度。
当 TopK 操作跟随 Softmax 运行时,新的单次遍历归一化计算使得这两个函数的高效融合成为可能,从而使 Softmax+TopK 的内存访问次数减少 5 倍。我们在 Tesla V100 上观察到 1.5 倍至 5 倍的性能提升,其中 5 倍的提升来自 2.5 倍的函数融合和 2 倍的在线 Softmax 本身。
这些性能提升不仅适用于经典的 Softmax 函数;它们与许多其他 Softmax 优化技术是正交的,包括分层 Softmax、重要性采样和 SVD-Softmax。
在线 Softmax 在最新一代 GPU 上的运行速度比主流深度学习框架中使用的版本快 1.3 倍。它还使 Softmax 与 TopK 的高效融合成为可能,与传统的单独运行 Safe Softmax 和 TopK 相比,性能提升可达 5 倍。
后续讨论:
其他设备是不是可能会出现不同的情况,比如在 cpu 上可能出现速度下降,作者没有在 cpu 和其他设终端上做实验,但其实只要原始代码进行了向量化,并且能够保持在线归一化(和部分 TopK)计算的向量化,那么就可能会获得类似的加速效果。
还有可能进一步提高性能。当前的 Softmax 和 Softmax+TopK 融合仍然受限于内存带宽,因此如果将它们与前一层继续融合可以避免内存往返,从而提高性能。但是,这种改进方法很难实现,比前者更具挑战性。