 SUN
在智能体(Agent)架构中,规划器(Planner)、感知器(Perceiver/Sensor) 和 执行器(Executor/Actuator) 是三个核心组件,它们对应了思考-感知-行动的流程。可以把它类比成一个人:
- 感知器 就像眼睛、耳朵、触觉,负责接收外界信息
- 规划器 就像大脑里的计划模块,决定下一步该做什么
- 执行器 就像手、脚、嘴巴,把计划落实为实际动作
1. 感知器(Perceiver / Sensor)
功能
- 接收来自环境、用户或其他系统的输入
- 对原始数据进行解析、清洗、结构化
- 在 LLM Agent 中,感知器可以是:
- API 调用结果解析器
- 网页爬取模块
- 摄像头、传感器接口
- 用户输入解析(自然语言 → 结构化信息)
例子
在论文搜索 Agent 中,感知器会把用户输入的
"帮我找deepmd的论文"转换成{"task": "search", "keyword": "deepmd"}这样的结构化指令。
2. 规划器(Planner)
功能
-
基于感知器提供的信息 + 任务目标,制定执行计划
-
可以是一口气生成完整计划(Plan-and-Execute),也可以是逐步生成(ReAct、Tree of Thoughts)
-
在 LLM Agent 中,规划器通常会:
- 选择要调用的工具(Tool Selection)
- 决定调用顺序(Action Ordering)
- 判断中途是否需要调整计划(Replanning)
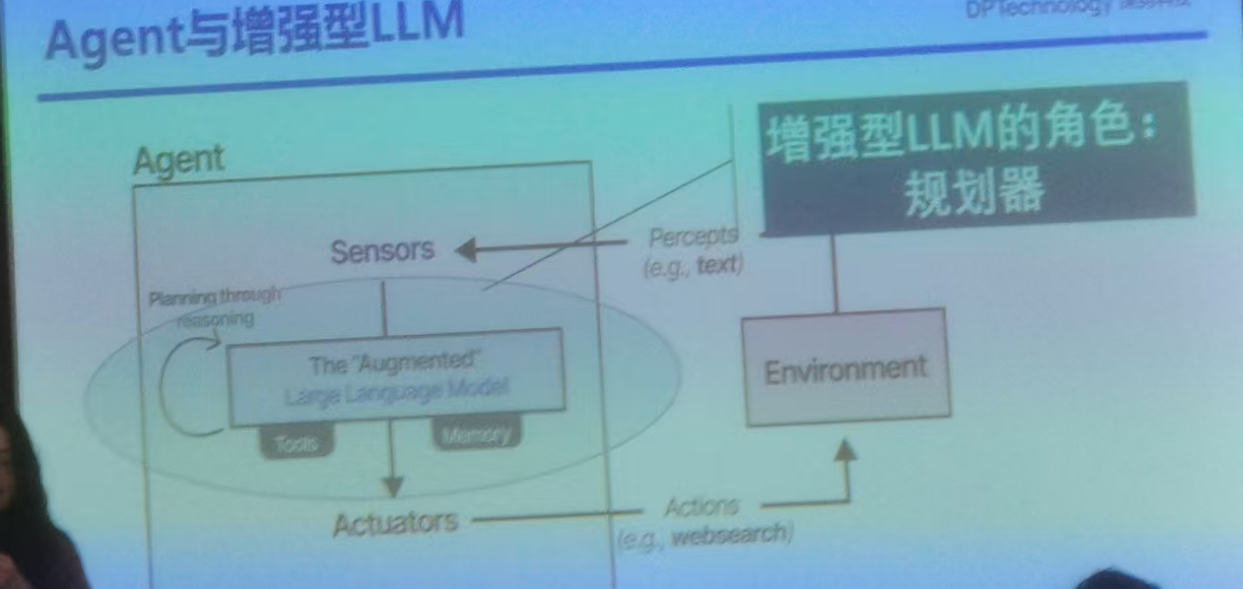
例子
对
"帮我找deepmd的论文",规划器可能会生成:
- 调用论文搜索 API
- 过滤年份 > 2020 的结果
- 输出标题 + 链接给用户
3. 执行器(Executor / Actuator)
功能
- 按照规划器的指令,调用具体的工具、API、函数,执行任务
- 返回执行结果给规划器(可能进入下一轮循环)
- 可以包含错误处理、重试逻辑
例子
规划器让执行器调用
arxiv.search(keyword="deepmd")执行器实际发起 API 请求,并返回结果列表。
三者协作流程(循环)
感知器 → 规划器 → 执行器 →(新的信息)→ 感知器 → …
比如在论文搜索 Agent 中:
- 感知器:接收
"帮我找deepmd的论文" - 规划器:制定调用
arxivAPI 的计划 - 执行器:实际调用 API,得到结果
- 感知器:解析 API 返回的 JSON
- 规划器:判断是否需要筛选/翻译/总结
- 执行器:输出最终结果给用户
ReAct(Reason + Act)
核心思想 ReAct(Reason+Act)是让 LLM 在推理过程中交替进行推理(Reasoning)和行动(Acting),这样模型既能分析问题,又能主动调用外部工具或环境获取信息。
先思考需要哪些信息,接下来要怎么做;;
当思考完毕后调用工具
流程特点
- Reasoning(推理) 模型先生成思考步骤(类似人类在纸上写的草稿)。
- Acting(行动) 模型根据推理结果,调用工具(比如搜索引擎、计算器、API)获取新信息。
- 交替循环 工具返回结果 → 模型继续推理 → 再决定是否执行下一步行动 → 直到得出最终答案。
优点
- 即时调整:每次获取新信息后,推理过程可以修正方向。
- 高灵活性:适合需要多步外部查询的任务(如推理+搜索)。
缺点
- 效率不高:每一步推理+行动都要等 LLM 输出,调用次数多时速度慢。
- 可能啰嗦:如果问题可以一步解决,也可能被拆成很多小步骤。
简单例子
问:法国总统的妻子叫什么?
- Reason:法国总统是谁?
- Act:搜索法国总统 → 返回“埃马纽埃尔·马克龙”
- Reason:马克龙的妻子是谁?
- Act:搜索马克龙的妻子 → 返回“布丽吉特·马克龙”
- Final Answer:布丽吉特·马克龙
Plan-and-Execute
核心思想 先让 LLM 一次性生成完整计划(Plan),然后按计划逐步执行(Execute)。 这样模型不需要在执行过程中不断思考下一步,而是先“画好地图”,再“按图行事”。
流程特点
- Planning(规划阶段) 模型通览任务,设计出一系列有序步骤。
- Execution(执行阶段) 严格按计划逐步调用工具或子任务。 计划和执行通常是分开的,甚至可能由两个不同的 Agent 来做(一个负责计划,一个负责执行)。
优点
- 执行效率高:不需要每一步都让模型重新思考流程。
- 更可控:有了完整计划,可以方便人工审核或修改。
缺点
- 不够灵活:如果执行中遇到意外情况,可能需要重新规划。
- 依赖计划质量:如果计划一开始有错误,后面执行也会跟着出错。
简单例子
问:帮我写一篇关于可持续能源的简报
- Plan:
- 搜集全球可持续能源数据
- 整理主要趋势
- 总结政策建议
- 撰写简报
- Execute:依次完成每一步,最终输出简报。
对比总结
| 特性 | ReAct | Plan-and-Execute |
|---|---|---|
| 推理方式 | 推理与行动交替 | 先整体规划,再执行 |
| 灵活性 | 高(每步可调整) | 中等(需要重规划才调整) |
| 效率 | 可能慢(多次调用模型) | 较快(少次调用模型) |
| 适用场景 | 需要探索、逐步搜索的信息获取任务 | 目标明确、步骤固定的任务 |
| 风险 | 容易啰嗦,成本高 | 计划出错影响全局 |
Tree of Thoughts(ToT)
**Tree of Thoughts (ToT)**其实是对 LLM 推理的一种结构化升级版本,可以看作是 “链式思维(Chain of Thought, CoT)” 的进化版。
背景
- Chain of Thought (CoT):让模型一步步推理,每次生成一个推理链(线性过程)。
- 问题:CoT 是“一条路走到底”,如果中途的推理方向错误,就很难回头尝试别的路径。
- Tree of Thoughts (ToT):在推理过程中不仅考虑当前一步,还会同时探索多个可能的推理分支,像在搜索树中寻找最佳路径。
核心思想
ToT 把 LLM 的推理过程转化为 搜索问题:
- 状态 (State):当前的推理上下文(到目前为止生成的部分答案/思路)。
- 动作 (Action):在当前状态下,模型可以提出下一步推理的多种可能分支。
- 评估 (Evaluation):模型对每个分支的潜力打分(可用自己或外部函数评估)。
- 搜索策略 (Search Strategy):通过 BFS、DFS、启发式搜索等方法,在推理树中寻找最优路径。
流程举例
假设任务是“解一道逻辑推理题”:
- 生成分支
- 状态 S0(题目本身)
- 模型提出 3 个可能的推理方向 → S1a, S1b, S1c
- 评估分支
- 给每个分支一个“可行性分数”
- 选出分数高的几个继续扩展
- 继续生成
- 从 S1a 再生成 2 个可能推理 → S2a1, S2a2
- 从 S1b 生成 1 个可能推理 → S2b1
- 搜索最优解路径
- 根据分数找到最终最优的推理链,输出答案。
优势
- 探索性强:同时保留多条思路,不会被一次错误锁死。
- 更接近人类思维:人类也会同时考虑多个假设,然后淘汰错误的。
- 灵活可调:可用不同搜索策略(BFS 保证全局,DFS 节省资源)。
缺点
- 计算成本高:需要生成、评估多个分支。
- 评估依赖模型能力:如果模型评估不准,可能浪费在错误分支上。
类比
- CoT:像走迷宫时只选一条路,走到死胡同才发现走错了。
- ToT:像在地图上同时标出几条可能路线,不断试探和修剪,最后走最优路线。
总结对比
| 特性 | CoT | ToT |
|---|---|---|
| 推理结构 | 单链 | 树形 |
| 错误恢复 | 差(要重来) | 好(可以回溯) |
| 计算开销 | 低 | 高 |
| 成功率 | 中等 | 高(尤其在复杂任务) |
提示工程的基本原则
-
从简单开始
-
指令清晰
-
限制长度
-
分解
-
避免“不做”
-
不断迭代
-
使用XML标签
渐进式模型选型策略
- 初期采用