 SUN
讯飞星辰 MaaS 精调平台是一个全链路的大模型精调解决方案,支持快速定制专属大模型。本指南将详细介绍如何使用该平台完成大模型精调。
平台概览
平台功能
讯飞星辰 MaaS 精调平台提供以下核心功能:
| 功能模块 | 说明 |
|---|---|
| 数据管理 | 支持预置数据集、数据上传、数据增强、问答对抽取、Prompt工程 |
| 模型精调 | 支持多种大模型基座、LoRA 和全量微调方式 |
| 训练监控 | loss 曲线可视化、训练指标实时显示 |
| 效果评估 | 自动化评估、人工评估、批量推理 |
| 模型部署 | API/SDK 发布、在线体验、版本管理 |
平台特点
- 全链路支持:从数据构建到模型部署的完整流程
- 人机协作工具:通过自动化工具提升数据构建效率
- 无代码体验:无需编写代码即可完成模型定制
- 灵活的部署:支持 API、SDK、开源模型下载等多种部署方式
平台工作流程

使用流程
流程概览
准备数据 → 构建数据集 → 选择模型 → 配置参数 → 开始训练 → 评估效果 → 发布服务 → 在线体验
第一步:数据准备与构建
方法 1:使用预置数据集
 预置数据集 |
 问答对抽取 |
|---|
平台提供多个行业领域的预置数据集,可以直接用于模型精调。
预置数据集特性:
- 涵盖多个行业领域
- 已经过验证和标注
- 无法修改(用户无法定制)
如何使用:
- 进入"数据集管理"页面
- 选择"预置数据集"标签
- 选择合适的数据集(如 sentiment_predict)
- 确定选择后即可用于后续训练
适用场景:
- 快速体验或验证
- 通用任务需求
- 缺少特定领域数据
方法 2:上传自定义数据集
如果平台提供的预置数据集不满足需求,可以上传自己的数据。
支持格式:
- JSON
- JSONL
- CSV
上传步骤:
- 进入"数据集管理"
- 点击"创建数据集"
- 选择数据文件
- 确认上传
数据格式标准:
标准的 Alpaca 格式数据结构:
{
    "instruction": "任务指令",
    "input": "输入内容",
    "output": "输出内容",
    "system": "系统提示(可选)",
    "history": "对话历史(可选,用于多轮对话)"
}
具体示例(情感分析任务):
{
    "prompt": "你是一个情感分析助手,目标是辨别推文的情感倾向,情感倾向分为积极和消极。接下来,我会给你推文的内容,请你告诉我情感分析的答案",
    "text": "一百多和三十的也看不出什么区别,包装精美,质量应该不错",
    "label": "积极"
}
数据辅助工具
工具 1:问答对抽取
用途:自动从文本数据中抽取问答对。
使用场景:
- 只有文本数据,缺少问答对
- 需要快速批量处理文本


如何使用:
- 进入"问答对抽取"功能
- 选择输入方式:
- 上传 txt 等格式的文本文件
- 或输入网站链接
- 设置分隔符(可自定义)
- 点击提交任务
性能指标:
- 正确率:≥ 90%
- 覆盖率:≥ 75%
- 自动生成的数据集可直接用于精调


输出:
- 生成标准格式的 Q&A 对数据集
- 支持下载用于微调
工具 2:数据增强
用途:当原有数据量过少时,通过数据增强扩展数据集。
增强方式:
- 文本生成任务增强
- 文本理解任务增强
- 知识问答任务增强


如何使用:
批量增强方式:
- 进入"数据增强"
- 点击"创建任务"
- 选择要增强的数据集
- 设置增强倍数(如2倍、3倍数据)
- 选择增强质量等级
- 提交任务
在线增强方式:
- 选择"在线增强"
- 输入单条数据
- 实时查看增强效果
- 调整后保存
在线优化方式:
- 选择"在线优化"
- 输入单条数据
- 优化数据质量
- 查看优化后的结果
工具 3:Prompt 工程
用途:使用优化的 prompt 模板来构建或优化数据集。
特点:
- 提供 50+ 常见 prompt 模板
- 覆盖多种任务类型
- 辅助数据集构建


如何使用:
- 进入"Prompt 工程"
- 选择适合的 prompt 模板
- 根据自己的任务进行修改
- 将数据按照 prompt 要求组织
模板分类:
- 分类任务
- 生成任务
- 问答任务
- 对话任务
- 等等
数据处理示例:
将原始数据映射到标准格式:
prompt→instructiontext→inputlabel→output
最终完整数据格式:
{
    "instruction": "你是一个情感分析助手,目标是辨别推文的情感倾向...",
    "input": "一百多和三十的也看不出什么区别,包装精美,质量应该不错",
    "output": "积极"
}
第二步:模型精调
2.1 模型选择与创建
首先需要选择一个合适的的基础模型:

在数据准备好之后,你需要选择一个合适的预训练模型进行精调。不同的任务可能需要不同的模型,你需要根据具体情况来选择。
按复杂度选择:
-
轻量级模型(如 Spark Mini、Spark Mini Instruct)
- 资源消耗:少
- 训练速度:快
- 适用任务:简单的文本生成、对话、内容创作
-
中等复杂任务(如 Spark Lite、Spark Lite Instruct)
- 资源消耗:中等
- 训练速度:中等
- 适用任务:知识问答、情感分析、一般应用
-
相对复杂任务(如 Spark Max)
- 资源消耗:多
- 训练速度:较慢
- 适用任务:工业自动化、智能控制、高精度任务
| 模型类型 | 模型名称 | 适用场景 |
|---|---|---|
| 文本对话模型 | Spark 系列 | 对话、文本生成 |
| 文生图大模型 | 图像生成系列 | 文本到图像生成 |
| 图像分类模型 | 分类系列 | 图像分类任务 |
| 文本分类模型 | 分类系列 | 文本分类任务 |
| 开源模型 | Llama、Mistral 等 | 自定义任务 |
2.2 创建精调任务
步骤:
- 进入"模型精调"页面
- 点击"创建模型"
- 填写模型信息

1. 创建模型

2. 填写模型信息
填写如下信息:
- 模型名称:为微调模型起一个有意义的名称
- 模型选择:选择基座大模型
- 任务类型:明确任务类型
- 数据集选择:选择之前上传或预置的数据集
2.3 数据配置

Alpaca 格式字段映射:
平台中的 Alpaca 格式包含以下字段:
| 字段名 | 说明 |
|---|---|
| instruction | 将与 input 内容拼接,形成模型的输入指令。最终的模型输入指令格式为 instruction\input |
| input | 具体的输入内容 |
| output | 包含模型的期望输出,是训练过程中模型要生成的回答 |
| system | (可选)如果勾选相关选项,此列的内容将作为系统提示词提供给模型 |
| history | (可选)包含多个字符串二元组,代表对话历史中的指令与回答 |
映射示例(商品评论情感分类):
| 字段 | 映射关系 | 内容示例 |
|---|---|---|
| prompt | → instruction | 情感分析任务说明 |
| text | → input | 商品评论文本 |
| label | → output | 积极/消极 |
配置步骤:
- 进入"数据配置"页面
- 明确各个数据字段之间的对应关系
- 验证映射的准确性
- 确认无误后保存
2.4 参数配置

3. 点击提交

4. 完成精调

5. Loss 曲线
可以通过调整以下参数来控制模型训练效果。初次使用可采用平台默认参数。
| 参数名称 | 说明 | 建议范围 |
|---|---|---|
| 学习率 | 模型训练过程中权重更新的步长大小。较小的学习率通常更稳定,但需要更多迭代次数 | 1e-5 ~ 1e-3 |
| 训练次数 | 模型在整个训练数据集上的迭代次数。越多学习越充分,但容易过拟合 | 2 ~ 10 |
| 输入序列最大长度 | 输入序列在分词后允许的最大长度。超过此长度的文本会被截断 | 512 ~ 4096 |
| 数值精度 | 计算中使用的数据类型,如 float32、float16、auto(自动选择) | 通常选择 auto |
| LoRA 作用模块 | 选择模型的全部或特定模块层进行微调 | 根据任务选择 |
| LoRA 秩 | 决定了微调中引入的低秩矩阵的复杂度 | 8 ~ 64 |
| LoRA 随机丢弃 | 防止过拟合的 Dropout 比例(如 0.01 = 1%) | 0.01 ~ 0.1 |
| LoRA 缩放系数 | 定义 LoRA 适应的学习率缩放因子 | 16 ~ 100 |
参数调优建议:
- 首次使用默认参数快速验证
- 根据 loss 曲线调整学习率
- 如果过拟合,增加 Dropout
- 如果欠拟合,增加训练次数或模型秩
2.5 提交训练
步骤:
- 检查所有配置无误
- 点击"提交"按钮
- 进入训练队列
注意事项:
- 平台可能需要排队,大家不用担心,都可以排上队
- 越早提交,越容易排上队
- 避免长时间排队:可以选择其他规模的模型尝试
- 数据集越大,任务所需时间也会越长
2.6 训练监控
训练过程中可以实时监控进度:
- 任务状态:显示训练进度
- Loss 曲线:显示训练和验证 loss 的变化
- Loss 越来越低:说明训练有效
- Loss 曲线收敛:说明达到最优状态
- 训练指标:实时显示其他训练指标
Loss 曲线解读:
- 理想情况:Loss 稳定下降并趋于平稳
- 过拟合:验证 Loss 上升,训练 Loss 继续下降
- 欠拟合:两条曲线都下降缓慢
- 异常:Loss 波动过大或发散
完成信号:
- 任务状态变为"运行成功"
- Loss 曲线呈现收敛趋势
第三步:效果评估
精调完成后,需要对模型进行评估,以确定模型在特定任务上的表现:

3.1 发布为服务
首先在开放平台中创建应用(若已创建,则无需重复)。
发布步骤:

1. 点击创建应用

2. 填写相关信息

3. 发布为服务

4. 体验或继续优化
- 在模型管理中选择相应任务点击【发布为服务】
- 将其授权至所创建的应用完成发布
- 发布成功后可以点击【体验】,获得在线体验
- 也可以点击【新增版本】继续精调模型获得性能更佳的模型
注意事项:
- 精调后的模型需要再次【更新服务】选择最新版本才可体验最新效果
3.2 在线体验
在「体验中心」页面的「我的服务」将同步该模型能力。

1. 点击体验

2. 选择服务输入指令
3.3 批量推理
您可以在「批量推理」板块,创建或发起模型批量推理。
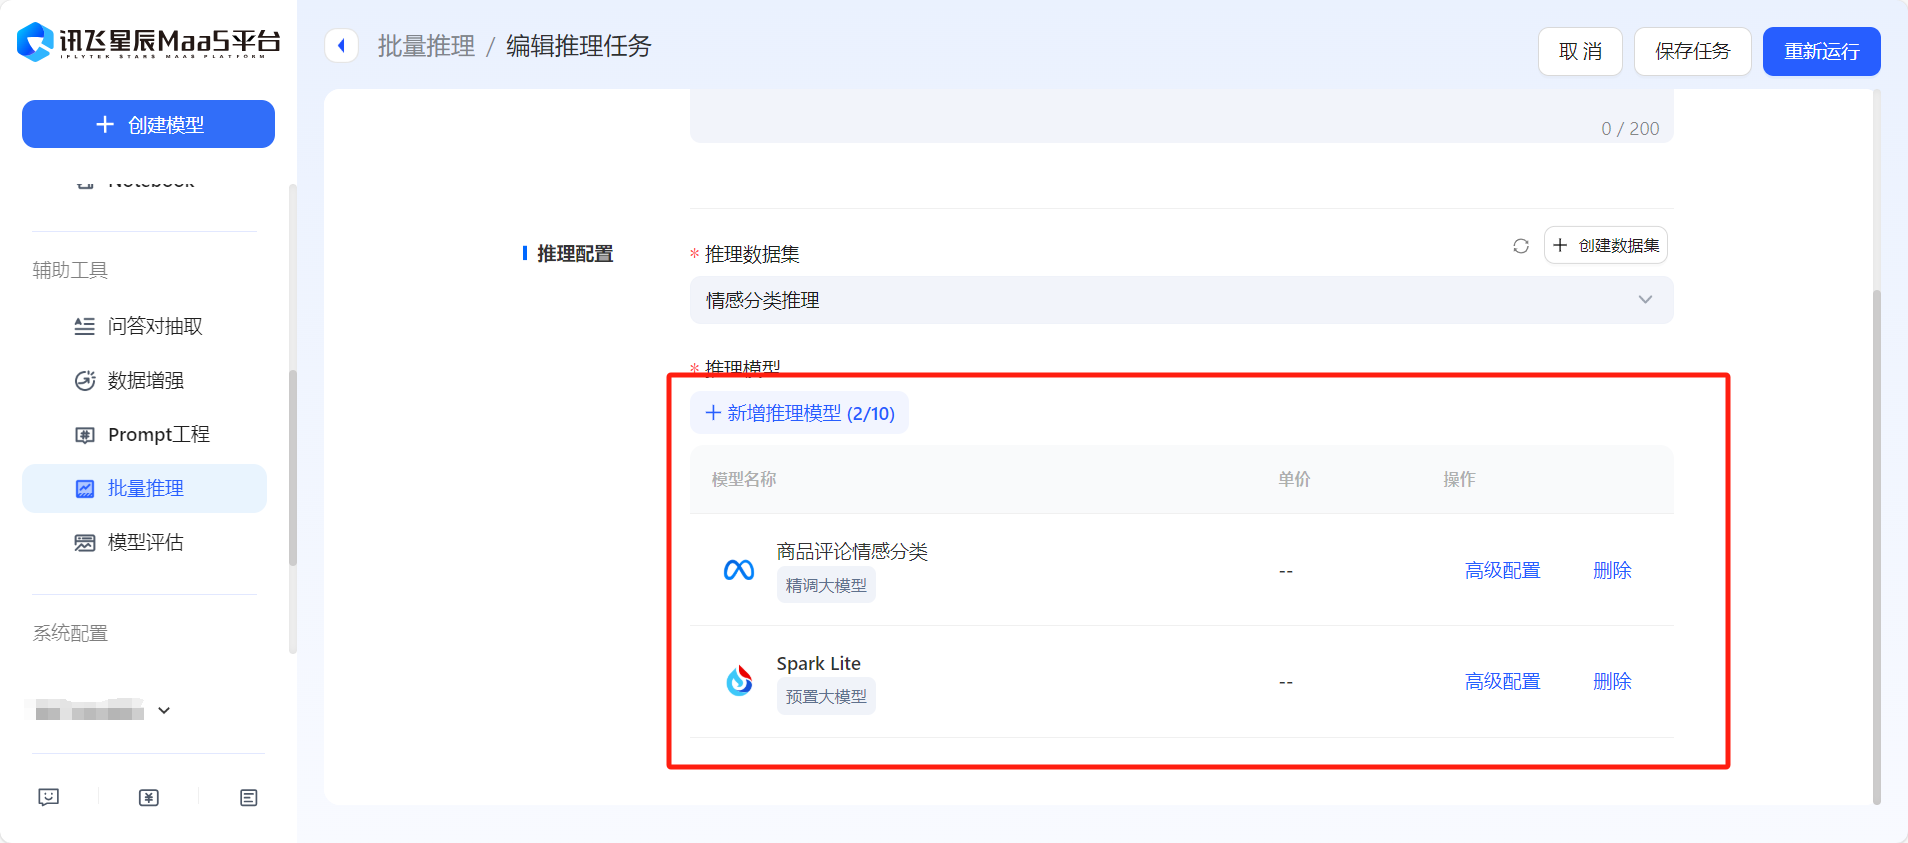
创建批推理任务
特点:
- 支持多个模型同时推理
- 可以对比精调前后的模型
- 自动生成结果对比
结果查看:

批推理任务状态

批推理结果
任务完成后,可以选择查看评估报告或导出评估结果,可以看到精调前后的模型性能差异。
3.4 模型评估
在【模型评估】板块,可以基于批量推理结果对模型的输出效果进行全方位评价。

1. 创建模型评估

2. 模型评估结果
评估方式:
- 相似度打分:基于与标准答案的相似度自动评分
- 裁判员打分:使用专家模型进行评估
如何进行评估:
- 进入"模型评估"页面
- 点击"创建模型评估"
- 选择评估方式:相似度打分 或 裁判员打分
- 选择要评估的批量推理结果
- 提交评估任务
评估指标:
- 相似度分数:0-100
- 匹配度评分:基于语义相似性
- 专业性评分:基于领域知识
结果解读:
- 查看评估分数的分布
- 识别高分和低分的样本
- 了解模型的强点和弱点
实战案例:商品评论情感分类
本案例展示如何在 15 分钟内使用平台快速定制一个专属的商品评论情感分类模型。
业务背景
电商平台中商品自动分类场景:
- 商品种类迅速增长
- 传统人工分类方法效率低、出错率高
- 需要根据商品标题和描述快速判断商品类别
- 提升管理效率,降低人工成本
第一步:注册讯飞星辰 MaaS 平台
进入官网注册账号:
- 支持手机号快捷登录
- 注册后即可开始使用

手机号快捷登录

官网页面
第二步:准备数据
下载数据集:
- 下载"商品分类.jsonl"数据文件
- 文件包含商品评论和对应的分类标签
数据格式:
{"prompt": "...", "text": "...", "label": "..."}
第三步:定制分类模型
讯飞星辰 MaaS 平台免费提供大模型定制功能。按照以下步骤操作:
步骤流程图示:
| 步骤 | 操作 | 说明 |
|---|---|---|
| 1 |  点击【创建模型】 |
进入模型创建流程 |
| 2 | 填写模型名称、选择 Spark Lite 模型(速度快) | |
| 3 |  点击【创建数据集】 |
准备训练数据 |
| 4 |  配置数据集信息 |
选择数据格式、填写数据信息 |
| 5 |  导入商品分类数据集 |
上传之前下载的商品分类数据集 |
| 6 |  配置数据映射 |
将字段映射到 instruction、input、output |
| 7 |  提交任务 |
点击提交开始训练 |
| 8 |  看到这张图,就妥了 |
完成微调 |
详细配置:
基础信息:
- 模型名称:例如"商品评论分类模型 v1"
- 基座模型:选择 Spark Lite(更快)
- 任务类型:文本分类
数据映射:
- prompt → instruction
- text → input
- label → output
第四步:创建应用
在开放平台创建应用:

1. 点击【创建新应用】

2. 按需填写内容即可
- 进入控制台
- 点击"创建新应用"
- 填写应用信息
- 完成创建
应用用途:绑定微调的模型,用于发布服务
第五步:发布并体验

1. 看到这两个✅就说明任务已完成!完成微调大概需要10分钟,试着点击一下,还能看到任务细节哟~

2. 然后,发布服务!如果没有看到可选的应用的话,记得回去做Step4哟~

3. 点击【体验】(可能需要等一小会~多刷新)

4. 点击【选择模型】

5. 选择想对比的模型

6. 然后就可以对比微调效果了!
发布流程:
- 任务完成后(显示✅),选择"发布为服务"
- 选择之前创建的应用
- 点击发布
体验模型:
- 完成模型发布
- 进入"体验中心"
- 在"我的服务"中看到已发布的模型
- 点击"体验"进入测试界面
- 输入要测试的指令或问题
- 对比模型的回答
预期时间
- 模型微调:约 10-40 分钟(取决于数据量和队列)
- 发布服务:约 1-2 分钟
- 总耗时:约 15-50 分钟
常见问题
Q:一直排不上队怎么办? A:可以尝试以下方式:
- 耐心等待(平台会按顺序处理)
- 选择其他规模的模型尝试
- 使用较小的数据集快速验证流程
Q:需要修改微调效果: A:可以选择"新增版本"继续精调:
- 基于当前模型继续优化
- 迭代改进训练效果
- 完成后使用"更新服务"切换到最新版本
Q:模型性能检验: A:通过批量推理和评估功能:
- 使用测试数据进行批量推理
- 对比精调前后的效果
- 通过相似度打分或专家评估获得客观数据
进阶应用:法律咨询大模型
业务背景
随着民众法治意识增强,法律咨询需求激增。法律咨询机构与线上平台不断涌现,却面临:
- 人工解答效率低
- 通用大模型专业性不足

这些法律咨询服务提供方急需:
- 高效应对大量法律咨询
- 提供专业准确的回答
- 提升服务质量
解决方案
第一步:准备法律领域数据
{
    "prompt": "假设你是一位法律专家,熟知所有法律知识,能够以专业的角度解答所有的法律咨询",
    "input": "我自己的公司我是法人没有股东挪用公司的钱会触犯法律吗",
    "output": "成立公司以后,个人的钱与公司的钱是独立的。即使公司只有一个股东,如果此股东将钱占有已有,则为职务侵占罪,如果是挪用后从事经营活动,超过3个月以上的,属于挪用资金罪。简单举例,公司经营困难,负债累累,但是不会要求股东个人偿债。同样,公司盈利后,股东可分红,不能任意挪用。否则会造成公司人格混同。"
}
第二步:选择合适的基座模型
- 选择中等或较大规模的模型
- 原因:法律知识复杂,需要更强的理解能力
第三步:采用相应的微调方式
- 可考虑全量微调获得最佳效果
- 适当增加训练轮次
第四步:发布并部署
- 发布为 API 服务供法律咨询平台调用
- 或下载 SDK 进行本地部署
最佳实践总结
数据相关
- 质量第一:确保数据标注准确性,这是成功的基石
- 多样性:包含不同场景、风格、难度的样本
- 适量规模:LoRA 500-5000 样本,全量微调 5000-50000 样本
- 定期检查:在数据增强或处理中定期检查质量
模型选择
- 根据任务选择:简单任务选轻量级,复杂任务选大模型
- 资源匹配:根据可用资源选择合适的模型
- 快速验证:先用小模型快速验证思路,再选大模型
训练过程
- 监控 Loss:随时观察 loss 曲线,及时调整超参数
- 避免过拟合:验证集性能停止改进时考虑停止
- 参数调优:逐步调整学习率和其他参数
评估与部署
- 全面评估:不仅看准确率,还要看业务实际效果
- A/B 对比:在生产环境中对比精调前后的效果
- 版本管理:保留不同版本,支持快速回滚
联系与支持
- 平台官网:https://training.xfyun.cn/modelSquare
- 开放平台:https://console.xfyun.cn/
- 文档中心:查看详细的数据集格式说明和 API 文档
- 社区交流:与其他开发者分享经验和最佳实践
通过讯飞星辰 MaaS 平台,你可以快速、轻松地定制属于自己的专属大模型,加速 AI 在各个领域的应用落地!